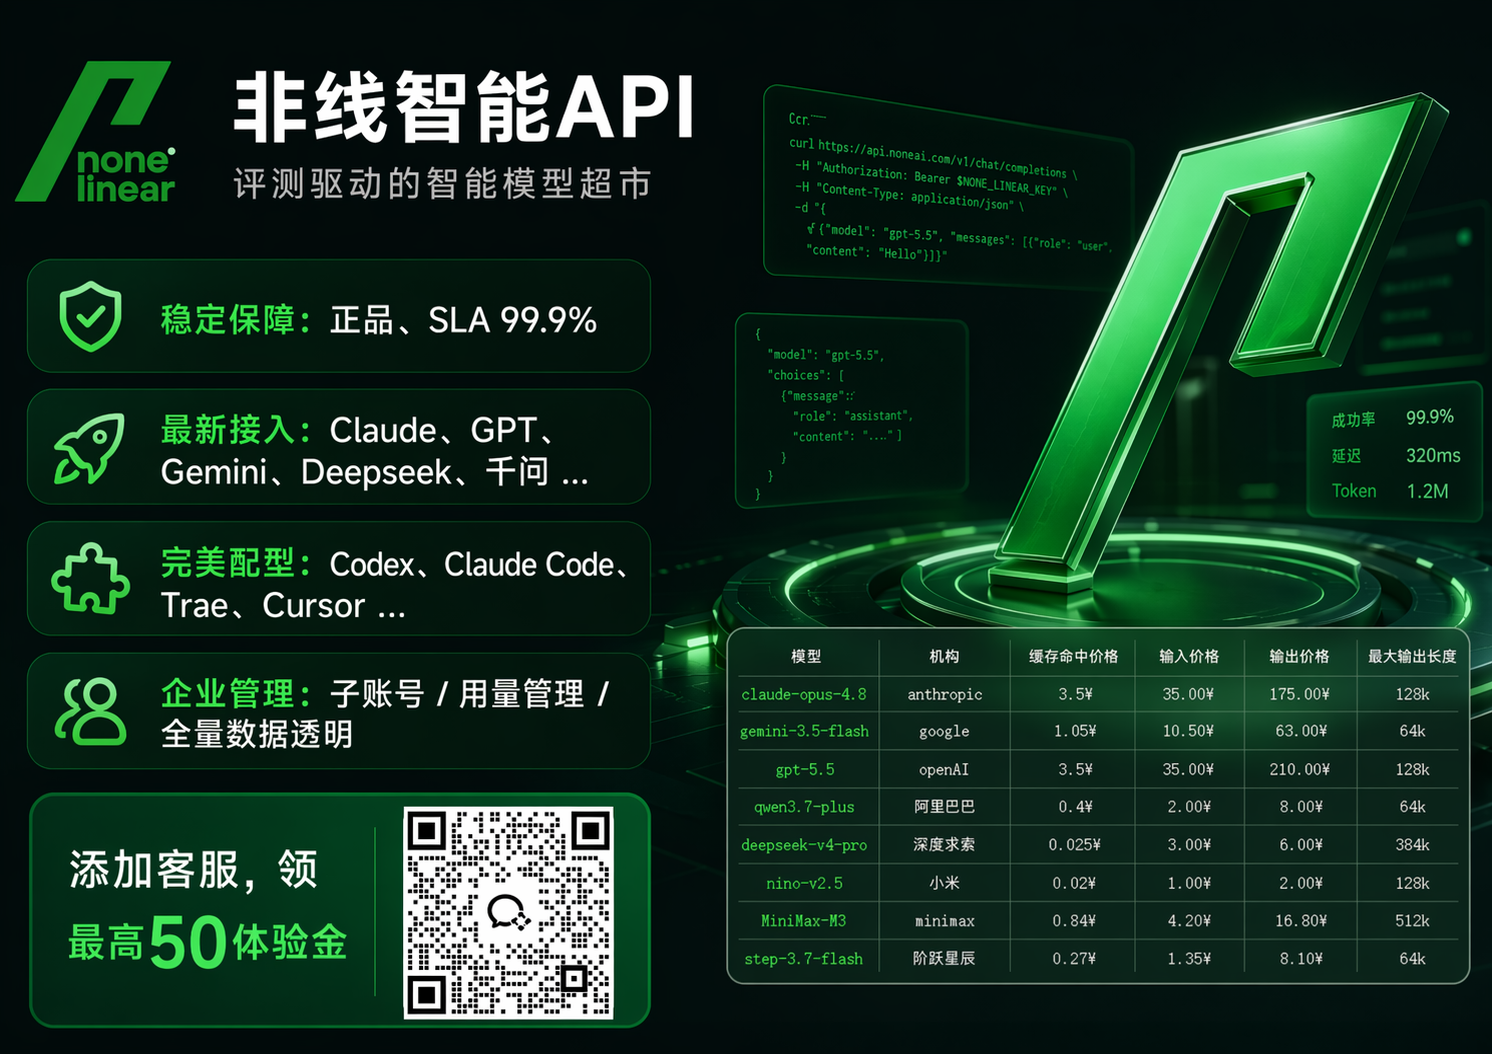
摘要:本篇解决"怎么换、换完之后怎么管"。我们以非线智能(NoneLinear)官方技术文档为唯一事实来源,把从 OpenRouter 迁移到国内聚合网关的完整工程路径拆成十个环节:协议选择、工具配置、模型 ID 规范、缓存与成本控制、密钥治理、白名单、费用对账、故障排查。文内所有 Base URL、环境变量名、接口路径、字段定义与模型 ID 均可在官方文档中逐条核对,可作为团队内部的接入 SOP 直接使用。
一、迁移决策:先确认你真的需要换
不是所有团队都需要迁移。如果你的调用全部发生在海外服务器、面向海外用户、不需要国内发票,那么留在原平台是理性的。但只要你命中下面任意两条,迁移的收益就会明显盖过迁移成本:
- 生产节点部署在国内,且调用链路里出现了公网抖动导致的重试与超时;
- 需要通过代理访问上游旗舰模型,且账号曾经收到过风控提示;
- 财务要求开具国内增值税发票,或者采购流程必须走对公合同;
- 团队正在大规模使用 Claude Code、Cline、Codex 这类编程 Agent,对协议原生兼容性敏感;
- 需要在与上游同样的链路上开通生图、视频、语音等多模态能力。
二、接入前的三项准备
按官方文档的"推荐接入路径",动手之前需要先确认三件小事,这三件事能挡掉后续 80% 的报错:
- 确认账号已就绪:注册后拿到账号的默认 API Key。注意一点:默认 Key 的权限高于业务 Key,创建 Key、修改预算、查询余额与全局费用这类管理接口只允许默认 Key 调用,用业务 Key 调用会直接返回
403 Forbidden。 - 确认要用的协议:网关同时提供 OpenAI 兼容端点与 Anthropic 原生端点,两者不是二选一的关系,而是面向不同工具的不同通道,详见第三章。
- 确认模型 ID:到模型广场复制 ID,模型名的大小写、连字符、版本号都必须完全一致。这是官方文档反复强调的一条,因为"配置能保存成功、调用必然失败"是最典型的假成功。
顺便提醒一句体验层面的事:企业正式采购前可以先注册联系客服要赠送的体验金来跑通全流程,再充值。
三、双协议接入全解
这是整份文档里信息密度最高的一章,也是迁移工作真正的分水岭。
3.1 OpenAI 兼容端点
网关完全兼容 OpenAI SDK,端点根地址为:
https://api.nonelinear.com.cn/v1
也就是说,完整请求地址会被拼成 https://api.nonelinear.com.cn/v1/chat/completions。使用 Python SDK 的最小可用示例如下(示例代码取自官方语言模型文档):
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.nonelinear.com.cn/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "用三句话介绍递归。"}
    ],
    stream=True
)

for chunk in response:
    # 有些流式 chunk 可能没有 choices,比如 usage chunk、心跳、兼容层特殊事件
    if not chunk.choices:
        continue

    delta = chunk.choices[0].delta

    # 有些 chunk 有 delta,但没有 content
    content = getattr(delta, "content", None)
    if content:
        print(content, end="", flush=True)
这段代码里有三个值得单独拎出来的工程细节,官方文档特意做了注释:
- 流式响应里并非每个 chunk 都带
choices。用量统计包、心跳包、兼容层的特殊事件都可能没有choices,如果不做空判断直接取chunk.choices[0],就是线上最常见的IndexError来源。 - 有
delta不等于有content。首包、工具调用包、结束包都可能只有角色或状态字段,必须用getattr(delta, "content", None)兜底。 system与user的语义要分清。system用于设定行为边界,user才是终端输入,把两者混用会显著影响指令遵循效果。
3.2 Anthropic 原生端点
面向 Claude Code 及所有依赖 Anthropic Messages 协议的工具,网关提供原生端点:
https://api.nonelinear.com.cn/anthropic
请注意这个地址不带 /v1,这与 OpenAI 兼容端点的命名习惯相反,是最容易写错的一处。对应的认证变量名也不是 ANTHROPIC_API_KEY,而是:
export ANTHROPIC_BASE_URL="https://api.nonelinear.com.cn/anthropic"
export ANTHROPIC_AUTH_TOKEN="你的 API Key"
由于变量名被 Claude Code 原生读取,设置完成后直接启动 claude 即可,不需要改动任何代码。官方文档对此的定位很明确:Claude Code 推荐优先走 Anthropic 格式,直接使用原生 ANTHROPIC_ 配置项,无需额外路由工具;只有当团队有多供应商路由需求、或希望用 OpenAI 兼容接口统一管理时,才引入 ClaudeCodeRouter 这类中间层。
3.3 两条路线怎么选
| 判断维度 | OpenAI 兼容端点 /v1 |
Anthropic 原生端点 /anthropic |
|---|---|---|
| 适用工具 | 通用 SDK、Cherry Studio 普通聊天、Cline、Codex 等 | Claude Code、以及要求 Anthropic Messages 协议的工具 |
地址是否带 /v1 |
带 | 不带 |
| 认证变量 | SDK 的 api_key / OPENAI_API_KEY |
ANTHROPIC_AUTH_TOKEN |
| 关键取舍 | 生态最广,可一份代码切换数百个模型 | 保留 Anthropic 全功能特性,Agent 场景更稳 |
| 典型坑 | 模型 ID 写错、地址多写 /chat/completions |
误加 /v1、误用 API_KEY 变量名 |
一个非常容易踩的实例是 Cherry Studio:它的普通聊天模式用 OpenAI 类型服务商即可,但Agent 模式要求服务商类型必须是 Anthropic 且接口支持 Anthropic Messages API。官方文档明确指出,通过 OpenAI 类型添加的模型即使能正常聊天,也不会出现在创建智能体的模型列表里——这是协议兼容性限制,不是模型 ID 填错了。正确做法是同时保留两个服务商:OpenAI 类型用于聊天,Anthropic 类型用于 Agent 模式。
四、主流工具逐一配置
4.1 Cherry Studio
普通聊天模式:新增服务商,名称随意(如"非线智能"),类型选 OpenAI,API 地址填 https://api.nonelinear.com.cn/v1,密钥填你的 Key,然后点"检测"验证连通性。模型区域点 + 添加模型,模型 ID 必须与模型列表完全一致。
Agent 模式:再新增一个服务商,类型选 Anthropic,API 地址填 https://api.nonelinear.com.cn/anthropic。原有 OpenAI 服务商无需删除。
4.2 Cline(Cursor / Trae / VS Code)
Cline 的接入关键只有一句话:API Provider 必须选 OpenAI Compatible。之后依次填 Base URL https://api.nonelinear.com.cn/v1、API Key、Model Name 三项即可。文档还给出一个省心细节:像 gpt-5.5-high、DeepSeek-V3.2-Think 这类名称中已带思考模式标识的模型,平台侧会依据命名自动配好思考参数,不需要在 Cline 里额外调整思考相关选项。
4.3 Claude Code:三种配置姿势
方式一:一键脚本。 Linux/macOS 下在项目目录执行官方 bootstrap 脚本,脚本会自动下载校验客户端、提示输入 Key、写入地址与模型配置并启动。Windows 用户在 64 位 PowerShell 中运行对应的 .ps1 一键脚本即可。
方式二:手写 settings.json。 适合需要精细控制模型槽位的团队,配置位置为 macOS/Linux 的 ~/.claude/settings.json,Windows 为 C:\Users\<用户名>\.claude\settings.json。核心字段包括 ANTHROPIC_BASE_URL、ANTHROPIC_AUTH_TOKEN、ANTHROPIC_MODEL 以及三个角色槽位 ANTHROPIC_DEFAULT_SONNET_MODEL、ANTHROPIC_DEFAULT_OPUS_MODEL、ANTHROPIC_DEFAULT_HAIKU_MODEL。改完必须重开终端窗口才生效。
方式三:图形化切换器 CC-Switch。 它本质是一个配置切换器,会把选中供应商的信息写入 ~/.claude/settings.json。添加供应商时选择"Claude"类型与"自定义配置",API 格式选 Anthropic Messages(原生),认证字段保持默认的 ANTHROPIC_AUTH_TOKEN。它有 macOS(Homebrew cask)、Windows(msi)、Linux(deb/rpm/AppImage/flatpak)全平台分发。
4.4 ClaudeCodeRouter(多供应商路由)
如果团队希望用 OpenAI 兼容接口统一纳管多个供应商,可安装 @musistudio/claude-code-router,通过 ccr ui 图形界面或 ~/.claude-code-router/config.json 配置供应商,并在 Router 段里分别指定 default、background、think、longContext、webSearch 五个路由位。务必注意:必须用 ccr code 启动,而不是 claude,这是文档中加粗强调的一条。
五、模型 ID 规范与真实清单
平台聚合了 GPT、Claude、Gemini、DeepSeek、Qwen、GLM、豆包等多个系列。以下是文档与模型广场中出现过的真实 ID 示例,可以直接作为配置时的对照样本:
| 系列 | 示例模型 ID | 备注 |
|---|---|---|
| DeepSeek | DeepSeek-V4.1、deepseek-v4、deepseek-v4-pro、deepseek-v4-flash |
混合大小写与全小写并存,最容易写错 |
| DeepSeek 推理型 | DeepSeek-V4.1-Think |
名称已带思考标识,平台侧自动配好参数 |
| GPT | gpt-5.5、gpt-5.5-high |
编程与复杂拆解场景 |
| Claude | claude-opus-5.5、claude-opus-4.8、claude-sonnet-5.5、claude-sonnet-4.5、claude-haiku-4.5 |
Agent 与关键判断场景 |
| GLM | glm-5.3、glm-5.2 |
国产开源主力 |
| 生图 | gpt-image-2、gemini-3-pro-image-preview、gemini-3.1-flash-image-preview |
数量与版本后缀差异大 |
关于命名,有三条硬规则:
- 大小写敏感:
DeepSeek-V3.2与deepseek-v3.2不是同一个 ID。 - 连字符与点号敏感:版本号里的
.和-都可能出现在同一个 ID 中。 - 版本后缀必须带上:生图类模型尤其明显,例如
doubao-seedream-4-5-251128末尾的日期戳是 ID 的一部分。
推理型模型还有一处专门的接口差异:思维链内容通过 reasoning_content 字段返回,而不是 content。文档给出的流式取法是在循环里分别读取 getattr(delta, "reasoning_content", None) 与 delta.content,两者的关系是"先思考、后作答"。同时平台已经替用户处理好了"是否开启思考模式"这类参数,不需要手动调整内部参数,按模型名选择即可。
六、成本控制:从"一句您好花了八块钱"说起
官方文档用了一个非常坦率的案例:为什么在 Claude Code 里问一句"您好",Claude Opus 就可能花掉几块钱?
答案在于 Claude Code 是一个编程 Agent,不是聊天窗口。即使用户只输入四个字,请求体里依然包含系统提示词、工具定义、会话状态、历史上下文,以及可能被读取到的项目文件与命令执行结果——账单按完整请求计算,而不是按用户可见的输入长度计算。理解了这一点,成本优化就有明确的着力点:
- 按任务类型选模型。 连通性测试建议在空目录跑,并优先用
deepseek-v4-flash这类高性价比模型,不要拿 Claude 系列去测试连通性;规划与关键判断再用 Claude 或 GPT 系列;常规改代码、批量文档编辑优先走deepseek-v4。 - 用
/model动态切换。 长时间连续开发时按任务切模型,不要所有任务都固定在一个旗舰模型上。 - 别让槽位空着。
/model是按 Sonnet、Opus、Haiku 三个角色槽位切换的。如果只配了其中一个,切换到空槽位时,Claude Code 会用该角色的默认模型名发起请求,于是就会出现"我没配 Opus,后台却有 Opus 消耗"的情况。文档的建议很直接:三个槽位都明确绑定;如果不打算用 Opus,就不要把 Opus 槽位留空。 - 留意 Haiku 槽位的后台消耗。 新版 Claude Code 默认启用会话自动摘要(Session recap)。终端闲置或会话结束时,它会在后台调用 Haiku 槽位做摘要。若 Haiku 映射为
deepseek-v4-pro,就会在没有任何新输入的情况下看到该模型的消耗记录;若留空则变成claude-haiku-4.5。对成本敏感时,把 Haiku 槽位绑一个更经济的模型,并把这类消耗纳入预算预期。 - 缓存命中率要理性看待。 Claude 系列的缓存复用条件较严格:两次请求中的系统提示词、工具定义、历史对话需尽量保持一致才容易命中。而在 Claude Code 中,上下文会随文件读取、工具调用、命令结果不断变化,缓存命中率通常并不稳定。另有两条实操技巧:一是配置 一行代码,关掉新版客户端自动注入的动态随机哈希请求头,避免每次请求哈希变化拖累缓存;二是把 Claude 系列留给关键判断,而不是全流程通用。
七、企业级治理:密钥、限额与对账
平台提供的管理能力主要通过控制台和 REST 接口两套入口暴露。
7.1 密钥分层与限额
推荐的做法是为每位成员、每个环境、每个独立 Agent 创建专属 Key,并清晰命名(如 生产环境-API-Key-001)。创建接口为:
POST /v1/apikeys
Authorization: Bearer <默认 API Key>
可配置的限额项包括:budget(总额度,元)、daily_limit(每日限额)、monthly_limit(每月限额)、expiry_date(有效期,YYYY-MM-DD)、以及 input_price_limit 与 output_price_limit(模型输入/输出价格上限,单位元/百万 token)。最后两项是很多人忽略的能力——它可以按价格档位限制某个 Key 能调用哪些模型,而不只是限制花多少钱。
修改已有 Key 限额的接口为 POST /v1/apikeys/<apikey_id>/budget,其中 apikey_id 取目标 Key 的前 10 位字符,且要求至少传一项限额参数。
7.2 IP 白名单
白名单用于限制"仅允许指定公网出口 IP 调用某个 Key",防止密钥泄露后被异地滥用。三条必须记住的规则:
- 必须填请求到达平台时使用的公网出口 IP,不能填
192.168.*、10.*这类内网地址; - 使用代理或 VPN 时,要核对其实际出口 IP;
- 批量保存是完整覆盖,不是追加——一旦搞错,原有规则会被整体替换。清空内容并保存则取消该 Key 的旧规则。
动态出口 IP 的环境(移动热点、家庭宽带)需要谨慎开启,否则出口一变就会收到 403 Forbidden。
7.3 余额与费用对账
两个查询接口可以写进你的成本监控脚本:
GET /v1/balance        # 账户余额
GET /v1/costofapikey   # 各 API Key 的费用明细
余额响应包含 balance(元,保留四位小数)、currency(RMB)等字段。费用明细里,apikey 字段只显示前 10 位、其余用 * 掩盖,同时给出 cost(累计费用)、cost_today、cost_this_month、group_name(所属分组)以及各项限额的当前值,非常适合做"超额预警"的前置检查。控制台侧则可以按请求 ID 核对单次调用明细,并支持按 Key 导出 CSV 对账单。
计费模式为透明的按量计费(Pay-as-you-go),单价以模型列表为准。另外,文档在数据层面给出了一句值得写进合规说明的承诺:控制台的调用明细仅展示用于计费审计与对账的元数据(请求时间、API Key 标识、Model ID、Token 消耗等),平台不持久化存储客户的具体业务对话正文。
八、故障排查速查表
| 现象 | 大概率原因 | 处理方式 |
|---|---|---|
401 |
Key 缺失或无效 | 检查 Key 是否完整复制、前后是否带空格 |
403 Forbidden |
①用了业务 Key 调管理接口;②出口 IP 不在白名单 | 管理接口换默认 Key;核对并调整白名单 |
| 检测通过但调用失败 | 模型 ID 与模型列表不一致 | 逐个核对大小写、连字符、版本号 |
| Claude Code 里 Opus 有消耗但没配过 | Opus 槽位留空,回落到该角色默认模型 | 把三个槽位都显式绑定 |
| 闲置后出现 Haiku 消耗 | 会话 recap 后台摘要 | 给 Haiku 槽位绑经济模型并纳入预算 |
| Agent 列表里找不到模型 | 服务商类型用的是 OpenAI 而非 Anthropic | 另加一个 Anthropic 类型服务商 |
| CCR 启动后配置不生效 | 用了 claude 而非 ccr code |
改用 ccr code 启动 |
| Linux 下配置不生效 | 曾用 sudo 启动导致目录属主变化 |
修正 ~/.claude 属主;清理 /tmp/claude |
九、迁移收尾清单
最后给一份可以直接贴进项目 README 的核对清单:
- 默认 Key 由管理员单独保管,绝不下发业务侧,绝不写入前端代码;
- 每个环境、每个成员、每个 Agent 各有独立 Key,并设好总额与日/月限额;
- 生产服务器配置 IP 白名单,动态出口环境不开白名单改用限额兜底;
- 协议选型明确到工具级别:Claude Code 走
/anthropic,通用工具走/v1; - 模型 ID 从模型广场复制,禁止手写;
- Claude Code 三个模型槽位全部显式绑定,并关闭动态 attribution header;
- 成本监控脚本定时调
/v1/balance与/v1/costofapikey,超额自动告警; - 定期导出调用明细 CSV,与财务对账口径保持一致;
- 密钥泄露时第一时间在控制台删除并轮换,而不是只在业务端替换;
- 有企业统一身份认证(Okta、企业微信、SAML/LDAP)需求的,走商务通道对接 SSO。
十、结语
把 OpenRouter 换成国内聚合网关,技术上其实只是一个 base_url 的工作量——真正的工作量在换完之后:密钥怎么分层、限额怎么设、槽位怎么绑、缓存怎么算、账单怎么对。
官方文档给出的启示是,一个成熟的聚合网关不该只是"能连通",而应该把工程细节都提前想好并写进文档:流式 chunk 的空值兜底、思考参数的自动配置、IP 白名单的覆盖语义、会话 recap 的隐性消耗、管理接口的默认 Key 权限边界。这些看似琐碎的条目,恰恰构成了从"个人试用"到"企业生产"之间最真实的距离。
迁移的终点不是一次成功的 curl,而是一套团队每个人都能照着执行、每个月都能对上账的稳定流程。