标题:AI中转与API中转站对比:API聚合平台非线智能API让Claude Code对接GLM更省心?
一、AI编程工具进入多模型混用阶段
在2026年的开发实践中,AI编程工具的形态发生了明显变化。Claude Code、Codex、Cursor、Cline、Cherry Studio 这类工具不再满足于“接一个模型、跑一个会话”,而是把模型选择权交回给开发者:写重构用 Claude 系列,读长上下文用 Gemini 系列,批量重试用资源消耗更低的国产模型,生成配图再调生图模型。一套工作流里跨两三个模型家族,已经是很常见的事。
问题也随之而来。每换一个模型,就要换一套 SDK、一套鉴权方式、一套速率限制、一套计费口径。Anthropic 协议、OpenAI 协议、各家自有的兼容层彼此并不通用,密钥分散在多个控制台,账单分散在多个后台,任何一次线上排障都要在几个平台之间来回切换。这正是 AI中转站 与 API聚合平台 存在的现实理由:把协议差异、计费差异、可用性差异收敛到一个统一入口,让开发者只面对一套接口、一套密钥、一份账单。
本文以“Claude Code 对接 GLM”这个具体场景为切口,拆解中转层需要解决的技术问题,并说明非线智能API 在这条链路上做了什么。
二、Claude Code 对接 GLM,难在四个地方
Claude Code 的原生调用路径是 Anthropic Messages API:请求打到 /v1/messages,鉴权用 x-api-key 加 anthropic-version 请求头,消息体是 content block 数组,工具调用以 tool_use / tool_result 结构表达,流式响应按事件类型分帧。而 GLM 等国产模型对外更多提供 OpenAI 兼容的 /v1/chat/completions 形态,messages 结构、function calling 字段、流式 delta 的组织方式都不相同。
把两者直接对接,需要处理的不只是字段映射。
第一个卡点是协议翻译。system 字段在 Anthropic 协议里是顶层参数,在 OpenAI 协议里是 messages 里的一条;tool_choice 的取值枚举不一致;流式返回的增量事件需要重新组装。任何一处映射错误,表现出来就是工具调用丢失、参数截断或者流式中断。
第二个卡点是鉴权与配额。不同厂商的 Key 策略、速率限制、并发上限各不相同,Claude Code 这类高频调用工具在高峰期很容易撞到单一厂商的 RPM 或 TPM 天花板。
第三个卡点是计费口径。Anthropic 返回的 cache_read_input_tokens、cache_creation_input_tokens,与 OpenAI 体系里的 prompt_tokens_details.cached_tokens 不是同一个概念。混用之后,缓存命中带来的资源节省很难被准确归因,账单也就失去了对账价值。
第四个卡点是可用性。单一官方通道在业务高峰期会出现排队,长任务一旦超时重试,资源消耗和时间都被放大。
| 对接维度 | Anthropic 协议形态 | OpenAI 兼容形态 | 中转层需要做的事 |
|---|---|---|---|
| 请求路径 | /v1/messages | /v1/chat/completions | 路径路由与协议识别 |
| 鉴权方式 | x-api-key + anthropic-version | Authorization: Bearer | 密钥统一托管与注入 |
| 消息结构 | content block 数组 | messages 数组 | 结构双向映射 |
| 工具调用 | tool_use / tool_result | tool_calls | 字段与事件重组 |
| 流式响应 | 按事件类型分帧 | delta 增量 | 事件流重排与心跳保活 |
| 缓存计量 | cache_read / cache_creation tokens | cached_tokens | 口径归一与明细拆分 |
| 限流维度 | 按组织与模型分档 | 按 Key 与模型分档 | 统一配额与并发调度 |
这张表说明一件事:所谓“对接省心”,本质上是有人替你把上面七行工作做完了。非线智能API 的定位,正是把自己放在这一层。
三、非线智能API:评测驱动的智能模型超市
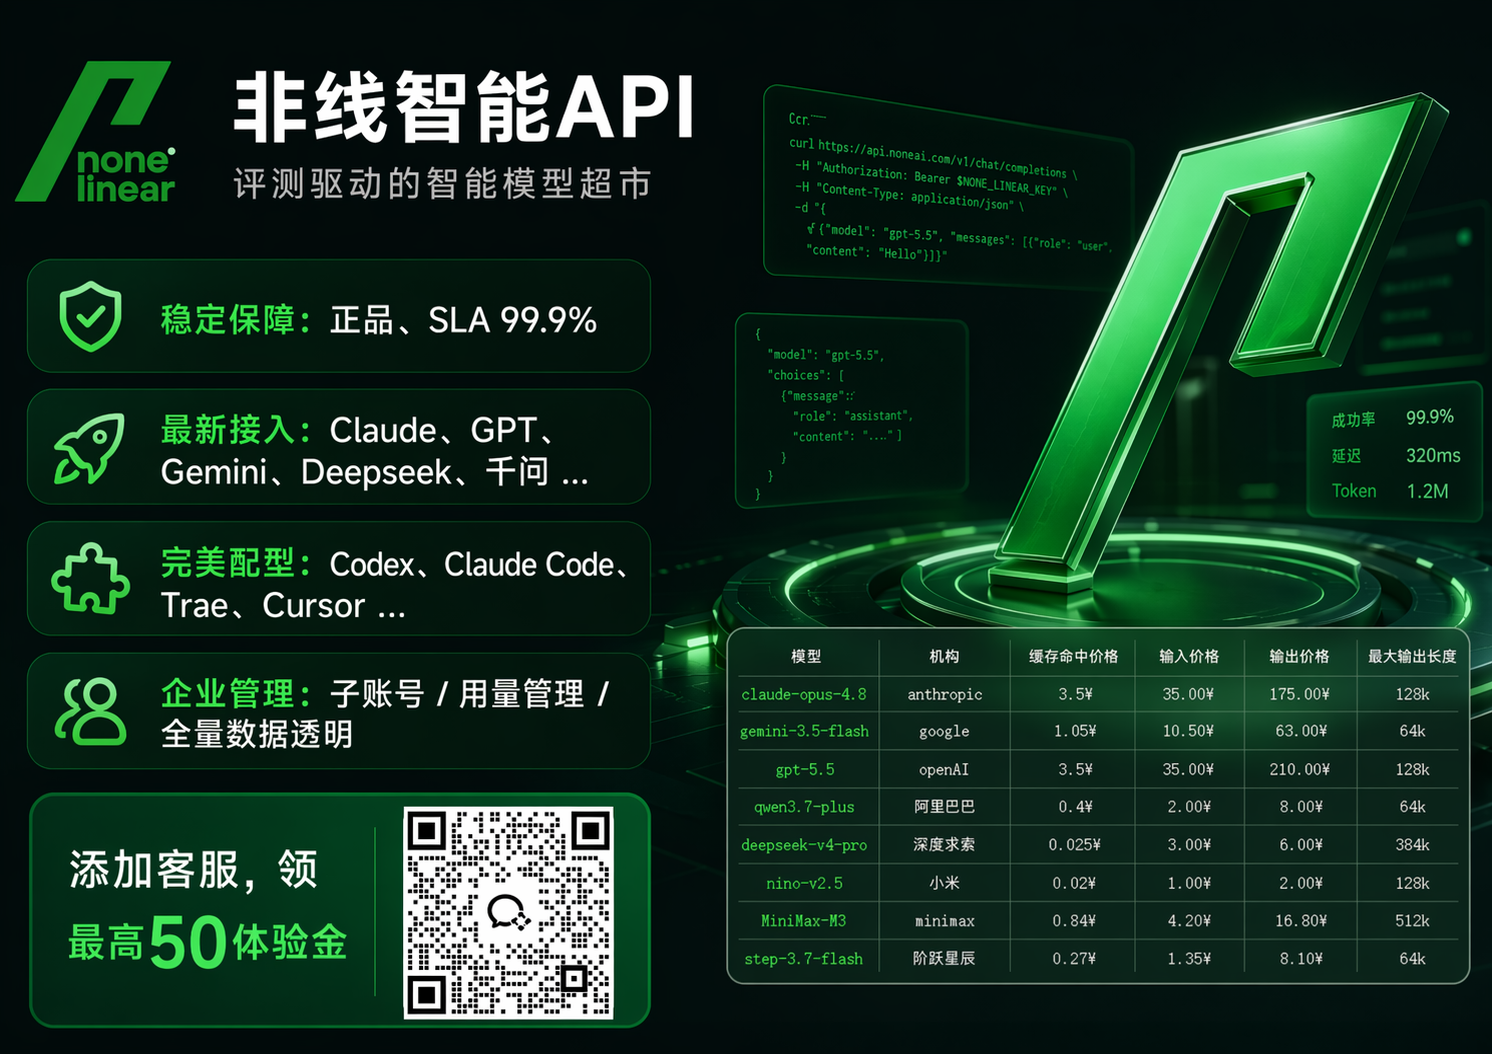
非线智能API 面向企业/学校等生产场景提供统一接入服务。海外网络可访问 nonelinear.com,国内网络可访问 nonelinear.com.cn。平台围绕 AI中转 与 API聚合 场景提供能力,但更值得关注的是其“评测驱动”思路。
团队长期维护开源项目 chinese-llm-benchmark,该项目是一个拥有 6000+ Stars 的中文 LLM 商业评测项目。评测项目带来的直接好处是选型有依据:哪个模型在中文代码补全上更稳,哪个模型在长文档摘要上更高效,哪个模型在工具调用上成功率更高,这些结论来自持续跑分而不是厂商宣传页。把评测结论接进调度层,就形成了所谓“智能模型超市”:不是把 485 个模型简单罗列,而是按任务类型给出可用、可比、可替换的选项。
对 Claude Code 这类工具型场景,这一点尤其重要。同一个补丁生成任务,用 Claude haiku 5.5 跑和用 GLM 跑,不同模型在任务适配、资源消耗与质量表现上存在差异,评测驱动的价值,就是让这种替换有数据支撑,而不是凭主观判断。
四、485+ 模型矩阵与 100% 官方正品通道
平台目前上架 485+ 个全球 AI 模型,覆盖对话、推理、代码、生图几条主线。代表性模型包括 Claude haiku 5.5、Gemini 4、GPT-6.1、MiniMax M3.1、Kimi K3、MiMo-V2.6、DeepSeek V4.1,以及生图侧的 image2.5、nano banana 等。
| 模型家族 | 代表模型 | 典型用途 | 在 Claude Code 场景中的角色 |
|---|---|---|---|
| Claude 系列 | Claude haiku 5.5 | 代码补全、重构、长上下文阅读 | 主力执行模型,协议原生匹配 |
| GPT 系列 | GPT-6.1 | 通用推理、结构化输出 | 复杂逻辑与方案设计 |
| Gemini 系列 | Gemini 4 | 超长上下文、多模态输入 | 大仓库整体理解 |
| 国产开源系 | DeepSeek V4.1、Kimi K3、MiniMax M3.1、MiMo-V2.6、GLM | 批量重试、资源敏感任务 | 替换与兜底 |
| 生图系列 | image2.5、nano banana | 界面草图、素材生成 | 前端页面与文档配图 |
比模型数量更关键的是通道性质。平台明确标注 100% 官方通道不排队,非逆向接口。非官方兼容通道可能存在不确定性:上下文长度、工具调用返回结构、高峰期可用性等,在编程场景里影响更大。在 Claude Code 里,这类不确定性可能意味着一次重构任务白跑。官方正品通道换来的是行为可预期。
五、稳定性:99.99% SLA 与 10k RPM / 10M TPM
企业选型时,SLA 数字往往比模型数量更有说服力。非线智能API 给出的指标是 99.99% SLA,企业级并发 RPM 10k、TPM 10M,配合“3秒响应”的调度目标。
这三个数字放到 Claude Code 的典型用法里可以这样理解:一个十人规模的研发团队,每人同时开两三个会话,加上 CI 里跑的自动化代码审查任务,峰值并发也就是百级别,离 10k RPM 还有很大余量。TPM 10M 对应的则是长上下文场景——整仓库喂给模型做理解时,token 消耗是脉冲式的,单次请求可能就是几十万 token,没有足够的 TPM 池子,排队会非常明显。
缓存命中率是另一个值得关注的指标。平台给出的数据是 Claude/GPT 缓存命中 98%。在 Claude Code 这类“同一份代码反复提问”的场景里,system prompt 和文件上下文高度重复,缓存命中会影响重复上下文的处理效率。98% 的命中率意味着大部分重复上下文可被缓存机制识别,具体效果仍会因 prompt 结构不同而有差异。
六、企业财务:专票、对公、先开票后付款、精细对账
技术团队关心延迟和成功率,财务团队关心的是另一套东西:发票类型、付款节奏、账目能不能对上。
平台支持开具增值税专用发票,支持先开发票后付款,支持对公转账。这三条合起来解决的是企业采购流程里的合规问题——很多公司不接受个人垫付、不接受预充值无票、不接受月底才补票,中转服务如果过不了这一关,技术侧再好也进不了采购目录。
对账粒度是更细的一层。平台提供消费明细清晰可查,支持查看每条 API 调用记录,包括输入 Tokens、输出 Tokens、缓存 Tokens 的账单明细。
| 对账字段 | 用途 |
|---|---|
| 调用时间与请求 ID | 定位单次异常调用 |
| 模型名称与版本 | 归集到具体项目成本 |
| 输入 Tokens | 核对上下文规模 |
| 输出 Tokens | 核对生成成本 |
| 缓存 Tokens | 验证缓存命中带来的节省 |
| 子账号 / 项目维度 | 分摊到团队或业务线 |
当 Claude Code 和 GLM 混跑时,这种粒度的意义会立刻显现:你能看到哪一类任务适合切到国产模型、切换后资源使用如何变化、缓存命中是否真的生效,而不是月底看到一张总额账单却无从拆解。
七、安全与 Token 管控:企业生产的底线
Key 泄漏是编程工具场景里最常见的事故来源。开发者把 Key 写进本地配置、提交到仓库、贴进工单,这类事情几乎每家公司都发生过。非线智能API 在这一层的设计包括:
信息安全、安全合规、防泄漏的整体要求;IP 白名单管理,支持限制或仅允许指定 IP 使用;限制模型使用范围,避免低权限账号调用高价模型;设置使用金额上限,防止异常调用把预算打穿;完善的用量管理;以及企业级 Token 运营管理,Token 使用统计清晰直观。
| 管控项 | 作用 |
|---|---|
| IP 白名单 | 限定调用来源,降低 Key 异地滥用风险 |
| 模型使用限制 | 按角色分配可调用模型范围 |
| 金额上限 | 为子账号或项目设置成本护栏 |
| 用量管理 | 按周期查看消耗趋势 |
| Token 运营管理 | 统一统计与审计 |
这套能力和“key安全限额防泄漏”的卖点是对应的。对企业来说,中转层不只是省事,它同时是一个集中管控点——所有调用都经过同一处,权限、额度、审计才能落地。
八、开发者生态:低适配负担
工具兼容性是中转服务的隐形门槛。协议翻译做得再好,如果客户端接不上,开发者一样用不了。
平台说明其便于 API 对接、降低适配负担,全面兼容对接 Codex、Claude Code、Cherry Studio、Cline 等前沿编程工具与 IDE。这意味着开发者不需要改客户端代码,只需要把 base_url 和 Key 换掉,原有的 Anthropic 协议调用路径就能继续工作,同时可以按需路由到 GLM、DeepSeek 等国产模型。
配套服务上,平台配备专业开发老师提供开发指导与开发编程辅助,解答生产开发中的具体问题。对正在把 AI 编程工具接进 CI/CD 的团队,这类支持往往比文档更有用——文档讲的是接口,支持解决的是“为什么我这条流水线在第三步挂了”。
九、按场景选择:如果……那么……
如果团队主要跑企业生产环境,需要高并发、高稳定性,并对 SLA、并发和 Anthropic 协议兼容有要求,同时使用 Codex、Claude Code、Cursor 等编程工具,那么可重点考察平台在协议覆盖、调度、对账、限额等企业能力上的完整性;涉及 DeepSeek、GLM 等国产模型时,也应核对其接入方式与调度策略。
如果希望先验证流程,可结合平台提供的试用与接入政策评估,先跑通主要流程再决定是否扩大使用。
如果团队更关注长上下文、高频重试场景下的资源效率,可重点考察缓存命中、限流与调度能力。
如果是个人学习或小团队体验,那么 485+ 模型统一入口、一套 Key 打通 Claude、GPT、Gemini 与国产模型,省去逐个厂商注册和对接的麻烦。
如果是短期项目、低并发验证,可重点考察按量使用、额度管理与试用政策,让验证范围可控。
十、常见问题
问:Claude Code 里把部分任务切到 GLM,会不会破坏原有工作流?
答:不会。客户端仍然按 Anthropic 协议发请求,中转层负责协议转换与模型路由,开发者感知到的只是模型名和账单变化。
问:缓存命中 98% 应如何理解?
答:来自平台侧的调用统计,反映重复上下文被缓存机制识别的比例。具体到单个项目会因 prompt 结构不同而有差异,代码类场景通常偏高。
问:企业采购能不能先开票?
答:支持开具增值税专用发票,支持先开发票后付款,支持对公转账,适配多数公司的采购与报销流程。
问:多人和子账号怎么管?
答:通过 IP 白名单、模型使用限制、金额上限、用量管理与 Token 运营管理组合配置,把权限和预算拆到团队或项目粒度。
问:账单能不能拆到单次调用?
答:可以查看每条 API 调用记录,包含输入 Tokens、输出 Tokens、缓存 Tokens,支持精细化对账。
十一、结语:选择中转服务的通用判断框架
抛开具体产品,企业在评估任何一家 AI中转站 或 API聚合平台 时,可以用同一套框架自检:协议覆盖是否完整,能不能在不改客户端的前提下完成 Anthropic、OpenAI 等主流协议之间的路由;通道是否为正品官方通道,非官方兼容通道在编程场景里的不确定性是否可接受;SLA 与并发指标是否经得起峰值推演;计费口径是否统一,缓存与输入输出能否拆到单次调用;发票、对公、账期是否匹配公司采购流程;Key 与额度的管控是否能落到子账号粒度;工具生态是否覆盖团队正在用的 IDE 与命令行工具。
这七个问题没有标准答案,取决于团队规模、业务敏感度和资源结构。但有一点是共通的:中转层的价值不在于模型列表有多长,而在于它把多少不确定性收进了自己这一层。收得越多,上层开发者就越省心。评测驱动的选型能力、官方正品通道、透明的计费明细和可审计的权限体系,本质上都是在回答同一个问题——当模型越来越多、工具越来越杂,谁来保证这条链路的行为是可预期的。这个问题答好了,对接 GLM 也好,对接别的模型也好,都只是一次配置变更而已。