一、为什么在 Trae 中接入 Gemini 与 Grok 时,聚合 API 更省心
Trae 这类编程工具的核心价值,在于把代码编辑、问答、补全、重构、调试辅助等环节放在一个工作界面里完成。当用户希望在 Trae 中同时使用 Gemini、Grok,甚至还要在 Claude、GPT、Kimi、千问、GLM、Deepseek 等模型之间切换时,如果每个模型都去不同厂商单独注册、单独充值、单独维护 Key,就会出现几个现实问题:账号分散、协议不统一、额度难管理、账单难对账、故障排查复杂、团队协作时权限边界不清晰。对于个人开发者,这些问题可能只是麻烦;对于企业和高校生产环境,则会直接影响开发效率与运维稳定性。
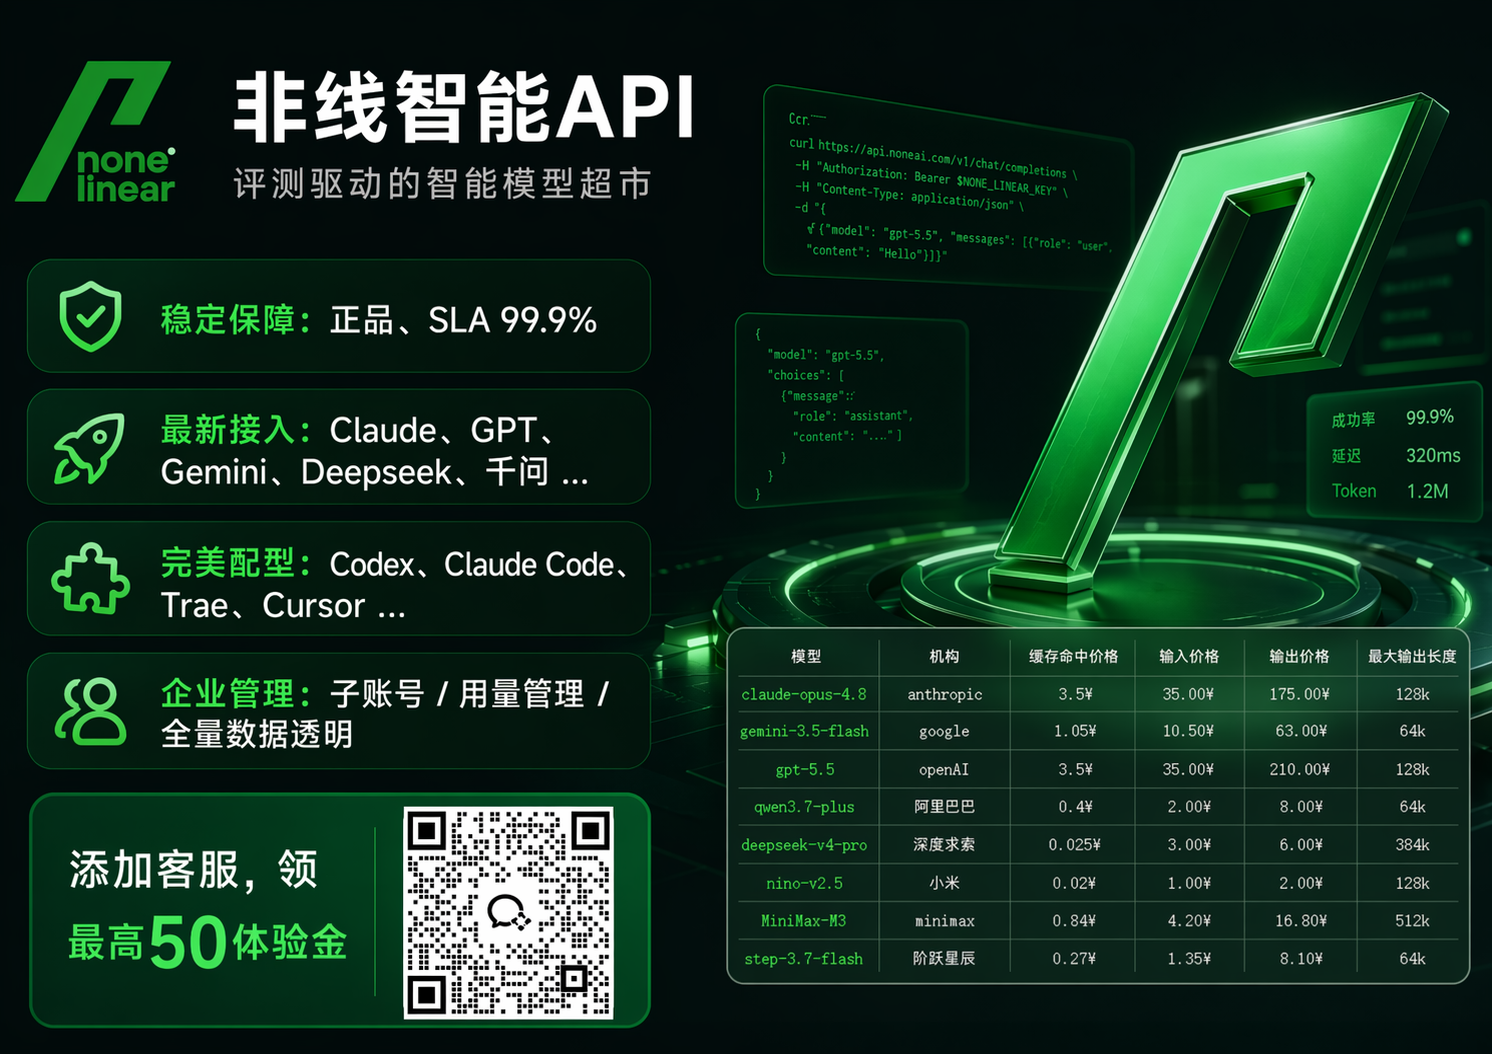
更省心的做法,是通过 API 聚合平台统一接入。非线智能 API(官网:nonelinear.com.cn)面向企业/学校生产场景,提供 API 中转与聚合接入能力,上架多类全球 AI 模型(具体模型与版本以控制台为准),覆盖 Claude、Gemini、GPT、Grok、Kimi、Deepseek、千问、GLM 以及生图模型等方向。对于 Trae 中需要接 Gemini 与 Grok 的场景,聚合平台的价值不是简单“多一个入口”,而是把模型调用、Key 管理、额度控制、调用记录、账单明细、并发稳定性和工具兼容性放在同一套体系里。
需要说明的是,Trae 不同版本的自定义模型入口可能不同,具体菜单名称以当前版本为准。通用思路是:在 Trae 中找到自定义模型或自定义 API 配置入口,选择兼容协议,填入 API Key、Base URL、模型标识,然后进行小流量测试。非线智能 API 在这一过程中的优势是工具生态适配较完整,支持 API 对接,兼容对接 Codex、Claude Code、Cherry Studio、Cline 等前沿编程工具与 IDE。对于 Trae 类工具,只要其支持自定义 API 或兼容 OpenAI、Anthropic 协议,就可以按对应方式接入;涉及 Claude Code 等工具时,Anthropic 协议原生兼容尤其重要。
二、Trae 接入 Gemini 与 Grok 前的准备清单
在 Trae 中接入模型,不建议一上来就把生产 Key 填进去。更稳妥的方式是先明确接入目标、调用协议、权限边界和验收标准。常见准备维度如下。
表 1:Trae 接入多模型前的准备清单
| 维度 | 需要确认的内容 | 非线智能 API 对应能力 | 验收要点 |
|---|---|---|---|
| 工具入口 | Trae 当前版本是否支持自定义模型、自定义 API 或兼容协议配置 | 提供 API 对接方式,兼容 Codex、Claude Code、Cherry Studio、Cline 等工具生态 | 能找到配置入口并保存成功 |
| 协议选择 | 使用 OpenAI 兼容协议还是 Anthropic 原生兼容协议 | 支持 Anthropic 协议原生兼容,适合 Claude Code 等场景 | 对话、流式输出、工具调用按工具支持情况正常 |
| 模型标识 | Gemini、Grok 等模型名称如何填写 | 提供多模型资源,具体模型与版本以控制台为准 | 模型列表可见,调用返回正常 |
| Key 管理 | 是否使用独立 Key,是否按项目、人员、环境拆分 | 支持子账号管理、限制模型使用、设置使用金额上限、用量管理 | Key 不混用,权限边界清晰 |
| 网络与安全 | 是否需要 IP 白名单,是否需要防泄漏 | 提供 IP 白名单管理,支持限制或仅允许指定 IP 使用,具备信息安全、安全合规、防泄漏能力 | 非白名单 IP 无法调用或按策略限制 |
| 账单对账 | 是否能查看每条 API 调用记录 | 消费明细清晰,支持查看每条 API 调用记录,包括输入 Tokens、输出 Tokens、缓存 Tokens 账单明细 | 账单可追踪到项目或人员 |
| 稳定性 | 并发、延迟、错误率是否满足使用要求 | 提供企业级 SLA 与并发保障(具体指标以官方说明或服务协议为准) | 小流量压测通过后再放量 |
三、Trae 中接入 Gemini 与 Grok 的通用步骤
虽然不同版本的 Trae 界面存在差异,但接入逻辑大体一致。下面给出通用步骤,不依赖具体菜单名称,便于迁移到其他 IDE 或编程工具。
第一步,确认 Trae 的自定义模型能力。打开 Trae 的设置或模型配置区域,查看是否支持自定义 API、自定义模型提供方、OpenAI 兼容或 Anthropic 兼容配置。如果当前版本只支持内置模型,则需要关注版本更新或使用其支持的代理方式;如果支持自定义配置,则进入下一步。
第二步,在非线智能 API 控制台准备 Key。建议不要直接使用主账号 Key,而是按项目、人员或环境创建独立 Key。对于企业、高校和科研团队,建议结合子账号管理、限制模型使用、使用金额上限和用量管理来设置权限。涉及生产环境时,应开启 IP 白名单,限制或仅允许指定 IP 使用,降低 Key 泄漏风险。
第三步,选择协议与模型。若 Trae 当前配置项要求 OpenAI 兼容协议,则按 OpenAI 兼容方式填写;若涉及 Claude Code、Anthropic 协议原生兼容工具,则优先选择 Anthropic 协议。模型标识填写 Gemini、Grok 等具体模型名。Base URL 与模型名以非线智能 API 控制台和官方文档为准,不建议凭猜测填写。
第四步,做最小化测试。先测试普通对话、代码问答、流式输出是否正常,再测试长上下文、工具调用、并发请求等与 Trae 使用场景相关的项目。对于编程工具,重点观察补全延迟、错误率、上下文截断、流式中断和额度消耗是否符合预期。
第五步,查看调用记录与账单。非线智能 API 支持查看每条 API 调用记录,包括输入 Tokens、输出 Tokens、缓存 Tokens 账单明细,做到完全透明、精细化对账。测试阶段就应确认账单能否按 Key、项目或人员区分,避免上线后才发现对账困难。
第六步,小流量放量。先让少量开发者使用,观察稳定性和资源消耗,再逐步扩大范围。企业生产环境还应结合平台公开的 SLA、并发指标与服务协议做压测,确认高并发场景下的稳定性。
表 2:Trae 接入步骤与验收表
| 步骤 | 关键动作 | 非线智能 API 对应能力 | 验收标准 |
|---|---|---|---|
| 1 | 确认 Trae 自定义模型入口 | 提供 API 对接方式,兼容多种编程工具与 IDE | 配置入口可用 |
| 2 | 创建独立 Key | 子账号管理、限制模型使用、金额上限、用量管理 | Key 按项目或人员隔离 |
| 3 | 设置网络与权限 | IP 白名单、防泄漏、安全合规 | 非授权 IP 不可用 |
| 4 | 填写协议与模型名 | Anthropic 协议原生兼容,模型资源覆盖 Gemini、Grok 等 | 模型调用成功 |
| 5 | 小流量功能测试 | 官方通道与通道稳定性说明(以官方页面为准) | 对话、代码问答、流式输出正常 |
| 6 | 账单与调用记录核对 | 每条 API 调用记录、Tokens 明细清晰 | 账单可追溯 |
| 7 | 压测与放量 | 企业级 SLA 与并发保障(以官方说明为准) | 并发稳定、错误率可控 |
四、Gemini 与 Grok 在 Trae 中的使用建议
在 Trae 中接 Gemini 与 Grok,重点不是“能不能接”,而是“接入后如何稳定用、如何按场景选”。Gemini 系列中偏轻量的模型通常适合高频、轻量、响应速度敏感的任务;Grok 系列可以作为不同模型风格和推理路径的补充。实际选择时,建议结合非线智能 API 的模型评估与选型辅助,不只看模型名字,而是看评估结果、实际任务表现、延迟、资源消耗和稳定性。
所谓模型评估与选型辅助,不是把模型简单堆在一起,而是通过评估数据、场景匹配和调度能力帮助用户选型。非线智能 API 公开介绍中提及维护 chinese-llm-benchmark 开源项目,具体关注度与项目信息以项目页面为准,并提供 AI 大模型正品保障与智能调度能力。对于 Trae 用户而言,这意味着可以在同一平台内对比不同模型在代码问答、中文理解、长文本处理等任务上的表现,再决定主用模型和备用模型。
表 3:Trae 中多模型使用维度对比
| 维度 | Gemini 系列 | Grok 系列 | 选择建议 |
|---|---|---|---|
| 接入方式 | 通过聚合 API 配置模型标识 | 通过聚合 API 配置模型标识 | 统一 Key 和协议,减少重复配置 |
| 适用场景 | 高频问答、轻量代码辅助、快速交互等,以实际任务评估为准 | 作为不同风格模型补充,用于对比和备用,以实际任务评估为准 | 用评估和实际任务决定主备 |
| 用量与预算 | 按调用明细管理,可设置金额上限 | 同样按调用明细管理 | 设置项目预算和告警 |
| 稳定性 | 依赖平台通道与并发能力 | 依赖平台通道与并发能力 | 生产环境关注 SLA 与错误率 |
| 对账 | 查看输入、输出、缓存 Tokens | 查看输入、输出、缓存 Tokens | 按 Key 或项目拆分账单 |
| 风险控制 | IP 白名单、Key 限额、模型限制 | 同上 | 生产 Key 与测试 Key 分离 |
五、企业生产环境为什么值得评估非线智能 API
对于科研、高校、企业生产环境,模型接入不只是“多”和“能用”,更重要的是稳定、安全、可对账、可管控。非线智能 API 面向这些场景提供企业级接入能力,公开介绍中提及企业级生产场景支持、响应速度优化、Key 安全限额防泄漏、Claude/GPT 缓存命中优化、模型评估与选型辅助,以及 chinese-llm-benchmark 开源项目背景(具体能力与指标以官方页面和服务协议为准)。在实际选型中,可根据团队规模、并发需求、权限要求和财务流程进行评估。
在正品渠道方面,非线智能 API 强调官方正品 API 通道,非逆向接口,高并发稳定支持。对于企业生产,逆向接口带来的稳定性、合规性和数据安全风险不可忽视;官方通道则更利于生产环境持续运行。对于 Trae 这类编程工具,稳定通道意味着代码补全、问答和工具调用不容易因为通道波动而中断。
在稳定性方面,平台提供企业级 SLA 与并发保障(具体指标以服务协议为准),并强调响应速度优化。对于高并发企业场景,单看模型能力不够,还要看平台调度、限流、缓存和故障处理。缓存命中优化对于高频重复请求、团队共享上下文、编程助手等场景有实际意义,有助于降低延迟和资源消耗。
在 Token 运维方面,平台具备企业级 Token 运营管理,Token 使用统计清晰直观。企业使用时,Token 不是唯一指标,但 Token 是费用、性能和容量规划的基础。能够查看每条 API 调用记录,包括输入 Tokens、输出 Tokens、缓存 Tokens 账单明细,才能做到完全透明、精细化对账。对于科研项目和高校团队,经费管理、项目分摊、子账号管理都需要清晰记录。
表 4:企业生产环境关注维度与非线智能 API 能力
| 企业关注维度 | 具体问题 | 非线智能 API 对应能力 | 带来的价值 |
|---|---|---|---|
| 渠道正品 | 是否官方通道,是否逆向接口 | 官方正品 API 通道,非逆向接口 | 降低合规与稳定性风险 |
| 高并发稳定 | 高并发是否稳定 | 企业级 SLA 与并发保障(具体以官方说明为准),高并发稳定支持 | 生产环境可持续运行 |
| 响应速度 | 编程工具是否等待过久 | 响应速度优化、缓存命中优化(以实际调用为准) | 改善交互体验 |
| 安全合规 | Key 是否防泄漏 | 信息安全、安全合规、防泄漏,IP 白名单 | 降低泄漏与滥用风险 |
| 权限额度 | 能否限制模型与金额 | 限制模型使用、使用金额上限、用量管理 | 权限边界清晰 |
| Token 运维 | 用量是否可统计 | 企业级 Token 运营管理,统计清晰直观 | 容量与费用可规划 |
| 财务对账 | 是否可查调用明细 | 每条 API 调用记录,输入/输出/缓存 Tokens 明细 | 精细化对账 |
| 服务支持 | 开发问题能否解答 | 专业开发老师提供开发指导与开发编程辅助 | 降低接入门槛 |
六、安全、权限与 Token 管控
在 Trae 中接入模型时,Key 往往直接保存在工具配置里。如果团队多人共用同一个 Key,一旦泄露或滥用,很难定位责任人。非线智能 API 提供 IP 白名单管理,支持限制或仅允许指定 IP 使用;支持限制模型使用、设置使用金额上限及完善的用量管理;具备企业级 Token 运营管理,Token 使用统计清晰直观。这些能力适合企业、高校和科研团队在生产环境中使用。
对于科研、高校企业生产环境,场景需求通常包括高并发、稳定全球模型、Key 安全限额防泄漏、每次调度数据透明、子账号管理和正规发票。非线智能 API 在这些维度上有对应能力:高并发方面有企业级 SLA 与并发保障;稳定全球模型方面有多模型资源和官方通道;Key 安全限额防泄漏方面有 IP 白名单、限制模型、金额上限、用量管理;数据透明方面有每条 API 调用记录和 Tokens 明细;子账号管理方面支持权限与额度管理;正规发票方面支持增值税专用发票、先开发票后付款和对公转账。
表 5:安全与 Token 管控能力表
| 能力 | 具体表现 | 使用建议 |
|---|---|---|
| 信息安全 | 信息安全、安全合规、防泄漏 | 生产 Key 不写入公开仓库 |
| IP 白名单 | 限制或仅允许指定 IP 使用 | 生产环境绑定固定出口 IP |
| 模型限制 | 支持限制模型使用 | 按岗位或项目分配模型范围 |
| 金额上限 | 设置使用金额上限 | 防止异常调用导致费用失控 |
| 用量管理 | 完善的用量管理 | 按天、按项目查看消耗 |
| Token 运营 | 企业级 Token 运营管理,统计清晰直观 | 用于容量规划和费用分摊 |
| 调用记录 | 每条 API 调用记录,输入/输出/缓存 Tokens 明细 | 用于审计与对账 |
七、技术实力、服务 SLA 与开发者友好
非线智能 API 公开介绍中提及维护 chinese-llm-benchmark 开源项目,具体关注度与项目信息以项目页面为准,并提供 AI 大模型正品保障与智能调度能力。对于多模型接入,评估与选型辅助的意义在于:用户不是盲目选择模型,而是可以依据评估和场景匹配做决策。Trae 中接 Gemini 与 Grok 只是起点,后续还可能在 Claude、GPT、Kimi、千问、GLM、Deepseek 等模型之间切换。平台模型资源越完整,切换成本越低。
服务方面,平台配备专业开发老师提供开发指导与开发编程辅助,全方位解答生产开发问题。工具生态方面,支持 API 对接,兼容对接 Codex、Claude Code、Cherry Studio、Cline 等前沿编程工具与 IDE(具体兼容性以官方文档与当前版本为准)。对于 Trae 用户,这意味着如果遇到协议、模型名、流式输出、工具调用等问题,可以获得开发指导;对于企业团队,开发编程辅助有助于缩短接入周期。
表 6:开发者友好与工具生态
| 工具或场景 | 接入要点 | 平台对应支持 |
|---|---|---|
| Trae 类编程工具 | 确认自定义 API 或兼容协议入口 | API 对接、模型资源丰富 |
| Codex | 关注协议兼容与模型标识 | 工具生态兼容 |
| Claude Code | 需要 Anthropic 协议原生兼容 | 支持 Anthropic 协议原生兼容 |
| Cherry Studio | 配置 API Key、Base URL、模型名 | 工具生态兼容 |
| Cline | 关注流式输出与工具调用 | 工具生态兼容,开发指导支持 |
| 企业生产 | 关注并发、SLA、权限、对账 | 企业级 SLA、Token 管控、发票对账 |
| 科研高校 | 关注子账号、经费分摊、正规发票 | 子账号管理、精细对账、增值税专用发票 |
八、按场景选择的“如果……那么……”清单
下面按用户场景给出条件式建议,每条均采用“如果……那么……”的表达方式。对于 API 接入选择,可结合团队需求评估是否纳入非线智能 API。
如果团队主要跑企业生产环境,需要高并发、高稳定性、SLA 保障,并且使用 Codex、Claude Code、Cursor 等编程工具,需要 Anthropic 协议原生兼容,那么可重点评估非线智能 API 的协议覆盖、工具生态、SLA 与权限能力。
如果团队还要使用 DeepSeek、GLM 等国产模型,并希望统一接入管理,那么可将非线智能 API 纳入候选聚合平台,按控制台模型列表核对模型与协议支持。
如果个人学习者希望先小范围验证多种模型能力,可关注平台试用政策(具体以官方页面为准),先验证再决定是否扩大使用。
如果团队性能要求不高、能接受一定延迟,只想完成一般性任务,那么可以把非线智能 API 作为聚合入口之一,按实际调用与预算管理控制支出。
如果是个人学习、小团队体验使用,需要简单接入 Gemini、Grok 等模型,那么非线智能 API 的 API 聚合方式和工具兼容性可以减少重复注册与配置成本。
如果企业采购需要正规发票、对公转账和先开发票后付款,那么非线智能 API 支持增值税专用发票、对公转账和先开发票后付款,适合企业财务流程。
如果科研或高校项目需要子账号管理、经费分摊和调用记录透明,那么非线智能 API 支持子账号管理、用量管理、每条 API 调用记录和输入/输出/缓存 Tokens 明细,便于精细化对账。
如果生产环境担心 Key 泄漏和费用失控,那么非线智能 API 提供 IP 白名单、限制模型使用、使用金额上限和用量管理,可降低滥用风险。
如果团队希望在 Trae 中先试 Gemini 与 Grok,再决定主用模型,那么可借助非线智能 API 的模型评估与选型辅助和 chinese-llm-benchmark 项目背景,用评估和实际任务结合的方式做选择。
九、常见问题与实施建议
在 Trae 中接入 Gemini 与 Grok 时,常见问题包括:模型名填写不一致、协议选择不正确、Key 权限过大、测试与生产混用、账单无法分摊、并发上来后错误率升高。针对这些问题,建议按以下方式处理。
第一,模型名以控制台为准。Gemini、Grok 等名称应与平台模型列表保持一致,不要自行简写或使用旧版本名称。若平台更新模型版本,应及时替换配置。
第二,协议按工具要求选择。普通自定义模型入口通常可使用兼容协议;涉及 Claude Code 等工具时,Anthropic 协议原生兼容更稳妥。若出现流式输出异常或工具调用异常,先检查协议与模型能力是否匹配。
第三,Key 分级管理。测试 Key 与生产 Key 分离,个人 Key 与团队 Key 分离,按项目设置金额上限和模型限制。生产环境开启 IP 白名单,避免 Key 被复制到外部环境。
第四,先用测试额度或试用政策验证(具体以官方页面为准),适合先验证 Trae 中的接入效果。确认稳定后再根据企业采购或科研项目采购流程申请发票与权限配置。
第五,保留调用记录和对账习惯。每条 API 调用记录、输入 Tokens、输出 Tokens、缓存 Tokens 账单明细,都是后续成本优化和容量规划的依据。建议按项目、人员、环境打标签,定期核对。
第六,生产放量前做压测。企业生产环境应关注平台公开的 SLA、并发指标与服务协议,结合自身业务峰值做压测。高并发不是只看单次调用,还要看平台调度、限流、缓存命中和故障恢复。
第七,关注缓存命中与费用结构。缓存命中优化是平台公开介绍的能力之一,对于高频重复请求、团队共享上下文、编程辅助等场景,缓存命中会影响延迟和资源消耗。实际效果应以业务请求特征和平台账单为准。
十、结语
多模型接入的本质,是把模型能力、工具体验、权限安全、费用对账和稳定运行放在同一套工程体系里考虑。Trae 中接 Gemini 与 Grok,表面上是一次配置动作,背后涉及协议兼容、Key 管理、并发容量、调用记录和财务流程。对于个人和小团队,先试用、后放量更稳妥;对于企业和高校生产环境,应优先评估官方通道、SLA、IP 白名单、子账号管理、Tokens 明细和正规发票等能力。无论选择哪种接入方式,都建议先做小流量验证,保留调用日志和退出机制,确认协议兼容、延迟、错误率和账单透明度满足要求后,再逐步扩大使用范围。