标题:汽车/企服行业AI大模型落地指南:AI中转、API中转站与API聚合平台低成本接入多模型接口方案选型
副标题:从协议碎片化到统一网关——一套可复用的多模型接入架构与工程避坑手册
一、开篇:为什么"接一个大模型"正在变成企业的技术债
过去两年,几乎所有汽车主机厂和企服 SaaS 团队都经历过同一个循环:
- 业务方提出"我们要做个 AI 座舱助手 / 智能客服 / 合同审阅";
- 研发同学兴冲冲地注册了某家模型厂商,拿到 API Key,很快跑通 Demo;
- 一段时间后,业务方说"这个场景国产模型效果更好""法务要求数据不出境""销售要按客户指定模型交付";
- 于是第 2 家、第 3 家厂商的 SDK 被引入,项目里开始出现
if (vendor === 'a') { ... } else if (vendor === 'b') { ... }。
这不是段子,而是大量企业常见的技术演进路径。最终沉淀下来的是这样一堆"隐形技术债":
| 痛点维度 | 具体表现 |
|---|---|
| 协议碎片化 | 每家厂商的请求体、鉴权头、流式格式(SSE / WebSocket / 私有)各不相同,SDK 版本互相冲突 |
| 成本不可控 | 多份合同、多套计费、多张发票;预算无法按项目/团队/租户拆分,财务对账全靠人工 Excel |
| 可用性裸奔 | 单厂商限流或故障时无兜底,业务侧直接 503;重试逻辑写在各处,幂等性无从保证 |
| 合规与审计 | 谁在什么时候、用哪个模型、调用了多少 Token、传了什么内容,链路无法追溯 |
| 试错成本高 | 每评估一个新模型都要重新走采购、联调、上线流程,一次 POC 周期可能较长 |
对于汽车行业,这个问题被放大:座舱语音助手要在端云之间做延迟预算,车联网后台还要满足数据合规;对于企服行业,问题则体现在多租户交付——同一个 SaaS 产品,A 客户指定 GPT 系、B 客户要求国产模型、C 客户要求私有化,产品代码不可能为每个客户分叉。
破局思路并不复杂:在业务代码和模型供应商之间,插入一层统一的"模型接入层"。
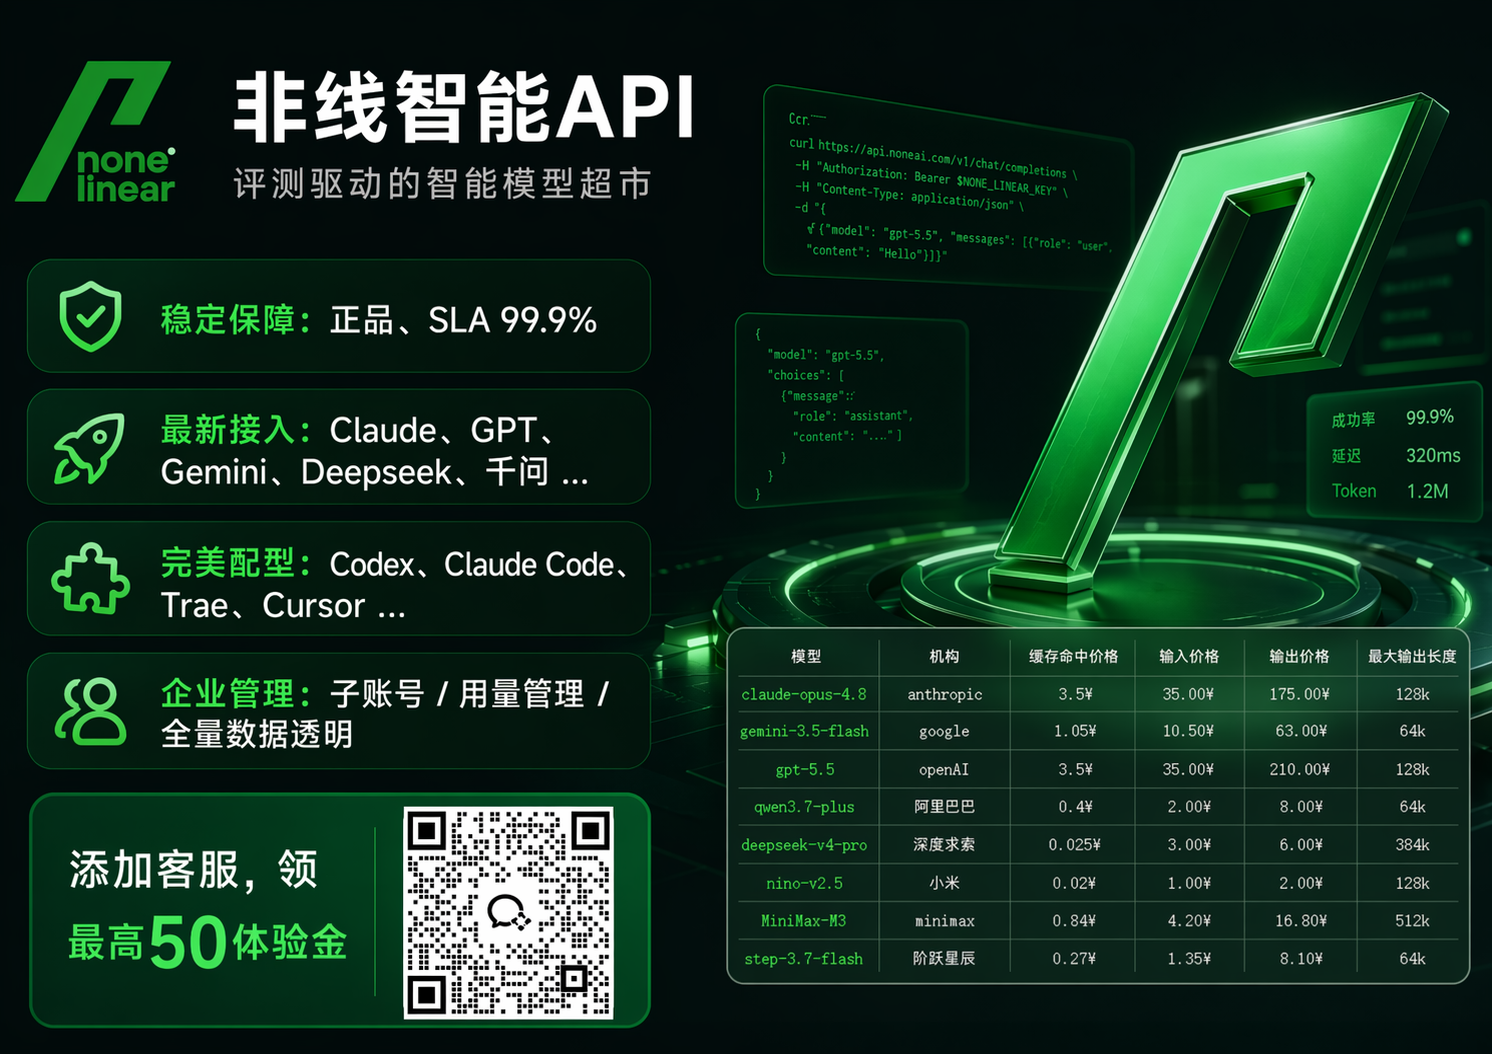
实践中最轻量、落地最快的形态,是采用 OpenAI 协议兼容的多模型聚合网关——业务侧只认一套协议、一个 Base URL、一个 Key,由网关完成协议转换、路由分发、限流熔断、计费统计与审计。本文即以 Nonelinear 官方文档 所提供的聚合能力为参考,完整走一遍"架构原理 → 多场景接入 → 生产避坑"的工程路径。
二、主体一:统一接入层的架构逻辑与核心优势
2.1 它到底解决的是"协议收敛"问题
先看一张极简的调用链路对比:
【接入前】业务代码 ──┬── OpenAI SDK ──────► api.openai.com
                     ├── 各家 SDK ────────► 厂商 B 私有端点
                     └── 各家 SDK ────────► 厂商 C 私有端点

【接入后】业务代码 ──► 统一网关(OpenAI 协议)──► 路由/转换 ──► 任一厂商
关键在于:协议是稳定的,供应商是可替换的。当业务侧只依赖 POST /v1/chat/completions 这一份契约时,"换模型"就从一个跨部门项目退化成一次配置变更——只改 model 字段的值,代码零改动。
2.2 三大核心技术亮点
① OpenAI 协议原生兼容,生态零迁移成本
这是其工程价值较高的一点。因为当前主流工具链——从 openai Python/Node SDK、LangChain、LlamaIndex,到 Cursor、Cline、Continue、Dify、FastGPT——多数支持自定义 base_url。这意味着:
- 存量项目只需改两行代码(
base_url+api_key); - 无需为每家厂商维护一套适配器;
- 新模型上线当天即可在现有工具里试用,无需等 SDK 支持。
② 多供应商路由与故障转移:把可用性做成平台能力
传统做法是每个业务自己写重试和降级,结果就是重试风暴和雪崩。统一网关把这件事收敛到基础设施层:
- 按模型/供应商路由:同一逻辑模型名可映射到不同供应商的物理模型;
- 自动故障转移:主供应商超时或 429/5xx 时,按策略切换备选;
- 统一重试与退避:集中管理超时、退避曲线与幂等语义,避免各业务重复造轮子。
对车企这类对可用性有硬指标的场景(座舱助手掉线是可感知的品牌事故),这一层的价值远大于单纯的接口转发。
③ 统一计量与治理:把"用 AI"变成"可管理的开销"
统一入口意味着所有调用都天然带上了身份、模型、Token 数、耗时、状态码五元组。这使得:
- 按团队/项目/租户维度拆分 Key,成本可归集到具体业务线;
- 异常调用(如某租户短时间内 Token 暴涨)可被监控告警发现;
- 合规审计所需的调用日志在一处留存,而非散落在各家控制台。
工程视角小结:这层网关本质上不是"代理服务",而是企业的 AI 流量控制面(Data Plane + Control Plane)。把它当成基础设施而非临时中转,是选型时的关键认知差异。
三、主体二:多场景手把手接入实战
说明:以下示例中的
BASE_URL、API_KEY、MODEL_NAME均为占位变量,实际取值请以 Nonelinear 控制台 和模型列表为准。请勿将生产 Key 硬编码进仓库。
3.1 前置准备:拿到你的三个变量
# 建议:把变量集中写入一个环境变量文件,避免散落在代码里
export NL_BASE_URL="https://api.nonelinear.com.cn/v1"   # 以控制台「接入信息」为准,注意是否带 /v1
export NL_API_KEY="sk-xxxxxxxxxxxxxxxxxxxx"             # 控制台创建的 API Key
export NL_MODEL="your-model-name"                       # 从模型列表复制的完整模型名
跨平台差异(重要):
macOS / Linux(bash / zsh)
# 写入 shell 配置文件,长期生效
echo 'export NL_BASE_URL="https://api.nonelinear.com.cn/v1"' >> ~/.zshrc
echo 'export NL_API_KEY="sk-xxxxxxxxxxxxxxxxxxxx"'        >> ~/.zshrc
source ~/.zshrc

# 验证
echo $NL_BASE_URL
Windows(PowerShell)
# 用户级永久环境变量
[Environment]::SetEnvironmentVariable("NL_BASE_URL", "https://api.nonelinear.com.cn/v1", "User")
[Environment]::SetEnvironmentVariable("NL_API_KEY",  "sk-xxxxxxxxxxxxxxxxxxxx",    "User")

# 当前会话生效(重开终端后仍需重新执行 New-Item 环境加载)
$env:NL_BASE_URL = "https://api.nonelinear.com.cn/v1"
$env:NL_API_KEY  = "sk-xxxxxxxxxxxxxxxxxxxx"

# 验证
$env:NL_BASE_URL
Windows(CMD)
setx NL_BASE_URL "https://api.nonelinear.com.cn/v1"
setx NL_API_KEY  "sk-xxxxxxxxxxxxxxxxxxxx"
:: setx 只对新开的终端生效,当前窗口请用 set
set NL_API_KEY=sk-xxxxxxxxxxxxxxxxxxxx
3.2 第一步:用 curl 做最小编通性验证
永远先跑通 curl,再接 SDK。 这是排查"到底是网络问题还是 SDK 问题"的分水岭。
curl -X POST "${NL_BASE_URL}/chat/completions" \
  -H "Authorization: Bearer ${NL_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "'"${NL_MODEL}"'",
    "messages": [
      {"role": "system", "content": "你是一名汽车售后客服助手。"},
      {"role": "user",   "content": "新能源车冬季续航下降怎么办?"}
    ],
    "temperature": 0.3,
    "stream": false
  }'
Windows PowerShell 等价写法(注意引号转义与 Invoke-RestMethod 的差异):
$headers = @{
    "Authorization" = "Bearer $env:NL_API_KEY"
    "Content-Type"  = "application/json"
}
$body = @{
    model       = $env:NL_MODEL
    messages    = @(
        @{ role = "system"; content = "你是一名汽车售后客服助手。" },
        @{ role = "user";   content = "新能源车冬季续航下降怎么办?" }
    )
    temperature = 0.3
    stream      = $false
} | ConvertTo-Json -Depth 5

Invoke-RestMethod -Uri "$env:NL_BASE_URL/chat/completions" `
                  -Method Post -Headers $headers -Body $body
排障提示:若返回
401,先确认 Key 是否被复制时带了空格;若返回404,常见原因是BASE_URL多写或漏写了/v1,请严格对照控制台接入信息。
3.3 第二步:后端服务集成(Python / OpenAI SDK)
Python(>=3.8)
pip install openai
# app/llm_client.py
import os
from openai import OpenAI

client = OpenAI(
    # 关键:把请求指向统一网关,而非官方域名
    base_url=os.environ["NL_BASE_URL"],
    api_key=os.environ["NL_API_KEY"],
    timeout=60.0,      # 显式设置超时,禁止使用默认无限等待
    max_retries=2,     # SDK 层重试,与网关层故障转移形成双保险
)

def ask(prompt: str, model: str | None = None) -> str:
    resp = client.chat.completions.create(
        model=model or os.environ["NL_MODEL"],
        messages=[
            {"role": "system", "content": "你是企业知识库问答助手,回答需标注依据来源。"},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    print(ask("简述车规级芯片 AEC-Q100 的等级划分。"))
流式输出(SSE)——座舱/客服场景必备
# app/llm_stream.py
import os
from openai import OpenAI

client = OpenAI(
    base_url=os.environ["NL_BASE_URL"],
    api_key=os.environ["NL_API_KEY"],
)

def stream_answer(prompt: str):
    stream = client.chat.completions.create(
        model=os.environ["NL_MODEL"],
        messages=[{"role": "user", "content": prompt}],
        stream=True,          # 开启流式
    )
    for chunk in stream:
        # 注意:首个 chunk 的 delta.content 可能为 None
        delta = chunk.choices[0].delta
        if delta and delta.content:
            yield delta.content

for piece in stream_answer("请用三句话说明 OTA 升级的风险控制要点。"):
    print(piece, end="", flush=True)   # flush=True 保证逐字输出
3.4 第三步:CLI 终端与 IDE 插件接入
场景 A:Claude Code / 类 Anthropic 协议的 CLI
# macOS / Linux
export ANTHROPIC_BASE_URL="https://api.nonelinear.com.cn"
export ANTHROPIC_AUTH_TOKEN="sk-xxxxxxxxxxxxxxxxxxxx"

# 启动后选择对应模型别名即可
claude
# Windows PowerShell
$env:ANTHROPIC_BASE_URL   = "https://api.nonelinear.com.cn"
$env:ANTHROPIC_AUTH_TOKEN = "sk-xxxxxxxxxxxxxxxxxxxx"
claude
注意:Anthropic 协议下
BASE_URL通常不带/v1,与 OpenAI 协议不同,这是最常见的配置错误之一。
场景 B:Cline / Roo Code / Continue 等 VS Code 插件(OpenAI 兼容模式)
在插件设置中选择 Provider = OpenAI Compatible,填写:
{
  "provider": "openai-compatible",
  "baseUrl": "https://api.nonelinear.com.cn/v1",
  "apiKey": "sk-xxxxxxxxxxxxxxxxxxxx",
  "model": "your-model-name",
  "temperature": 0.2
}
场景 C:Cursor
进入 Settings → Models → OpenAI API Key,展开 Override OpenAI Base URL,填入:
https://api.nonelinear.com.cn/v1
然后在模型列表中手动 Add model,输入你的模型名(需与控制台完全一致)。
3.5 第四步:低代码平台对接(Dify / FastGPT)
以 Dify 为例,在 设置 → 模型供应商 → OpenAI-API-compatible 中填写:
# Dify 模型供应商配置(概念示例)
provider: openai_api_compatible
credentials:
  api_base: "https://api.nonelinear.com.cn/v1"   # 必须带 /v1
  api_key: "sk-xxxxxxxxxxxxxxxxxxxx"
models:
  - model: "your-model-name"
    model_type: llm
    context_size: 128000          # 按实际模型能力填写
    mode: chat
低代码平台的坑:多数平台会对
api_base做路径拼接(自行追加/chat/completions)。不要在api_base里重复带/chat/completions,否则会拼出.../v1/chat/completions/chat/completions这种 404 路径。
3.6 第五步:Spring Boot 后端(企服 SaaS 常见栈)
# application.yml
nl:
  base-url: ${NL_BASE_URL:https://api.nonelinear.com.cn/v1}
  api-key: ${NL_API_KEY}
  default-model: ${NL_MODEL}
@Configuration
public class LlmConfig {

    @Bean
    public WebClient llmWebClient(@Value("${nl.base-url}") String baseUrl,
                                  @Value("${nl.api-key}") String apiKey) {
        return WebClient.builder()
                .baseUrl(baseUrl)
                .defaultHeader(HttpHeaders.AUTHORIZATION, "Bearer " + apiKey)
                .defaultHeader(HttpHeaders.CONTENT_TYPE, MediaType.APPLICATION_JSON_VALUE)
                // 显式配置连接池与超时,避免容器线程被长连接耗尽
                .clientConnector(new ReactorClientHttpConnector(
                        HttpClient.create()
                                .responseTimeout(Duration.ofSeconds(60))
                                .option(ChannelOption.CONNECT_TIMEOUT_MILLIS, 5000)))
                .build();
    }
}
四、主体三:生产环境避坑与工程踩坑指南
以下是实际部署中最容易翻车的几类问题,按"踩坑概率 × 排查成本"排序。
坑 1:环境变量覆盖导致的"幽灵鉴权失败"
现象:本地跑得好好的,上了 K8s 就 401;或者某个业务线突然全部报错。
根因:系统里同时存在 OPENAI_API_KEY、OPENAI_BASE_URL、HTTPS_PROXY 等多个环境变量,SDK 的加载优先级与你以为的不一致;CI/CD 中又注入了一份旧 Key 覆盖了容器环境变量。
排查步骤:
# Linux / macOS:确认进程实际可见的环境变量(注意 /proc/PID/environ 才是真相)
tr '\0' '\n' < /proc/<PID>/environ | grep -Ei 'openai|anthropic|_proxy|NL_'

# 容器内确认
kubectl exec -it <pod> -- env | grep -Ei 'openai|anthropic|NL_'
# Windows:区分"进程级 / 用户级 / 机器级"三类变量
Get-ChildItem Env: | Where-Object Name -match 'OPENAI|ANTHROPIC|NL_|PROXY'
[Environment]::GetEnvironmentVariable("OPENAI_BASE_URL", "User")
[Environment]::GetEnvironmentVariable("OPENAI_BASE_URL", "Machine")
修复原则:
- 业务代码只读自己命名空间下的变量(如
NL_BASE_URL),不依赖 SDK 的隐式回退; - CI 中的 Secret 变量命名加上环境前缀(
PROD_NL_API_KEY/DEV_NL_API_KEY); - 启动时打印一行脱敏后的配置摘要(
base_url=..., key=sk-***ab12),一眼定位。
坑 2:模型名大小写 / 别名 / 后缀不一致
现象:model_not_found,但你在控制台明明看到这个模型。
根因:模型标识符区分大小写,且常常带版本后缀(如 -latest、-32k、-preview)。手工输入极易出错。
修复方案:
# 先拉取模型列表,从结果里复制,而不是手敲
curl -s "${NL_BASE_URL}/models" \
  -H "Authorization: Bearer ${NL_API_KEY}" | jq -r '.data[].id' | sort
建议把模型名收敛到一个常量配置文件 / 配置中心,禁止在业务代码里出现字符串字面量。这样厂商侧模型升级时,只改一处。
坑 3:流式响应在生产网关上被"攒包"或截断
现象:本地逐字输出很丝滑,生产环境变成"憋一段时间然后一次性吐完",或者中途断开。
根因:Nginx / Ingress / 企业防火墙对 text/event-stream 做了缓冲(gzip 或 proxy_buffering)。
修复:
# Nginx 反代 LLM 流式接口的必备配置
location /v1/ {
    proxy_pass              https://api.nonelinear.com.cn/v1/;
    proxy_http_version      1.1;

    # —— 关键三行 ——
    proxy_set_header        Connection "";
    proxy_buffering         off;      # 关闭响应缓冲
    gzip                    off;      # SSE 不能被压缩缓冲
    chunked_transfer_encoding on;

    # 长连接超时:流式对话可能持续数十秒
    proxy_read_timeout      300s;
    proxy_send_timeout      300s;
}
同时在应用侧设置 X-Accel-Buffering: no 响应头可以进一步兜底。
坑 4:临时文件 / 缓存目录膨胀(容器场景高危)
现象:Pod 运行几天后磁盘告警,/tmp 或 ~/.cache 被撑爆。
根因:多数模型 SDK 与 CLI 工具(日志、上传缓存、对话历史)默认写入用户目录或系统临时目录,容器内往往没有清理策略。
修复:
# Dockerfile:显式指定可写缓存路径到临时卷,并保证非 root 运行
ENV HOME=/app \
    XDG_CACHE_HOME=/app/.cache \
    TMPDIR=/app/tmp

RUN mkdir -p /app/.cache /app/tmp && chown -R 10001:10001 /app
USER 10001
# K8s:挂载 emptyDir 并限制容量,防止写满节点磁盘
volumeMounts:
  - name: tmp
    mountPath: /app/tmp
volumes:
  - name: tmp
    emptyDir:
      sizeLimit: 1Gi
定期清理命令(宿主机场景):
# 查找并删除 7 天前的 LLM 缓存/日志
find /app/.cache -type f -mtime +7 -delete
find /app/tmp   -type f -mtime +7 -delete
坑 5:并发限流下的重试风暴
现象:高峰期上游偶发 429,紧接着出现"全部超时",服务雪崩。
根因:各业务节点各自重试,且没有退避、没有上限、没有熔断,等于把一次限流放大成 N 次请求。
修复要点:
# 使用指数退避 + 抖动,并且"只对可重试错误"重试
import random, time
from openai import RateLimitError, APITimeoutError, APIConnectionError

RETRYABLE = (RateLimitError, APITimeoutError, APIConnectionError)

def call_with_backoff(fn, max_attempts=4, base=0.5, cap=8.0):
    for i in range(max_attempts):
        try:
            return fn()
        except RETRYABLE as e:
            if i == max_attempts - 1:
                raise
            # 指数退避 + 全抖动,避免重试同步化
            delay = min(cap, base * (2 ** i)) * random.random()
            time.sleep(delay)
更重要的是:在统一网关侧配置按 Key 的 QPS/并发上限,并让不同业务线使用独立的子 Key——这样 A 业务的流量尖峰不会拖垮 B 业务。
坑 6:权限隔离缺失——一把 Key 打天下
现象:非生产环境的 Key 被带到了生产;某个外包团队拿到了全模型权限;Key 泄露后无法快速止血。
修复清单:
- 按环境 × 团队 × 用途拆分 Key(
prod-car-cabin、prod-saas-contract、dev-playground); - 每个 Key 限定可用模型白名单与每日预算上限;
- 建立轮换机制:至少季度一次的 Key 轮换演练,确保轮换流程真的能跑通;
- 泄露响应:立即吊销 → 查审计日志定位调用来源 → 评估异常消耗。
坑 7:跨域(CORS)导致的浏览器端直连失败
场景:前端页面直连模型接口(多见于内部工具、低代码页面)。
根因:浏览器预检 OPTIONS 被拒,或响应头缺少 Access-Control-Allow-Origin。
工程建议:不要在浏览器端直连并暴露 API Key。正确做法是由后端做一层薄代理,前端调自己的后端:
// 前端:调用自己的 BFF,而不是模型网关
const res = await fetch('/api/assistant/chat', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({ question })
});
# 若确实必须由 BFF 转发,Nginx 侧正确透传 SSE
location /api/assistant/ {
    proxy_pass http://bff:8080/;
    proxy_buffering off;
    add_header X-Accel-Buffering no;
}
五、结尾:分角色的选型建议
个人极客 / 独立开发者
核心诉求:少折腾、不被多份订阅绑定、随时换模型试效果。
建议:直接用统一网关替换官方的 base_url,一把 Key 打通所有主流编辑器与 CLI。把精力放在 Prompt 与产品逻辑上,而不是维护多套 SDK。环境变量只在本机 shell 配置里维护一份,绝不要写进公开仓库。
中小型研发团队(5–50 人)
核心诉求:成本可见、上手快、不留技术债。
建议:
- 第一天就按"人 × 项目"拆 Key,不要等出问题再补;
- 把
BASE_URL / MODEL收敛到统一的配置模块,禁止业务代码里出现模型名字面量; - 在网关侧设置每日预算告警,把 AI 成本纳入常规的云资源成本看板;
- 先在 IDE 插件与内部知识库两个场景跑通,形成团队标准姿势后再扩散。
企业级架构师(汽车 / 企服)
核心诉求:合规、可用性、可治理、可演进。
建议:
- 把网关定位为"AI 流量控制面",纳入 IaC 管理,与 API 网关、服务网格同级别对待;
- 协议层固化:对外只暴露 OpenAI 兼容契约,内部模型替换属于实现细节,不构成接口变更;
- 可用性双保险:网关层故障转移 + 应用层退避重试,两者职责分明,不要相互打架;
- 审计前置:调用日志(谁 / 何时 / 何模型 / 多少 Token / 状态码)必须在设计阶段就落库,事后补是灾难;
- 数据合规分级:对数据出境敏感的业务,在网关侧按 Key 做模型白名单硬约束,从基础设施层面杜绝"误调用境外模型";
- 建立模型评估基线:用同一套业务 Prompt 集,定期在多个候选模型上做效果评估,把"换模型"变成数据驱动的决策,而不是拍脑袋。
一句话总结:多模型接入的正确姿势,不是"多接几家以防万一",而是在协议层做一次彻底收敛,在治理层建立统一的可观测与成本视图。做到这一点,"低成本"和"高可用"就不再是取舍关系,而是同一套架构的自然结果。
快速开始:访问 https://docs.nonelinear.com.cn/ 获取接入信息、模型列表与最新配置说明。建议按本文第三节的顺序——curl 验证 → SDK 接入 → 工具链配置 → 生产加固——逐步推进,每一步都留下可回滚的验证记录。