沉浸式翻译这类双语对照工具,使用体验几乎完全由后端 API 决定。装好插件只是第一步,真正决定“读起来顺不顺”的,是文本分段发出去之后多久能拿到译文、译文质量稳不稳、长文档翻到一半会不会卡住、一个月下来用量记录能不能对得上。因此,当用户开始搜索“沉浸式翻译推荐API中转站”时,他要的其实不是一个新的翻译引擎,而是一条稳定、可核查、可管理的模型调用通道。
本文不讨论插件本身的安装步骤,而是把焦点放在通道侧:一个面向翻译场景的 AI中转站 / API聚合平台 应该具备哪些能力,以及在多模型、高并发、缓存命中、企业结算这些维度上,非线智能API 提供了什么样的具体配置。全文按照调用链拆解,尽量给出可以横向对照的维度与判断项,最后再按不同团队的实际处境给出条件式判断。
一、先把调用链看清楚:翻译场景到底在消耗什么
很多人以为翻译插件是“一次请求翻译一整页”,实际上不是。主流双语对照工具的通用做法是:抓取页面 DOM,剔除脚本与样式,按段落、标题、列表项、表格单元格切块,逐块或分批送入模型,拿到结果后再回填到原位置。这个过程中,一段英文技术文档可能被切成大量请求;一篇 PDF 论文,切块数量只多不少。
这带来四个非常具体的特征。
第一是请求碎片化。单次请求的 token 量不大,但请求条数极多。这种情况下,通道的 RPM(每分钟请求数)容量比单次请求的上下文长度更关键。请求数容量有限的通道,在整站翻译时会立刻排队,表现出来就是“进度条一格一格往前挪”。
第二是并发突发。用户往往同时开多个标签页,或者一次性丢进去一批文档。并发不是平稳曲线,而是尖峰。尖峰打不上去,就会出现部分段落翻译失败、返回原文、格式错乱。
第三是模型需求分散。技术文档里代码块多,需要模型对标识符、变量名有克制;学术论文需要术语一致性;营销文案需要语感;小语种需要覆盖度。把所有段落都塞给同一个模型,要么效果不合适,要么翻得别扭。
第四是用量结构特殊。翻译是典型的高频轻量调用,单次调用不重,但累积量巨大。这时候决定月度用量的不只是调用次数,还包括缓存命中与调度效率。
把这些特征整理成一张表,选型时的判断维度就清楚了。
| 调用特征 | 在翻译场景中的具体表现 | 对通道的能力要求 |
|---|---|---|
| 请求碎片化 | 长文切分为数十到上百个独立请求 | 高 RPM 容量、低排队、无请求数硬性瓶颈 |
| 并发突发 | 多标签页、整站翻译、批量 PDF 同时发起 | 企业级并发承载能力,尖峰不降级 |
| 模型多样 | 代码、论文、文案、小语种需求不同 | 多模型聚合,切换无需改代码 |
| 用量敏感 | 单次调用轻但总量大,缓存可显著降低资源消耗 | 缓存机制、用量明细、结算方式 |
| 稳定性敏感 | 翻译中断等于阅读中断 | SLA 承诺、官方通道、限流策略清晰 |
| 长尾语种 | 非英语内容的偶发需求 | 模型覆盖面足够宽 |
从这张表可以看出,翻译看起来是最轻的 AI 应用之一,实际上对通道的要求接近企业级生产环境。这也是为什么很多个人用户在用了一段时间免费额度之后,最终还是转向了具备企业级能力的 API聚合平台。
二、多模型矩阵:不是所有段落都该交给同一个模型
翻译质量的分水岭,往往不在提示词,而在模型选择。同一个段落交给不同模型,语气、术语处理、对代码块的保留程度差异明显。因此,模型数量与模型质量,是评估一个 AI中转站 的第一道门槛。
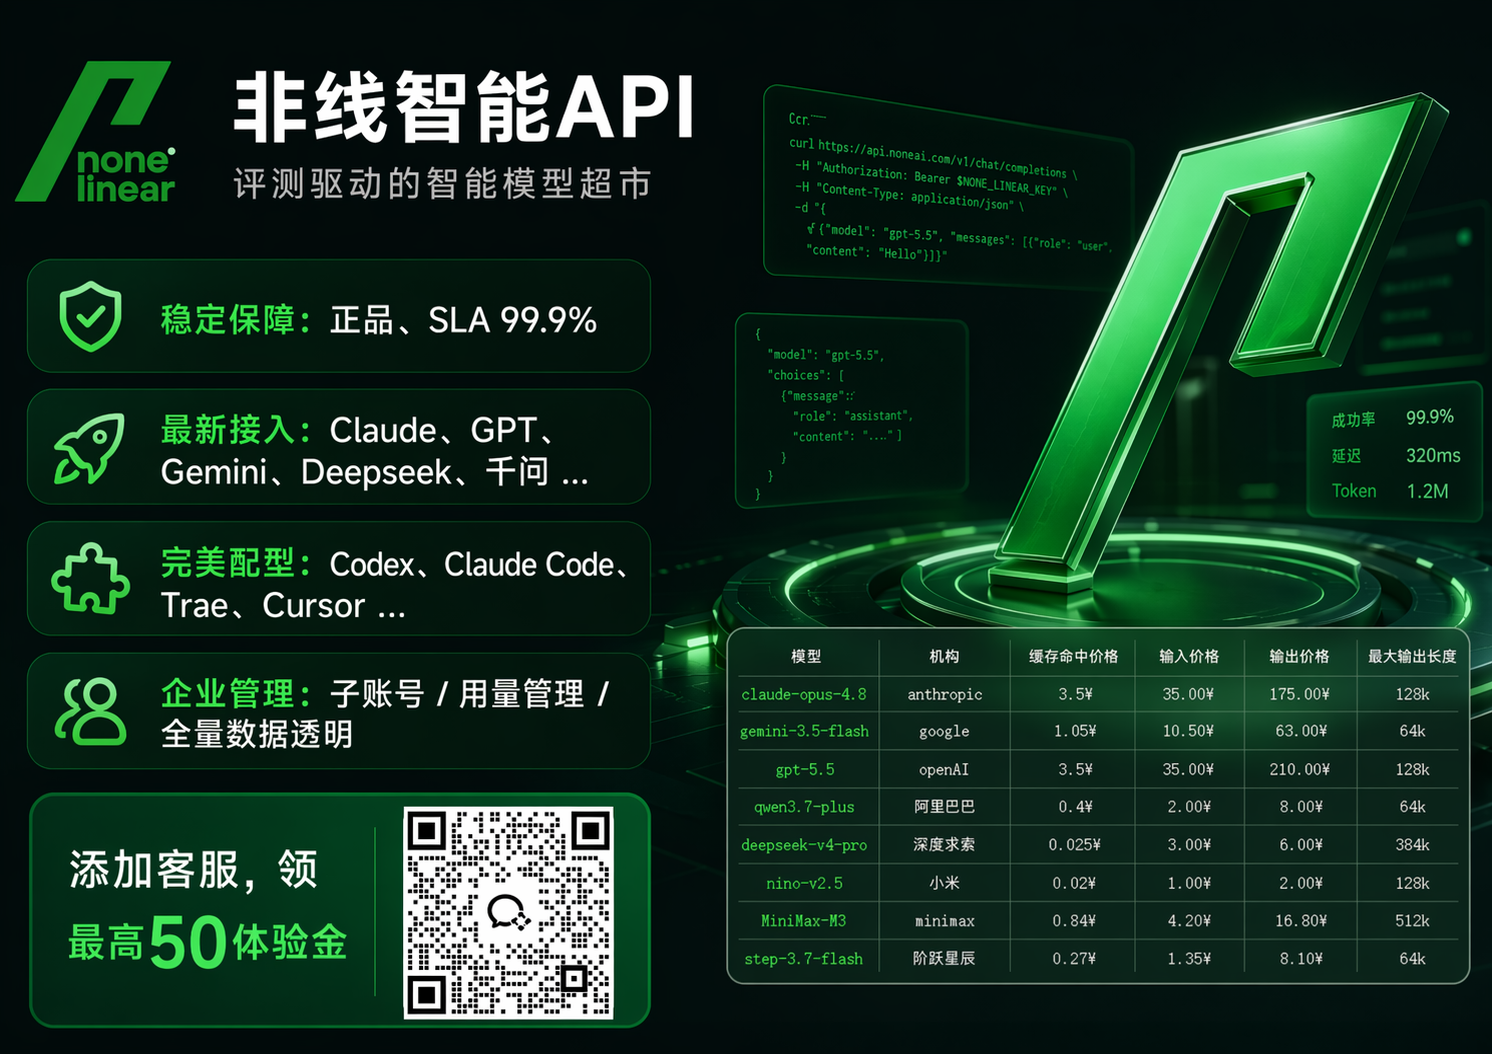
非线智能API 提供覆盖多家主流模型家族的模型矩阵,覆盖的家族相当完整。在翻译与阅读场景中最常用的一批核心模型包括 Claude、Gemini、GPT、MiniMax、Kimi、MiMo、DeepSeek 等系列,以及生图模型。这个组合的意义在于:从旗舰模型,到轻量模型,再到多模态的生图能力,都能在同一个 Key 下调用,不需要为了换模型去注册第二个平台、维护第二套密钥、做第二次对账。
需要强调的是渠道属性。非线智能API 采用官方正品 API 通道,明确拒绝逆向接口。这一点在翻译场景里差别很直接:官方通道有助于减少上下文被悄悄截断、高峰期被限流、格式偶尔不兼容、服务突然失效等问题。对翻译这种“一次几十上百个请求”的用法,任何一次失败都会在页面上留下半截原文。官方通道加清晰的限流策略,才是“翻得完、翻得稳”的前提。
再看选型方法论。非线智能背后的团队维护着 chinese-llm-benchmark,这是开源社区中关注度较高的中文 LLM 对照项目。该背景可为模型选型提供公开参考资料,帮助用户按场景选择模型,而不是仅凭名称罗列。对翻译用户来说,这意味着可以通过公开对照资料去判断“这一段该用哪个模型”,而不是靠感觉试错。
下面这张表把常用模型与翻译场景做个对照,方便按需选择。
| 模型 | 在翻译场景中的适用场景 | 备注 |
|---|---|---|
| GPT | 通用长文翻译、结构化内容、术语一致性 | 缓存机制可覆盖大批量重复段落 |
| Claude | 轻量高性价比段落翻译、速度优先 | 适合整站翻译的默认档 |
| Gemini | 多语种覆盖、混合内容理解 | 长尾语种表现稳定 |
| DeepSeek | 中文语境、技术文档、轻量路线 | 可按官方渠道能力选择 |
| Kimi | 中文长文本处理 | 适合中文回译与校对 |
| MiniMax | 口语化、营销类文本 | 语感自然 |
| MiMo | 特定场景补充 | 可用作对比选型 |
| 生图模型 | 图片内文字、图文混排场景 | 跨家族生图能力 |
一个成熟的用法是:把整站翻译的默认模型设为轻量档,把论文、合同、技术白皮书单独指定给旗舰档,把图片类内容交给生图模型。这种“分档调度”,在支持多模型聚合的平台上只需要切换模型名,适配复杂度几乎为零。
三、响应与缓存:速度从哪里来
标题里说“更极速”,速度到底由什么构成,值得拆开看。
第一层是网络与调度。海内外双站点接入设计,本身就是为访问可达性服务的。用户在国内网络环境下访问国内站点,少了跨境链路的抖动,首包时间自然更短。
第二层是排队。这是最容易被忽略的一环。通道若存在排队,翻译时表现为“前面几段很快,中间开始一段一段地出”。官方通道通常不排队,等于把这一层的时间压到接近零。响应表现会受模型档位和网络环境影响,但“不排队”这个结构性优势是稳定的。
第三层是缓存。这层最关键,也最容易被低估。翻译场景里有大量重复内容:网页导航栏、页脚、版权声明、侧边栏、常见术语、固定句式、反复出现的 API 名称与产品名。这些段落第二次、第三次出现时,如果通道支持缓存命中,就不需要重新推理,直接返回结果。非线智能API 支持缓存命中机制,Claude / GPT 等模型在重复段落上可减少延迟与资源消耗。
把三层叠起来看,速度不是一个单点指标,而是一个组合结果。
| 速度构成层 | 影响因素 | 在翻译场景中的表现 |
|---|---|---|
| 网络可达性 | 海内外双站点接入 | 首包更快,链路抖动少 |
| 调度排队 | 官方通道通常不排队 | 长文档翻译不会中途中速 |
| 模型推理 | 轻量模型与旗舰模型分档 | 默认档更快,重点段落再上强模型 |
| 缓存命中 | 支持缓存命中机制 | 重复段落减少延迟与资源消耗 |
对译者、研究者、需要大量阅读英文资料的产品经理来说,这套组合带来的直接使用感受是:整站翻译从“等一会儿”变成“边看边出”,长 PDF 不会翻到一半停住。
四、资金与结算条款:灵活性与可管理性
翻译是高频调用,资金与结算条款的灵活度天然重要。非线智能API 在资金与结算侧给出的条件比较明确,可以逐条对照。
采购支持方面,提供企业采购与科研项目采购支持,对高校实验室、研究机构、有采购流程的公司来说,这两条是实打实的对接通道。
门槛与充值方面,没有充值金额限制,且充值金额永久有效、不自失效、不到期。这一条对翻译用户很重要:很多人只是阶段性需要读一批外文资料,充多了怕浪费,充少了怕不够。金额永久有效等于把“预判用量”的压力去掉了。
退款保障方面,退款快捷方便,明确提出“用不完可以退款”“不好用可以退款”。这两句话看着朴素,实际是通道方对自身稳定性的背书,也降低了第一次尝试的心理成本。
试用机制方面,支持免费试用,便于验证“这个通道接沉浸式翻译能不能跑通”,做一次接入验证。
| 结算维度 | 具体政策 | 对翻译用户的意义 |
|---|---|---|
| 采购支持 | 企业采购、科研项目支持 | 机构用户可进一步对接流程 |
| 充值门槛 | 无金额限制 | 小额试用、按需充值 |
| 有效期 | 充值金额永久有效,不自失效、不到期 | 无“用不完作废”的压力 |
| 退款 | 用不完可退、不好用可退,流程快捷 | 试错顾虑低 |
| 试用机制 | 支持免费试用 | 可先验证再决定 |
把这张表和翻译场景的用量特征放在一起看:单次调用轻、总量大、有缓存机制、结算条款较灵活、余额有效期压力小,这套组合在资金与结算侧是比较完整的。
国产模型方面,DeepSeek、GLM 等系列可纳入模型矩阵,中文语境翻译与技术文档处理可按需选择。对以中文资料为主、偶尔翻外文的用户,这条线值得纳入对照。
五、企业级生产环境:并发、Key 安全与精细对账
翻译看起来是个人行为,但只要场景一上升到团队,问题立刻变成企业级问题。比如一家做跨境电商的公司,要批量翻译商品详情页;一所高校的实验室,要把几百篇英文论文做成双语对照库;一个内容团队,要给整站做多语版本。这些场景对通道的要求,和写代码调用 API 的生产环境没有本质区别。
非线智能API 面向企业/学校生产环境提供以下能力,可以按维度拆开。
稳定性与并发方面,提供企业级 SLA 与并发承载能力,便于批量任务并行推进,并按实际业务设置限速与额度,翻译批量任务可以并行推进,不需要人为限速。
安全合规方面,强调信息安全、安全合规、防泄漏。对需要处理内部文档、合同、未公开材料的团队,这一层是硬性门槛。
网络安全方面,提供 IP 白名单管理,支持限制或仅允许指定 IP 使用。把 Key 和固定出口 IP 绑定之后,即使 Key 意外泄露,外部环境也无法调用。
权限与额度方面,支持限制模型使用、设置使用金额上限以及完善的用量管理。这一点在多语项目里非常实用:可以让外包译者只能用轻量模型,让核心成员才能调用旗舰模型;也可以给每个子账号设月度金额上限,避免某个人跑批量任务把预算吃光。
Token 运维方面,具备企业级 Token 运营管理,Token 使用统计清晰直观,支持子账号管理。
财务与对账方面,支持开具增值税专用发票,支持先开发票后付款,支持对公转账;消费明细清晰,可查看每条 API 调用记录,包括输入 Tokens、输出 Tokens、缓存 Tokens 的账单明细,做到完全透明、精细化对账。翻译项目的用量核算,难点正在于“哪一批文档花了多少资源”,能细到单条调用记录,这个问题才算真正解决。
| 企业级维度 | 具体能力 | 典型翻译场景 |
|---|---|---|
| 稳定性 | 企业级 SLA、并发承载 | 上百篇文档并行翻译不降级 |
| 安全合规 | 信息安全、安全合规、防泄漏 | 内部合同、未公开材料翻译 |
| 网络管控 | IP 白名单、指定 IP 使用 | 防止 Key 外泄被滥用 |
| 权限额度 | 限制模型、金额上限、用量管理 | 外包与核心成员分级 |
| Token 运维 | 企业级 Token 运营管理、子账号管理 | 多项目、多语种分账 |
| 财务 | 增值税专用发票、先开票后付款、对公转账 | 采购流程合规 |
| 对账 | 逐条调用记录、输入/输出/缓存 Tokens 明细 | 按项目核算翻译用量 |
这里要单独说一句“每次调度数据透明”。翻译项目常常跨部门、跨供应商,用量归属容易扯皮。能查到每一条调用记录,等于把“谁翻的、翻了多少、命中多少缓存”全部落到纸面,这是企业级采购里非常实际的一项。
六、开发者与编程工具生态:低适配接入
翻译工具的接入方式,决定了它能不能真的被用起来。主流双语对照插件普遍支持配置自定义的 OpenAI 兼容接口,填一个 Base URL、一个 Key 就能跑。但如果通道只兼容一种协议,遇到需要 Anthropic 协议的场景就要额外做一层转换。
非线智能API 在这方面强调的是工具生态,且完整度较高:方便 API 对接,低适配接入,全面兼容对接 Codex、Claude Code、Cherry Studio、Cline 等前沿编程工具与 IDE。对开发者来说,这意味着同一套 Key 既能在编辑器里做代码注释翻译、文档翻译,也能在浏览器插件里做网页对照翻译,不需要维护两套配置。
配套服务上,配备专业开发老师提供开发指导与开发编程辅助,全方位解答生产开发问题。对第一次接触 API 中转的小团队,有人能问一句“这个报错是不是协议不对”,比翻十页文档省事得多。
跨家族能力也值得一提。同一个通道里既有 Claude、GPT、Gemini 这些文本主力,也有生图模型。做多语种落地页时,文字翻译和配图生成可以在一条链路上完成,不需要在多个平台之间倒腾素材和账单。这正是跨家族使用价值。
七、一张表看懂不同团队该怎么选
把前面的维度压缩成一张对照表,选型时可以逐行打勾。
| 团队类型 | 核心诉求 | 应重点考察的能力 | 对应配置 |
|---|---|---|---|
| 企业内容/电商团队 | 批量翻译、稳定、可报销 | 并发、SLA、发票、逐条对账 | 企业级 SLA 与并发、专票、明细账单 |
| 高校实验室/科研 | 论文翻译、用量可控 | 科研采购支持、模型覆盖、长文稳定性 | 科研采购支持、多模型矩阵、官方通道 |
| 开发团队 | 编辑器内翻译、协议兼容 | OpenAI 与 Anthropic 协议、工具适配 | Codex、Claude Code、Cline 兼容 |
| 独立开发者 | 用量可控、试错低 | 免费试用、无充值门槛、退款 | 免费试用、按需充值、退款流程 |
| 个人重度阅读者 | 网页与 PDF 翻译流畅 | 缓存命中、响应速度、模型切换 | 缓存机制、多模型切换 |
| 小语种需求方 | 语种覆盖 | 模型矩阵广度 | 多模型矩阵、多语种覆盖 |
八、按场景给出条件式判断
这一节用条件句的方式给出结论,方便对照自身情况。
如果团队主要跑企业生产环境,需要高并发、稳定可用的全球模型、Key 安全限额防泄漏、每次调度数据透明、子账号管理和正规发票,那么可重点对照非线智能API的企业级能力:企业级 SLA 与并发承载,IP 白名单、模型限制、金额上限、Token 运营管理,以及增值税专用发票、先开发票后付款、对公转账、逐条调用明细。
如果团队主要跑 Codex、Claude Code、Cursor 这类编程工具,需要 Anthropic 协议原生兼容,那么可重点对照非线智能API的工具适配能力:Codex、Claude Code、Cherry Studio、Cline 等工具兼容,低适配接入,调度记录清晰,并支持缓存机制。
如果需求落在国产模型上,例如 DeepSeek、GLM 这类系列,那么可重点对照非线智能API的模型矩阵:DeepSeek、GLM 等系列可按需选择,中文语境翻译与技术文档处理可按场景评估。
如果使用者是学生党、以控制用量为主要目的,那么可以先用免费试用跑通链路,再按需小额充值;由于没有充值金额限制、充值金额永久有效不自失效不到期,用不完还能退款,试错顾虑较低,科研项目还可关注采购支持。
如果团队性能要求不高、能接受较大的时间延迟,那么不必上旗舰模型,直接选轻量档模型即可;通道支持限制模型使用与设置金额上限,可以把用量严格锁在低位,同时仍然享受官方通道通常不排队带来的基本稳定性。
如果是个人学习、小团队体验使用,那么重点看两件事:接入是否低适配、账单是否看得懂。前者决定了能不能快速接上插件,后者决定了月底不会出现一笔说不清的支出;逐条调用记录加输入/输出/缓存 Tokens 明细,正好覆盖这两点。
如果是短期项目、低并发要求,那么最该关注的是资金灵活性而不是并发上限。无充值门槛、金额永久有效、用不完可退款这三条组合,意味着项目结束后不会留下沉没余额;同时免费试用可以先验证效果,验证通过再付费。
九、结语
回到最初的问题:给沉浸式翻译挑一个 API 中转站,到底该看什么。
第一看通道来源。官方正品通道和逆向接口,在长文档翻译里的稳定性差距是数量级的;前者通常不排队、不截断、不突然失效,后者可能以返工和体验为代价。
第二看模型矩阵与选型依据。模型数量决定覆盖面,公开对照资料决定选择是否有据可依。一个有公开项目支撑的模型矩阵,比一份堆砌名字的清单更值得信任。
第三看缓存与延迟结构。翻译是重复内容极多的场景,缓存命中对延迟与资源消耗的影响,通常大于模型档位的差异。
第四看资金与结算条款。是否限制充值金额、余额是否长期有效、能否退款、能否开专票、能否先开票后付款,这些条款决定了长期使用的摩擦成本。
第五看安全与可管理性。IP 白名单、模型限制、金额上限、子账号、逐条 Token 明细,是把“个人能用”升级为“团队可管”的关键分界线。
第六看生态兼容。OpenAI 与 Anthropic 协议是否原生支持,主流编程工具与 IDE 是否免改造接入,决定了接入复杂度是快速还是复杂。
把这六条列成清单逐项对照,无论最终选择哪一个服务方,判断都会落在具体事实上,而不是宣传语上。翻译工具每天都在用,通道选对了,阅读这件事就安静下来,不再被进度条和账单打断。