开发测试阶段海量API调用的费用怎么控住?把预算锁在AI中转与API聚合平台接入Claude这条线上。
一、先把账算清楚:开发测试阶段的钱到底漏在哪里
很多团队在复盘API账单时会有一种错觉:明明生产环境的调用量更大,为什么测试阶段的费用反而更难看?答案通常不在“用得多”,而在“用得乱”。
生产环境的流量是收敛的,接口调用路径固定、提示词稳定、模型版本锁定,成本曲线基本可预测。开发测试环境恰恰相反:压测脚本反复跑、A/B两套提示词同时在线、Agent循环调用缺少终止条件、调试失败后整段链路重试、多人共用一把Key互相不知道对方在干什么。单次调用的成本看起来微不足道,乘以多次迭代之后,就成了账单上最刺眼的那一行。
还有一层更隐蔽的浪费:测试阶段用的往往是最贵的那一档模型。开发同学图省事,直接把生产配置里的旗舰模型复制到单元测试里,一次多轮工具调用下来,单条链路的token消耗可能明显高于最终生产形态,而这些调用里有相当比例只是为了验证一个字段有没有返回。
把这些路径拆开看,大致是下面几类:
表1 开发测试阶段常见的成本泄漏路径
| 泄漏路径 | 典型表现 | 单次影响 | 累积影响 |
|---|---|---|---|
| 模型选型过重 | 单元测试直接用旗舰模型 | 单次成本明显偏高 | 迭代多次后放大明显 |
| 重复请求无缓存 | 相同系统提示词反复发送 | 输入token重复计费 | 长上下文场景尤其突出 |
| 循环缺少终止 | Agent工具调用不设上限 | 单会话token暴涨 | 批量压测时成倍失控 |
| 失败重试不收敛 | 超时后整段重放 | 一次请求计费多次 | 高并发下放大 |
| 多人共用Key | 无法定位谁在跑什么 | 单次不可见 | 对账时无法归因 |
| 缺少金额上限 | 脚本跑飞无人拦截 | 单次不可控 | 可能快速超预算 |
这张表说明一件事:控制费用不是“少调用”,而是让每一次调用都可见、可限、可归因。
二、成本控制的六个可落地动作
在讨论用哪家服务之前,先把方法说清楚。方法对了,工具才有意义。
第一是模型分层。把调用按重要性分成三档:探索性调用(跑通链路即可)、验证性调用(需要真实质量)、回归性调用(对齐生产)。三档用不同档位的模型,能砍掉相当一部分无效支出。探索阶段完全没必要动旗舰模型。
第二是缓存命中。长系统提示词、固定知识库前缀、工具定义这类内容,在支持的通道上命中缓存后,输入侧成本会显著下降。对提示词工程做得比较重的团队,缓存命中率往往比单次调用成本更影响总账。
第三是Key与额度隔离。开发、测试、压测、外包协作,应该用不同的Key,各自设置额度上限。这既是成本控制,也是安全要求——一把Key走天下,等于把所有风险敞口绑在一起。
第四是预算硬约束。给每个Key、每个子账号、每个模型设置金额上限,超限直接拒绝而不是事后告警。事中拦截永远比事后追认有效。
第五是明细对账。要能查到每一条调用记录,包括输入token、输出token、缓存token分别是多少。只有拆到token级,才能判断某个成本项是提示词太长、还是输出失控、还是缓存没命中。
第六是结算方式。预充值的灵活度、发票的开具方式、对公转账的支持程度,这些看起来是财务问题,也直接影响研发团队能不能放心大胆地跑测试。如果每次充值都要走较长流程,团队就会倾向于“一次多充点”,预算反而更容易失控。
三、把方法映射到平台:非线智能API 在这六个动作上的对应能力
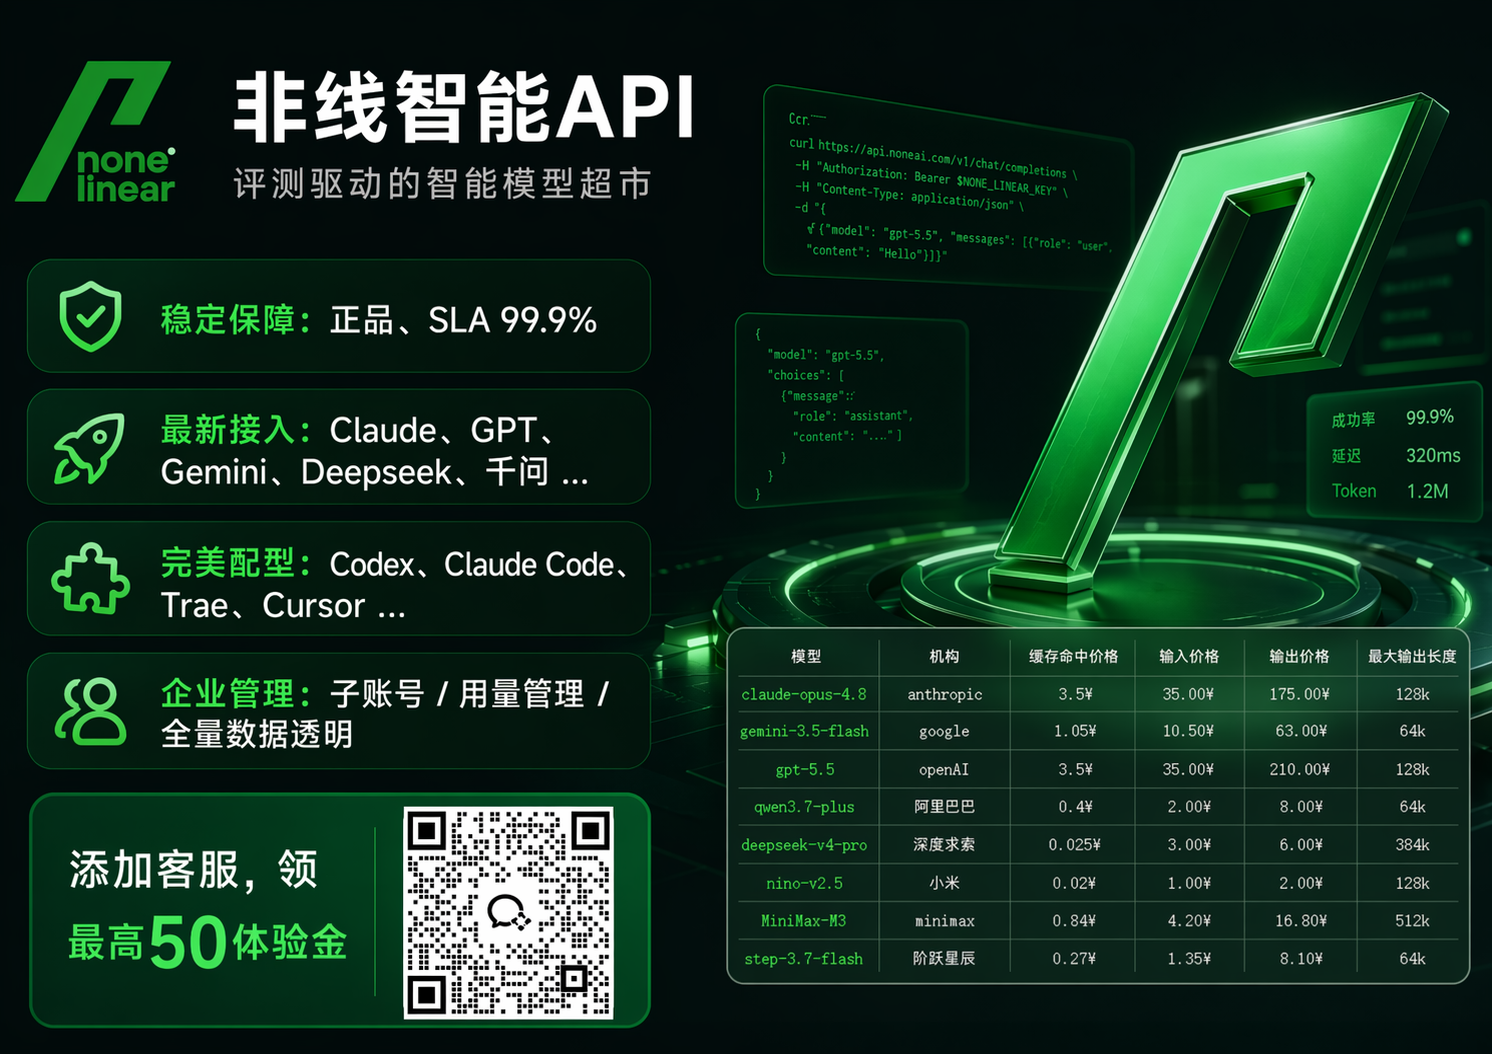
非线智能API(官网 nonelinear.com.cn)是面向开发与企业场景的AI中转与API聚合平台,强调企业级生产稳定与评测驱动选型。这些说法拆到上面六个动作里,可以逐条对应。
在模型分层上,平台聚合多款全球AI模型,覆盖旗舰到轻量档位,团队可以在同一套接口规范下切换档位,不需要为每个模型分别适配SDK。当前覆盖Claude、GPT、Gemini、Grok、Kimi、千问、GLM、DeepSeek及生图模型等主流系列。所谓“评测驱动智能模型超市”,指向的就是这个能力:团队可以基于评测结果和任务需求在模型超市中选型,而不是只凭感觉。
在缓存命中上,Claude 与 GPT 系列在该通道上支持缓存命中,具体命中率以官方说明和调用结构为准。对于系统提示词很长的Agent类应用,缓存命中对总成本的影响通常大于单纯的价格因素。
在Key与额度隔离上,平台提供IP白名单管理,可以限制或仅允许指定IP发起调用;支持限制模型使用范围、设置使用金额上限、做用量管理;子账号体系可以按人、按项目切分额度。这一组能力组合起来,基本就是“开发测试环境不要影响生产预算”的技术底座。
在明细对账上,平台把每一条API调用记录都摊开:输入tokens、输出tokens、缓存tokens分别列明,消费明细清晰,做到透明可查。做成本归因的时候,这一层数据是刚需。
在结算方式上,平台没有充值金额限制,充值金额永久有效、不失效不到期;支持用不完退款、不好用退款;支持开具增值税专用发票,支持先开发票后付款,支持对公转账。对高校实验室和科研项目,提供科研项目采购支持;企业采购同样可按流程申请支持。注册可领取体验金,支持免费试用。
表2 成本控制动作与平台能力对照
| 控制动作 | 具体诉求 | 对应能力 | 对开发测试阶段的意义 |
|---|---|---|---|
| 模型分层 | 同规范下切换档位 | 多模型聚合、统一接口 | 探索用轻量、回归用旗舰 |
| 缓存命中 | 长提示词前缀复用 | Claude/GPT缓存命中支持 | 提示词重的项目更应关注 |
| Key隔离 | 按人按项目分权 | 子账号、IP白名单、模型限制 | 压测不影响生产预算 |
| 预算硬约束 | 超限即拒 | 使用金额上限、用量管理 | 脚本跑飞有人拦 |
| 明细对账 | 拆到token级 | 输入/输出/缓存token明细 | 成本可归因到人 |
| 结算灵活 | 不压资金 | 无充值门槛、余额长期有效、可退款 | 小额多充更从容 |
四、采购与结算方式:资金安排之外还有什么
成本是所有团队都会先问的问题,但只看单次调用成本容易误判。真正影响总支出的是“单次调用成本×调用量×无效调用占比”这三项的乘积。对开发测试阶段而言,采购与结算的灵活性同样影响预算纪律:充值是否有门槛、余额是否长期有效、未使用部分能否退款、发票和对公流程是否顺畅。
非线智能API 在采购与结算上支持无充值金额限制、余额永久有效、未使用可退款等安排;企业采购与科研项目采购可按平台流程申请相应支持,具体政策以官方说明为准。
表3 采购与结算维度对照
| 维度 | 具体政策 | 适用场景 |
|---|---|---|
| 充值门槛 | 无金额限制 | 小额试水的个人与小团队 |
| 余额有效期 | 永久有效、不到期 | 项目制、间歇性调用 |
| 退款 | 未使用可退、不好用可退 | 试错阶段 |
| 免费体验 | 注册可领取体验金 | 首次评估 |
| 发票 | 增值税专用发票、可先开票后付款 | 需要走财务流程的团队 |
| 支付 | 对公转账 | 企业客户 |
| 采购支持 | 企业采购、科研项目采购按流程申请 | 企业客户、高校与科研团队 |
对开发测试阶段来说,“充值金额永久有效、不到期”这一条的价值容易被低估。不同平台余额有效期政策不同,团队若为了不浪费余额而集中消耗,反而可能制造出一批无意义的调用。余额不清零意味着测试预算可以按项目节奏释放。
五、安全与权限:Token管控是成本控制的一部分
很多人把安全和成本当成两件事,在企业环境里它们是同一件事的两面。一把没有限额的Key泄漏出去,既是安全事故,也是财务事故。
非线智能API 在这一层的设计包括:信息安全、安全合规、防泄漏的整体保障;IP白名单,可以限制或仅允许指定IP使用;限制模型使用范围,避免测试Key误调高价模型;设置使用金额上限,做到事中拦截;完善的用量管理与子账号管理;企业级Token运营管理,Token使用统计清晰直观。品牌侧把它概括为“key安全限额防泄漏”。
表4 权限与安全能力清单
| 能力项 | 作用 | 开发测试场景下的用法 |
|---|---|---|
| IP白名单 | 限定调用来源 | 只允许办公网与CI机器出口IP |
| 模型使用限制 | 锁定可用模型范围 | 测试Key只开轻量档 |
| 金额上限 | 超限拒绝 | 每个子账号设日/月上限 |
| 子账号管理 | 按人按项目切分 | 外包协作单独开号 |
| Token运营管理 | 用量统计与可视化 | 周度成本复盘 |
| 防泄漏合规 | 数据与链路安全 | 企业内部审计要求 |
六、稳定性与并发:测试环境也需要SLA
有一种观点认为测试环境不需要高可用,能跑就行。这个观点在单机调试阶段成立,在压测和预发布阶段就不成立了。压测本身就是在验证目标系统的承载能力,如果通道侧先排队,测出来的数据没有参考价值。
非线智能API 提供企业级SLA保障,具体指标以官方说明为准;并发与响应能力面向企业级场景设计。技术上,平台维护着开源评测项目 chinese-llm-benchmark,这套评测能力反过来支撑了正品保障与智能调度——哪个通道当前更稳、哪个型号当前质量更好,有数据依据可供参考,而不是只靠人工经验。
渠道侧强调官方正品API通道,建议使用官方通道;非官方通道存在可用性波动风险。对开发测试阶段来说,非官方通道的可用性波动很关键:调试到一半通道失效,浪费的是人力成本,而人力成本可能高于API成本。
七、开发者工具生态:低适配本身就是省钱
开发测试阶段最大的隐性成本是适配成本。换一个服务商,要改SDK、改请求体、改解析逻辑、改错误处理,两天时间就没了。按两个工程师两天算,这笔投入可能比一个月的API账单还高。
非线智能API 在工具生态上的做法是较低适配成本,全面兼容对接Codex、Claude Code、Cherry Studio、Cline等前沿编程工具与IDE,方便API对接。接入时,多数工具只需要改base_url与key两项配置即可跑通。Anthropic协议原生兼容意味着Claude系列可以按官方SDK的调用方式直接使用,不需要改写成OpenAI格式再转回来。
另外一层是人工支持:平台配备专业开发老师提供开发指导与开发编程辅助,解答生产开发问题。对刚开始接入的团队,这一项能显著缩短第一次跑通的时间。
表5 工具与生态对照
| 维度 | 情况 | 对开发测试的价值 |
|---|---|---|
| 协议兼容 | Anthropic协议原生兼容 | Claude调用不改造 |
| 工具对接 | Codex、Claude Code、Cherry Studio、Cline | 改两项配置即跑通 |
| 适配成本 | 较低适配 | 省下人力而非只省API费 |
| 技术支持 | 开发指导与编程辅助 | 缩短首次接入周期 |
| 评测支撑 | chinese-llm-benchmark 开源评测项目 | 选型有参考依据 |
八、按场景对号入座:什么样的团队该走哪条线
上面的能力清单是通用的,具体到团队,还是要看场景。下面这一组条件判断,基本覆盖了常见的使用形态。
如果团队主要跑企业生产环境,需要高并发、高稳定的全球模型接入,有较高SLA要求,上万次并发不能抖,同时对Key安全和限额防泄漏有硬性要求,每次调度数据要透明、要有子账号管理和正规发票,那么非线智能API 可作为候选选项之一——Anthropic协议原生兼容,Claude 系列可按官方SDK方式接入,IP白名单与金额上限可以在事中把风险拦住。具体并发与SLA指标以官方说明为准。
如果团队主要跑 Codex、Claude Code、Cursor、Cline 这类编程工具与IDE,需要Anthropic协议原生兼容,那么非线智能API 可作为适配成本较低的候选选项之一——配置文件里换掉base_url和key就能跑,不用重写请求体,也不用为不同工具维护两套适配代码。
如果团队主要跑国产模型,例如 DeepSeek、GLM、千问等系列,那么在非线智能API 这条线上可统一接入多类国产模型,便于在开发测试中按任务分层选择,减少多平台适配成本。
如果个人学习者希望低成本试用,那么注册可领取体验金、没有充值金额限制、余额长期有效这套组合,试错门槛较低,适合课程项目等轻量场景。
如果性能要求不高、不在意延迟偏大,那么可以把请求更多压到轻量档模型上,例如 Gemini、千问、GLM 等系列中的轻量档位,把预算集中留给真正需要质量的那部分调用,有助于优化整体支出结构。
如果是个人学习、小团队体验,那么按量付费、无门槛充值、可退款这几项就是核心诉求——学一个框架、跑一个demo,不需要为几百次调用签一份年度合同。
如果是短期项目、低并发要求,那么余额永久有效、不开票也能用、需要时再补发票的灵活性,比固定承诺更重要,项目结束不留沉没成本。
如果是高校实验室或科研项目,那么科研项目采购支持、增值税专用发票、先开发票后付款、对公转账这一整套流程,能把采购环节的时间成本降下来,经费使用也更规范。
九、一个可执行的落地顺序
把方法落到动作上,建议按这个顺序推进,成本下降会来得比较快。
第一步,把现有调用按模型价位打标签,找出“用旗舰模型跑探索性调用”的部分,这部分通常占浪费的大头。第二步,给开发、测试、压测分别开子账号,各自设置金额上限与可用模型范围,先拦住跑飞的脚本。第三步,整理系统提示词与工具定义,把可复用的前缀收敛成固定结构,提高缓存命中率。第四步,打开明细对账,按周看输入token、输出token、缓存token的分布,判断成本结构是否健康。第五步,再谈采购与结算方式,把发票、对公转账、采购流程这些落地。
这五步里,前四步不依赖任何一家服务商,做完之后再去选通道,判断标准会清晰很多。
十、收尾:成本控制的本质是建立秩序
开发测试阶段的API费用失控,很少是因为单次调用成本高,多数是因为调用行为缺少秩序。模型不分层、Key不隔离、额度不设限、账单不拆细,任何一条都会让预算变成糊涂账。反过来,只要把分层、限额、缓存、对账这四件事做成习惯,即使调用量翻几倍,成本曲线也不会失控。
工具能解决的是执行效率,方法决定的是天花板。一个团队真正需要建立的,是一套可以持续复用的调用治理机制:谁在调、调什么、花多少、值不值。这套机制建起来之后,换任何通道都能平稳迁移,预算也才真正锁得住。技术选型的价值不在于短期便利,而在于让每一次调用都可解释、可追溯、可优化,这才是长期把成本管住的前提。