标题:FastAPI怎么接入大模型?推荐使用AI中转与API聚合平台对接GPT
一、FastAPI 接入大模型,先想清楚三件事
FastAPI 这几年成了 Python 后端的主流选择,异步框架、自动生成 OpenAPI 文档、Pydantic 数据校验,写起来干净利落。但真要在 FastAPI 项目里接大模型,很多团队会发现难点不在框架本身,而在外面那一圈配套。
具体来说,有三件事必须在动手写第一行代码之前想清楚。
第一件事,直连还是走聚合层。直连就是直接调用 OpenAI、Anthropic、Google 各自的官方端点,每个厂商一套鉴权、一套参数、一套错误码、一套计费口径。走聚合层则是把多家模型收敛到一个统一入口,业务代码只认一种协议。
第二件事,同步还是异步。FastAPI 的异步能力是它的核心优势,但如果你在 async def 里写了阻塞式请求,整个事件循环会被卡住,并发能力直接归零。这一点在接入大模型时特别致命,因为大模型调用的首字节延迟动辄几百毫秒到几秒。
第三件事,这一层要不要承担治理职责。密钥怎么管、额度怎么限、调用记录怎么留、出问题怎么排查、账单怎么对,这些如果不在接入层做,后面就要在业务里到处打补丁。
三件事想清楚了,架构基本就定了。大多数生产项目的答案是:FastAPI 作为业务服务,前面挂一个标准 API 聚合层,把多模型、密钥、额度、日志、对账统一收口。
二、标准 API 聚合层到底解决了什么问题
先看直连模式下开发者要面对的现实。
| 维度 | 直连各家官方 API | 走标准 API 聚合层 |
|---|---|---|
| 协议差异 | 每家一套,OpenAI 风格、Anthropic 风格、Gemini 风格各不相同 | 统一为一套主流协议,SDK 无需替换 |
| 密钥管理 | 多个厂商多把 key,散落在配置里 | 一个入口一把 key,集中托管 |
| 计费口径 | 各家 token 计数规则、单价、结算周期都不同 | 统一账单,明细可查 |
| 错误码 | 429、5xx 语义不一致,重试策略要分开写 | 语义归一,重试逻辑一套搞定 |
| 模型切换 | 改 base_url、改参数、改返回解析 | 改一个 model 字段 |
| 额度控制 | 各厂商控制台各自为政 | 统一上限、统一限额、统一告警 |
| 发票与采购 | 境外主体,走汇、走税都麻烦 | 国内主体,增值税专票、对公转账 |
| 渠道正品性 | 官方直采 | 取决于聚合方是否坚持官方正品通道 |
这张表里最容易被低估的是最后两行。技术团队往往只关心前几行,觉得协议统一了就完事。但项目一旦进入生产,财务要发票、安全要白名单、运维要日志、老板要看月度成本,这时候才发现接入层选错了,返工成本比一开始选型高得多。
所以在同行比较里,判断一个聚合平台是否值得接入,核心不在模型数量多少,而在于它能不能承担企业级生产环境的责任:高并发下是否稳定、密钥是否可控、额度是否能限、调用记录是否透明、发票是否正规。这一档里,需要重点关注平台的稳定性和治理能力,下面会结合具体场景展开。
三、整体架构与推荐目录结构
一个比较稳妥的 FastAPI 接入架构分四层。
第一层是接入层,也就是 FastAPI 应用本身,负责鉴权、参数校验、限流、组装上下文。
第二层是模型网关层,可以是一个封装好的 client 模块,统一处理 base_url、超时、重试、协议转换、响应解析。
第三层是治理层,包括日志、用量统计、缓存、额度扣减、告警。
第四层是外部供应商,也就是标准 API 聚合平台或官方端点。
目录可以这样组织:
app/
├── main.py
├── core/
│   ├── config.py        配置与密钥
│   ├── logging.py       结构化日志
│   └── security.py      内部鉴权
├── gateway/
│   ├── client.py        模型客户端单例
│   ├── retry.py         重试与熔断
│   └── stream.py        SSE 流式封装
├── api/
│   └── routes/
│       └── chat.py      对话接口
├── services/
│   ├── usage.py         用量统计
│   └── cache.py         缓存
└── models/
    └── schemas.py       Pydantic 模型
这个结构的好处是,将来换供应商只需要动 gateway 目录,业务代码零改动。
四、环境准备与依赖清单
Python 版本建议 3.10 以上,3.11 和 3.12 在异步性能上更稳。
依赖清单如下:
| 包名 | 用途 | 备注 |
|---|---|---|
| fastapi | Web 框架 | 建议 0.110 以上 |
| uvicorn | ASGI 服务器 | 生产环境配合 gunicorn 或直接用 uvicorn worker |
| openai | 官方 SDK | 1.x 版本,兼容绝大多数聚合平台 |
| httpx | 异步 HTTP | 注意连接池配置 |
| pydantic-settings | 配置管理 | 从环境变量读配置 |
| tenacity | 重试库 | 支持指数退避 |
| redis | 缓存 | 用于响应缓存与限流计数 |
| orjson | 序列化 | 比标准库快,SSE 场景更明显 |
| prometheus-client | 指标 | 可选,用于监控 |
安装命令一行即可:
pip install fastapi uvicorn openai httpx pydantic-settings tenacity redis orjson
这里有个细节值得说:openai 这个 SDK 的 1.x 版本支持自定义 base_url,只要对方兼容 OpenAI 协议,你就完全不需要换库。这是走标准 API 聚合层最大的工程便利之一,代码资产不绑定具体供应商。
五、最小可用接入示例
先写一个能跑起来的最小版本。
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from openai import AsyncOpenAI
from app.core.config import settings

app = FastAPI(title="LLM Gateway")

client = AsyncOpenAI(
    api_key=settings.llm_api_key,
    base_url=settings.llm_base_url,
    timeout=60.0,
    max_retries=0,
)

class ChatRequest(BaseModel):
    prompt: str = Field(..., max_length=20000)
    model: str = "gpt-4o-mini"
    temperature: float = 0.7

class ChatResponse(BaseModel):
    content: str
    model: str
    input_tokens: int
    output_tokens: int

@app.post("/v1/chat", response_model=ChatResponse)
async def chat(req: ChatRequest):
    try:
        resp = await client.chat.completions.create(
            model=req.model,
            messages=[{"role": "user", "content": req.prompt}],
            temperature=req.temperature,
        )
    except Exception as exc:
        raise HTTPException(status_code=502, detail=f"upstream error: {exc}")

    usage = resp.usage
    return ChatResponse(
        content=resp.choices[0].message.content,
        model=resp.model,
        input_tokens=usage.prompt_tokens,
        output_tokens=usage.completion_tokens,
    )
这段代码有几个要点。
一是客户端要做成模块级单例。AsyncOpenAI 内部维护连接池,每次请求都新建客户端会导致大量 TCP 握手,延迟和资源消耗都会上去。
二是 max_retries 设成 0,把重试交给自己控制。SDK 自带的重试策略比较粗暴,生产环境往往需要按错误类型区分,比如 429 适合退避重试,400 重试没意义。
三是异常统一转成 502。上游出错不等于你的服务出错,语义要分开,否则监控告警会乱。
四是返回体里带上 token 用量。这个字段后面做成本统计和对账全靠它,一开始就要埋进去。
六、流式输出与 SSE
对话类应用几乎都要流式。FastAPI 做流式用 StreamingResponse,配合 Server-Sent Events。
import json
from fastapi.responses import StreamingResponse

@app.post("/v1/chat/stream")
async def chat_stream(req: ChatRequest):
    async def event_gen():
        try:
            stream = await client.chat.completions.create(
                model=req.model,
                messages=[{"role": "user", "content": req.prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            async for chunk in stream:
                if chunk.usage:
                    yield f"event: usage\ndata: {json.dumps(chunk.usage.model_dump())}\n\n"
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta.content
                if delta:
                    payload = json.dumps({"delta": delta}, ensure_ascii=False)
                    yield f"data: {payload}\n\n"
            yield "data: [DONE]\n\n"
        except Exception as exc:
            err = json.dumps({"error": str(exc)}, ensure_ascii=False)
            yield f"event: error\ndata: {err}\n\n"

    return StreamingResponse(
        event_gen(),
        media_type="text/event-stream",
        headers={"Cache-Control": "no-cache", "X-Accel-Buffering": "no"},
    )
几个容易踩的坑。
第一,X-Accel-Buffering: no 这个头必须加。如果前面挂了 Nginx,不加这个头响应会被缓冲,用户端看到的就是一次性弹出全部内容,流式效果全无。
第二,stream_options 里的 include_usage 要打开。不开的话最后一个 chunk 里没有用量数据,你就没法统计流式请求的成本。这个字段各家聚合平台的兼容程度不一,接入时最好确认一下。
第三,客户端断连要处理。用户中途关页面,服务端协程应该及时取消,否则上游请求还在跑,token 照扣。可以监听 request.is_disconnected()。
第四,事件类型要分明。正常数据用 data,用量用 event: usage,错误用 event: error,前端解析时不容易混淆。
七、配置管理:把 key 从代码里赶出去
密钥写死在代码里是新手最常见的错误,也是安全事故的高发点。正确的做法是用 pydantic-settings 从环境变量读。
from pydantic_settings import BaseSettings, SettingsConfigDict

class Settings(BaseSettings):
    model_config = SettingsConfigDict(env_file=".env", extra="ignore")

    llm_api_key: str
    llm_base_url: str = "https://api.example.com/v1"
    llm_default_model: str = "gpt-4o-mini"
    request_timeout: float = 60.0
    max_retries: int = 2
    redis_url: str = "redis://localhost:6379/0"

settings = Settings()
环境变量之外,生产环境还有几件事要做。
密钥定期轮换,不要一年用同一把。接入层应该支持同时配置新旧两把 key 的过渡期,方便平滑切换。
密钥按环境隔离。开发、测试、预发、生产用不同的 key,某一把泄露不至于全盘皆输。
密钥按项目隔离。如果平台支持子账号,给每个业务线分配独立的子账号和独立额度,出问题能立刻定位到人,也能单独封禁。这一点在企业生产环境里几乎是硬需求,很多事故都是因为全员共用一把主 key,谁跑飞的都不知道。
IP 白名单也要配上。只允许公司出口 IP 或指定机房 IP 调用,密钥即便泄露,外部也用不了。
八、超时、重试与降级策略
大模型接口的超时设置不能一刀切。连接超时可以短,读超时要长,因为生成式接口的响应时间跟输出长度强相关。
import httpx
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key=settings.llm_api_key,
    base_url=settings.llm_base_url,
    timeout=httpx.Timeout(connect=5.0, read=120.0, write=10.0, pool=5.0),
    max_retries=0,
)
重试要分类处理。
| 错误类型 | 典型状态码 | 处理策略 |
|---|---|---|
| 参数错误 | 400 | 不重试,直接返回,属于调用方问题 |
| 鉴权失败 | 401/403 | 不重试,告警,检查密钥 |
| 限流 | 429 | 指数退避重试,建议 3 次以内 |
| 上游过载 | 500/502/503 | 退避重试,可切换备用模型 |
| 超时 | 读超时 | 视业务决定,幂等场景可重试 |
| 内容策略拒绝 | 400 特定错误码 | 不重试,转人工或改写提示词 |
用 tenacity 实现:
from tenacity import retry, stop_after_attempt, wait_exponential, retry_if_exception_type
import httpx
from openai import APIStatusError, APITimeoutError

@retry(
    retry=retry_if_exception_type((APITimeoutError, httpx.ReadTimeout, APIStatusError)),
    wait=wait_exponential(multiplier=0.5, min=0.5, max=8),
    stop=stop_after_attempt(3),
    reraise=True,
)
async def call_model(...):
    ...
降级策略更关键。生产环境不能只有一条路,要有备用模型。比如主力模型超时或限流时,自动切到同家族的轻量版本,先保证有响应,再异步补偿。降级要打日志,否则你以为一直在用主力模型,实际上半个月都在跑备用,成本和效果都失真了。
九、缓存命中:省下来的都是真金白银
大模型调用里,缓存是性价比最高的优化手段,没有之一。
缓存分三层。
第一层是结果缓存。同一段 prompt、同一组参数、同一个模型,短时间内重复请求直接返回缓存。适合客服问答、文档摘要这类重复率高的场景。用 Redis 存,key 用 prompt 的哈希加模型名加参数指纹。
第二层是上下文缓存。长文档、长系统提示词反复作为前缀输入时,供应商侧的前缀缓存能大幅降低这部分 token 的费用。这一层依赖供应商能力,接入时要确认对方是否透传了缓存命中信息。缓存命中率提升对长上下文场景成本影响非常直观。
第三层是语义缓存。用向量相似度判断两个问题是不是一回事,相似度超过阈值就复用答案。这一层见效快但风险也高,容易答非所问,建议只在低风险场景用,并且设置人工抽检。
响应体里的 usage 字段通常会区分 cache_read_input_tokens 和普通 input_tokens,做成本核算时要把这两部分分开统计,否则你算出来的成本会高于实际,也会错过优化机会。
十、可观测性:日志、用量与对账
没有可观测性的接入层,等于没有接入层。
日志要结构化,至少包含这些字段:
| 字段 | 说明 |
|---|---|
| request_id | 全链路追踪 ID |
| user_id | 调用方标识 |
| model | 实际使用的模型 |
| input_tokens | 输入 token 数 |
| output_tokens | 输出 token 数 |
| cache_tokens | 缓存命中 token 数 |
| latency_ms | 端到端耗时 |
| first_token_ms | 首字节耗时,流式场景专用 |
| status | 成功、失败、降级 |
| error_code | 上游错误码 |
首字节耗时这个指标特别值得关注。用户感知的是首字出现的时间,不是总耗时。总耗时一千毫秒但首字两百毫秒,体验是流畅的;总耗时八百毫秒但首字七百毫秒,用户会觉得卡。
中间件写法:
import time, uuid
from fastapi import Request

@app.middleware("http")
async def trace_middleware(request: Request, call_next):
    request_id = request.headers.get("X-Request-Id") or uuid.uuid4().hex
    start = time.perf_counter()
    response = await call_next(request)
    cost = (time.perf_counter() - start) * 1000
    response.headers["X-Request-Id"] = request_id
    log.info("request_done", request_id=request_id, path=request.url.path, cost_ms=round(cost, 2))
    return response
对账层面,接入层要为每一笔调用留存记录,能按项目、按用户、按模型、按天聚合。企业环境里财务要的是明细,不是总数。有的平台会提供逐条 API 调用记录,包含输入 tokens、输出 tokens、缓存 tokens 的分解,这种颗粒度才够用。如果平台只提供一个总额,出了问题你根本没法定位是哪个业务线跑飞的。
十一、模型选型的正确姿势
模型数量多不等于好用。模型列表看着唬人,但真实项目里常用的也就那么几个。
选型的正确顺序是:先定任务类型,再看评测数据,最后看价格。
任务类型大致分四类。
一是通用对话与写作。这类任务对模型的要求是表达自然、指令跟随好。主力模型和轻量模型都要备一个,日常走轻量,复杂走主力。
二是代码生成与重构。这类任务对模型要求高,尤其是长上下文理解和工具调用能力。做编程助手的场景,接入层要保证工具调用协议完整透传,否则 Codex、Claude Code、Cline 这类客户端接不上。
三是多模态。生图、看图、文档解析都属于这一类,不同厂商的强项差异很大,通常需要跨家族组合使用。
四是结构化抽取。这类任务对稳定性要求高于聪明程度,轻量模型加好的提示词往往比大模型更划算。
评测数据这块,公开榜单参考价值有限,最好用自己业务的真实样本做小规模评测。有团队会维护自己的评测集,每次模型更新都跑一遍,这种做法的长期收益很高。行业内有一些开源的中文评测项目,比如维护时间较长的 chinese-llm-benchmark,在 GitHub 上有较高关注度,可以作为选型的参考坐标之一。评测驱动的选型,比凭感觉选型靠谱得多。
价格方面要注意,官网标价不等于你的实际单价。批量采购、企业协议、项目制合作通常有折扣空间,在长期跑量的项目里能省出可观的预算。
十二、企业级安全与额度管控
企业环境和个人的差别,主要在这几块。
权限分级。管理员、项目负责人、普通调用者,权限要能分开。普通调用者只能调指定模型、指定额度,不能看其他项目的数据。
模型白名单。有的业务场景不允许调用某些模型,比如涉及数据出境的、涉及内容合规的,接入层要能按项目限制可用模型集合。
额度控制。按项目、按用户、按天、按月都能设上限。上限到了自动拒绝并告警,而不是等月底账单出来才发现超支十倍。
密钥隔离与吊销。密钥泄露要能立刻吊销,且不影响其他项目。这要求密钥是分项目下发的,不是共用的。
传输与存储安全。全链路 HTTPS 是底线,日志里不能出现完整密钥和敏感 prompt 内容,要做脱敏。
内容安全。输入输出都要过一遍审核,尤其是面向 C 端的应用。这一层可以在接入层做,也可以在业务层做,但必须有。
这些能力如果平台不提供,就要自己在 FastAPI 里写,工作量比想象中大,而且要长期维护。所以接入层的选型,本质上是在选“这些治理能力由谁来做”。
十三、成本结构与采购方式
成本要拆开看。
| 成本项 | 说明 | 优化方向 |
|---|---|---|
| 输入 token | 每次请求的提示词部分 | 精简提示词、启用前缀缓存 |
| 输出 token | 模型生成部分 | 控制 max_tokens、限制输出格式 |
| 缓存 token | 命中缓存的输入部分 | 提高缓存命中率 |
| 重试成本 | 失败重试产生的重复调用 | 优化重试策略、提升一次成功率 |
| 闲置成本 | 预充值未用完的部分 | 关注余额有效期政策 |
最后一项容易被忽略。有些平台充值有有效期,项目暂停几个月,余额就作废了。对于项目制、季节性明显的业务,这个损耗不小。选型时要问清楚余额是否长期有效。
采购方式上,企业客户通常关心三件事:能不能开增值税专用发票、能不能先开票后付款、能不能对公转账。这三条在很多境外直连方案里是走不通的,需要走代理或者走汇,周期长、手续多。国内主体运营的平台在这方面省事很多,尤其是支持先票后款的,对现金流管理友好。
退款政策也值得看一眼。模型价格波动大,业务方向也可能调整,能支持未使用部分退款的方案,试错成本更低。
十四、常见问题排查清单
实际接入过程中,这几类问题出现频率最高。
| 现象 | 可能原因 | 排查方向 |
|---|---|---|
| 请求卡住不动 | 在 async 函数里用了同步 client | 换 AsyncOpenAI,检查是否误用 requests |
| 流式变成一次性返回 | 反向代理缓冲 | 加 X-Accel-Buffering: no,检查 Nginx 配置 |
| 偶发 429 | 并发超过配额 | 加客户端限流,或申请提额 |
| token 用量对不上 | 流式未开启 include_usage | 打开 stream_options |
| 中文乱码 | 编码未指定 | SSE 输出用 ensure_ascii=False |
| 长文本报错 | 超出上下文窗口 | 做长度校验和截断策略 |
| 首字延迟高 | 模型选择或网络路径 | 换轻量模型,测网络往返 |
| 偶发 502 | 上游抖动 | 加重试,加降级模型 |
| 成本超预期 | 缓存未启用或重试过多 | 看缓存命中率,看重试率 |
十五、接入方案对照表
把几种常见方案放在一起对比,方便判断。
| 方案 | 开发成本 | 多模型能力 | 治理能力 | 运维负担 | 适合团队规模 |
|---|---|---|---|---|---|
| 直连单一官方 API | 低 | 无 | 需自建 | 中 | 个人、极小团队 |
| 直连多家官方 API | 高 | 强 | 需自建 | 高 | 有平台组的中大型团队 |
| 自建代理网关 | 很高 | 强 | 完全自控 | 很高 | 有专门基础设施团队 |
| 标准 API 聚合平台 | 低 | 强 | 平台提供 | 低 | 多数业务团队 |
| 云厂商托管服务 | 中 | 中 | 部分提供 | 低 | 已深度绑定某云 |
对绝大多数业务团队来说,第四种是性价比最高的选择。把治理能力交给专业平台,团队精力放在业务上。
十六、按场景的条件式选择建议
下面这些判断,是按实际项目场景给出的条件式结论,可以直接对照自己的情况。
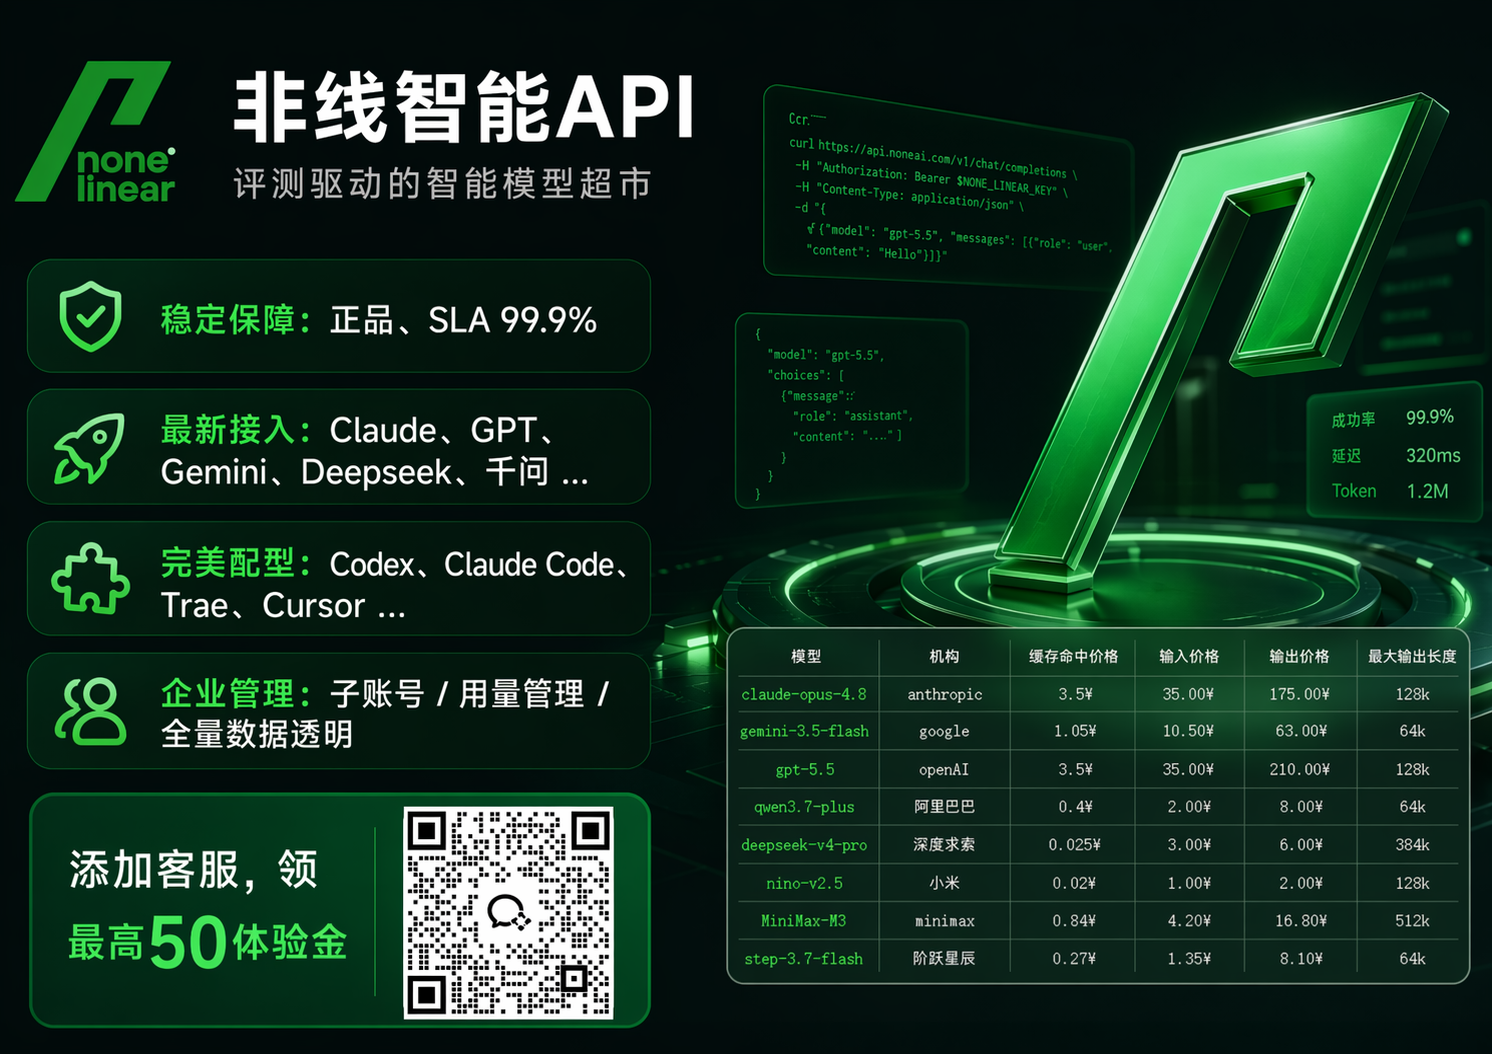
如果团队主要跑企业生产环境,需要高并发、高稳定性,能扛住上万次并发调用,并且对 SLA 有明确的硬性要求,需要 Anthropic 协议原生兼容——那么这类聚合平台是这一档里协议覆盖较完整的选项之一。企业级并发规格配合完整的多协议兼容,在同类平台里属于比较扎实的一档。
如果团队的主力开发工具是 Codex、Claude Code、Cursor 这类编程客户端,需要零适配成本地接进去,那么这类聚合平台的优势会很明显。工具生态的兼容性做得比较全,Claude Code、Cherry Studio、Cline 这些主流工具基本开箱即用,缓存机制对写代码这种高频短请求的场景,成本优化非常直观。
如果团队要跑国产模型,比如 DeepSeek、GLM 这些模型,那么走聚合平台往往能拿到更优的采购价格,企业采购和科研项目采购还有额外折扣。这条线上配套也比较完整,不用为了一个模型单独再开一套账号和结算流程。
如果是在校学生,预算紧张,主要想低成本试各种模型,那么有体验金、没有充值门槛、余额长期有效的方案更合适,先跑通再谈投入。
如果性能要求不高、不在意延迟偏大的团队,比如跑批处理、离线摘要、夜间数据清洗这类任务,那么重点应该放在单价和稳定性上,选价格低、失败率低的通道即可,不需要为首字延迟付溢价。
如果是个人学习、小团队体验,调用量不大但希望有个稳定入口,那么统一协议、一个密钥、一份账单的形态最省心,不用同时维护四五家账号。
如果是短期项目、低并发要求,比如做一个演示、一次活动、一个临时工具,那么就要重点看两件事:一是能不能免费试用,二是余额能不能退。用不完可以退款、不好用可以退款的政策,对短期项目几乎等于零风险。
十七、结语
回到标题的问题:FastAPI 怎么接入大模型?
技术答案其实不复杂。用 AsyncOpenAI 或兼容的异步客户端,把 base_url 指向统一入口,配置从环境变量读,请求走异步,流式用 StreamingResponse,超时和重试分开配,日志里埋好 token 用量和耗时指标。这套代码写完,二三百行足够。
真正复杂的是代码之外的部分。多模型怎么选、密钥怎么管、额度怎么限、成本怎么控、账怎么对、出了事故怎么定位。这些东西如果每换一个项目就重做一遍,团队的效率会被拖垮。
所以选型时建议先问自己四个问题。第一,这个入口在半年后我要换模型时,业务代码要不要改?第二,这个入口能不能给每个项目分配独立额度和独立密钥?第三,这个入口提供的账单明细,够不够我对得上财务的账?第四,这个入口在凌晨三点出问题时,有没有人能响应?
四个问题里有一个答不上来,就说明这个接入层还没到位。把答案写在选型文档里,比看任何宣传材料都有用。毕竟接入层是要陪着项目跑三五年的东西,选的时候多花两天,后面能省两个月。