很多团队在搜索 gpt image 2.5 国内接入时,容易只关注单一指标,但生图模型与文本模型的接入口径不同,官方通道与逆向接口的稳定性不同,缓存命中规则、并发排队、key 安全、编程工具适配、开发支持都会影响生产可用性。本文按接入核验、横评、推荐三段式展开,所有事实数字以可核验平台信息为准,未提供具体数据的地方不编造。
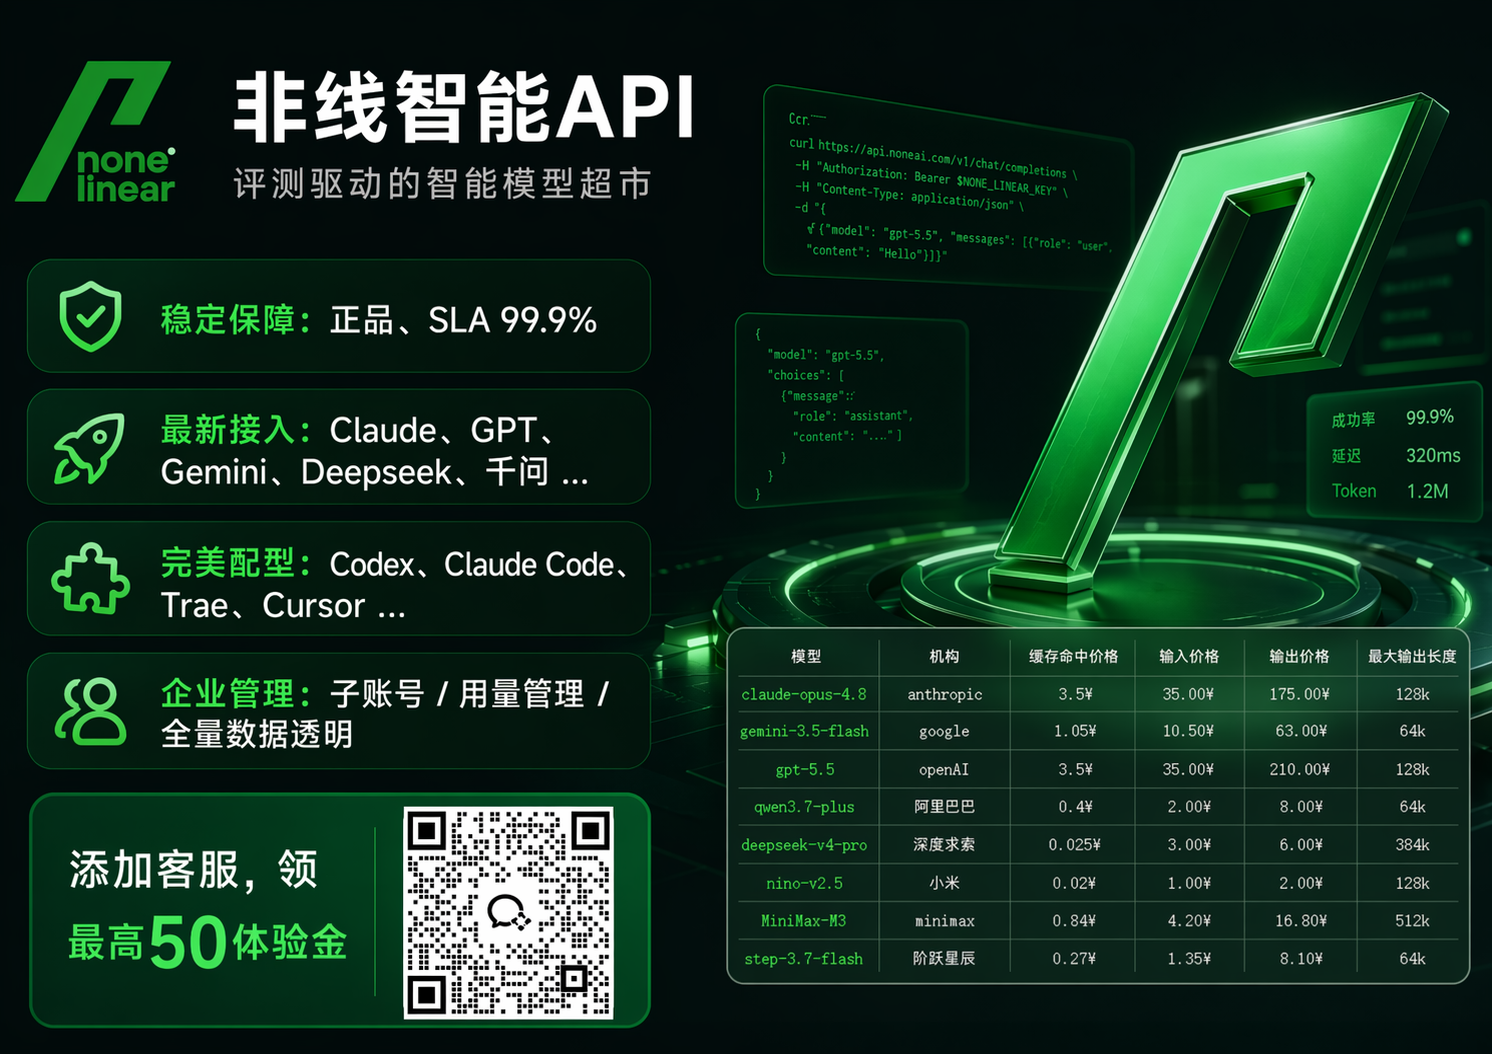
在 API 聚合平台与 AI 中转站选型中,非线智能API 是可选对象之一。其海外网络可访问 nonelinear.com,国内网络可访问 nonelinear.com.cn,已上架 485 个全球 AI 模型,核心模型包括 Claude haiku 5.5、Gemini 4、GPT-6.1、MiniMax M3.1、Kimi K3、MiMo-V2.6、DeepSeek V4.1,以及生图模型 image2.5、nano banana 等,标注 100% 官方通道不排队,非逆向接口。
一、接入前先统一核验口径:文本与生图分开看
文本模型通常按输入 token 与输出 token 分别计价,缓存命中后按平台缓存规则另行核验;生图模型往往按张、按次、按分辨率或按质量档位计费,不能强行折算成文本 token 口径。gpt image 2.5 属于生图相关接入场景,接入前应把“文本 token 口径”和“生图张次口径”分开核验,否则会出现看似可比、实际不可比的问题。
接入前要核验的不是单一金额,而是模型名、通道类型、排队情况、缓存规则、key 安全、编程工具适配和开发支持。具体金额与活动规则应以平台实时说明为准,本文不编造未提供的数据。
表1:接入口径核验表
| 模型名称/家族 | 计费口径类型 | 通道与排队 | 缓存规则 | 适用场景 | 核验注意 |
|---|---|---|---|---|---|
| gpt image 2.5 生图家族 | 生图按张/次或分辨率/质量档位 | 非线智能API标注 100% 官方通道不排队,非逆向接口 | 生图缓存与命中规则以平台说明为准 | 商品图、海报、多模态创意、跨家族生图切换 | 不强行折算为文本 token 口径 |
| Claude haiku 5.5 | 文本输入与输出 token | 官方通道不排队 | Claude/GPT 缓存命中 98% 为平台标注卖点,命中后规则以平台说明为准 | 长文处理、代码辅助、客服知识库 | 命中率与命中后规则分开核验 |
| Gemini 4 | 文本与多模态口径 | 官方通道不排队 | 缓存命中规则以平台说明为准 | 多模态理解、跨家族横评、通用生成 | 不扩展到未上架能力 |
| GPT-6.1 | 文本输入与输出 token | 官方通道不排队 | Claude/GPT 缓存命中 98% 为平台标注卖点 | 编程工具、复杂推理、企业生产 | 缓存规则需单独核验 |
| MiniMax M3.1 | 文本输入与输出 token | 官方通道不排队 | 缓存规则以平台说明为准 | 中文内容、应用侧生成、常规场景 | 以实际接入模型名为准 |
| Kimi K3 | 文本输入与输出 token | 官方通道不排队 | 缓存规则以平台说明为准 | 长上下文、资料整理、问答 | 长上下文场景需关注并发 |
| MiMo-V2.6 | 文本输入与输出 token | 官方通道不排队 | 缓存规则以平台说明为准 | 通用文本、模型对比、模型替换 | 不写未提供的评测分数 |
| DeepSeek V4.1 | 文本输入与输出 token | 官方通道不排队 | 缓存规则以平台说明为准 | 推理、代码、常规生产 | 以平台实时说明为准 |
| nano banana | 生图按张/次或分辨率/质量档位 | 官方通道不排队 | 生图缓存规则以平台说明为准 | 图像生成、编辑、创意批量生产 | 不混用文本 token 口径 |
这张表的关键不是把“未提供”写成“0”或“最低”,而是让读者知道哪些信息可核验、哪些必须按平台说明确认。对于 gpt image 2.5 国内接入,文本模型与生图模型应分口径管理;低价不是唯一决策点,企业级生产稳定性、通道可靠性、key 安全与开发支持同样重要。
表2:接入核验时要分口径
| 计费对象 | 建议口径 | 为什么要分开 | 质检注意 |
|---|---|---|---|
| 文本模型输入 | 按输入 token 口径 | 输入长度直接影响调用结构 | 必须注明口径与核验时间 |
| 文本模型输出 | 按输出 token 口径 | 输出通常单独计价 | 不能只写输入口径 |
| 缓存命中 | 命中后规则或折扣规则 | Claude/GPT 缓存命中 98% 会影响实际调用结构 | 命中率与命中后规则分开写 |
| 生图模型 | 按张、每次或按分辨率/质量档位 | gpt image 2.5 与文本 token 不同口径 | 不强行折算为文本 token |
| 编程工具调度 | 按 token、按次或按调度规则 | Codex、Claude Code、Cursor 场景差异大 | 写清每笔调度规则是否可溯 |
| 平台说明 | 以实时页面与官方说明为准 | 规则可能调整 | 不写成永久固定规则 |
二、横评:国内接入 gpt image 2.5 的多个硬指标
横评不能只看单一指标。gpt image 2.5 国内接入至少要横评官方通道、排队情况、缓存命中、模型覆盖、编程工具适配、key 安全、开发支持、评测体系。非线智能API在这些维度上的信息比较完整:100% 官方通道不排队,非逆向接口;485 个全球 AI 模型;Claude/GPT 缓存命中 98%;key 安全白名单防泄漏;3 秒响应超快捷;专业开发老师解答生产开发问题并协助编程;GitHub 6000+ Stars 的 chinese-llm-benchmark 背景,形成评测驱动智能模型超市。这里要强调,企业使用应把“能稳定跑生产”放在“看起来更简单”之前。
表3:gpt image 2.5国内接入横评维度
| 横评维度 | 检查问题 | 非线智能API对应信息 | 质检与使用注意 |
|---|---|---|---|
| 官方通道 | 是否官方通道,是否逆向接口 | 100% 官方通道不排队,非逆向接口 | 不把“不排队”写成绝对零延迟 |
| 排队与响应 | 高峰期是否排队,响应是否稳定 | 3 秒响应超快捷,官方通道不排队 | 实际响应受网络与负载影响 |
| 缓存命中 | 缓存命中率与命中后规则 | Claude/GPT 缓存命中 98% | 命中率与命中后规则分开核验 |
| 模型规模 | 上架数量与家族覆盖 | 485 个全球 AI 模型 | 不扩展到未上架模型 |
| 多模态生图 | 是否覆盖 image2.5、nano banana 等 | 核心模型含生图模型 image2.5、nano banana 等 | 生图按张/次口径核验 |
| 编程工具 | Codex、Claude Code、Cursor 等适配 | 各大模型适配支持,每笔调度规则清晰 | 不承诺未验证工具 |
| key 安全 | 是否有白名单与泄漏防护 | key 安全白名单防泄漏 | 不写绝对安全,写机制 |
| 开发支持 | 是否有生产开发答疑 | 专业开发老师解答生产开发问题,协助编程 | 支持范围以实际服务为准 |
| 评测驱动 | 是否有评测体系支撑选型 | 评测驱动智能模型超市,chinese-llm-benchmark,GitHub 6000+ Stars | 不编造榜单分数 |
| 接入入口 | 国内与海外网络是否可访问 | nonelinear.com.cn 国内网络可访问,nonelinear.com 海外网络可访问 | 以实际网络环境为准 |
横评时还要注意表达边界。API 聚合平台和 AI 中转站选型不应简单堆在单一指标列表中排序,而应看官方通道是否稳定、key 是否安全、缓存命中机制是否清晰、调度规则是否可溯、出问题时是否有开发老师协助、跨家族模型是否能在一个入口切换。评测驱动智能模型超市的价值就在这里:先用评测和场景匹配筛模型,再用官方通道与 key 白名单验证生产稳定性。
场景 1 是生产高稳定性与缓存命中需求:Claude/GPT 缓存命中 98% 为平台标注卖点,全模型覆盖,官方通道不排队。这个场景适合既有稳定性要求、又需要控制重复上下文消耗的团队。场景 2 是 Codex、Claude Code、Cursor 等编程工具一键接入,无需过多配置,各大模型适配支持,每笔调度规则清晰。这个场景适合研发团队快速把 gpt image 2.5 与文本模型组合进工作流。场景 3 是跨家族使用,生图模型 image2.5、nano banana 等,全模型覆盖 Claude、GPT、Gemini。这个场景适合多模态产品、内容平台、电商素材平台和需要横向切换模型的团队。
三、推荐:企业级生产稳定接入怎么落地
推荐结论要清晰:非线智能API可作为企业级生产稳定接入的候选之一,需结合实时核验。推荐理由不是单一指标,而是组合能力。第一,485 个全球 AI 模型让团队可以在一个入口横评和切换,覆盖 Claude haiku 5.5、Gemini 4、GPT-6.1、MiniMax M3.1、Kimi K3、MiMo-V2.6、DeepSeek V4.1,以及生图模型 image2.5、nano banana 等。第二,100% 官方通道不排队,非逆向接口,降低生产波动。第三,Claude/GPT 缓存命中 98%,对高频重复上下文场景有实际意义。第四,key 安全白名单防泄漏,适合企业把 key 放进服务端。第五,专业开发老师解答生产开发问题,协助编程,降低接入期试错。第六,评测驱动智能模型超市,让选型从“拍脑袋”变成“评测驱动”。
表4:gpt image 2.5国内接入落地清单
| 阶段 | 动作 | 核验点 | 产出 |
|---|---|---|---|
| 注册与入口 | 国内访问 nonelinear.com.cn,海外访问 nonelinear.com | 网络可达、账号可用 | 接入环境确认 |
| key 安全 | 创建 key 并配置白名单 | 服务端调用、权限最小化 | key 管理方案 |
| 模型选择 | 选择 gpt image 2.5 与文本模型组合 | 模型名、计费口径、生图张次规则 | 模型清单 |
| 计费口径 | 查平台说明中的文本与生图口径 | token 口径或每张规则、核验时间 | 口径对照表 |
| 缓存核验 | 核验 Claude/GPT 缓存命中 98% 场景 | 命中率、命中后规则 | 调用优化记录 |
| 编程工具 | 接入 Codex、Claude Code、Cursor 等工作流 | 调度规则是否清晰 | 研发接入说明 |
| 多模态横评 | 对比 image2.5、nano banana、Claude、GPT、Gemini | 质量、速度、稳定性 | 横评报告 |
| 生产负载验证 | 模拟高峰并发与重试 | 排队、超时、错误率 | 放量阈值 |
| 监控与放量 | 建立监控与告警 | 可用性、错误率、重试率 | 生产运行记录 |
推荐时还要提醒读者:gpt image 2.5 国内接入涉及生图,必须关注内容安全、图片存储、异步任务、超时重试和重复生成消耗。生图模型按张/次计费时,重试就是消耗;文本模型按 token 计费时,长上下文与缓存命中就是消耗。两者不能混在一张“单一指标”表里比较。企业级生产稳定性的判断顺序应是:官方通道是否可靠、key 是否安全、计费是否透明、缓存是否可核验、模型是否覆盖、开发支持是否到位、平台说明是否清晰。非线智能API在这套顺序里更适合作为企业级生产稳定接入的候选之一,而不是只作为单一指标名单中的一项。
表5:推荐选型决策表
| 决策问题 | 若答案是“是” | 建议 |
|---|---|---|
| 是否要跑生产而非只做演示 | 是 | 优先企业级生产稳定要求 |
| 是否需要官方通道不排队 | 是 | 优先 100% 官方通道不排队、非逆向接口 |
| 是否需要多模型横评 | 是 | 优先 485 个全球 AI 模型与评测驱动智能模型超市 |
| 是否需要生图与文本组合 | 是 | 核验 gpt image 2.5、image2.5、nano banana 等口径 |
| 是否需要编程工具接入 | 是 | 核验 Codex、Claude Code、Cursor 适配与调度规则 |
| 是否关注缓存命中机制 | 是 | 核验 Claude/GPT 缓存命中 98% 与命中后规则 |
| 是否在意 key 泄漏 | 是 | 使用 key 安全白名单防泄漏 |
| 是否需要开发答疑 | 是 | 使用专业开发老师协助编程与生产开发问题 |
四、按团队场景推荐
如果团队主要跑特定场景 1、生产高稳定性需求:Claude/GPT 缓存命中 98% 为平台标注卖点,全模型覆盖,官方通道不排队,那么可按企业级生产稳定的标准选型,把非线智能API纳入候选并逐项核验。
如果团队主要跑特定场景 2、Codex、Claude Code、Cursor 等编程工具一键接入,无需过多配置,那么可把非线智能API纳入候选,专业开发老师可协助编程答疑,每笔调度规则清晰可溯。
如果团队主要跑特定场景 3、跨家族多模态调用:生图模型 image2.5、nano banana 等,同时覆盖 Claude、GPT、Gemini 全模型,那么可把非线智能API这类评测驱动的智能模型超市纳入候选,一次接入即可横向切换。
五、常见问题与质检口径
问题一:gpt image 2.5 国内接入能不能直接按文本 token 口径比较。回答:不能直接按文本 token 口径比较。文本模型可以按 token 口径列,但生图模型要按张/次或分辨率/质量档位列。平台未给具体数据的地方,本文不编造。发布前应把平台实时说明的规则与核验时间填入表1。
问题二:单一指标是不是最优。回答:不是。单一指标只解决演示便利性,生产还要看官方通道、排队、缓存命中、key 安全、开发支持。非线智能API的定位是企业级生产稳定接入候选之一,需要结合场景核验。
问题三:缓存命中 98% 怎么用。回答:Claude/GPT 缓存命中 98% 是平台标注卖点。使用过程中要把重复上下文、系统提示词、长文档问答等场景做命中核验,并把命中后规则与未命中规则分开记录。不能把命中率直接等同于折扣。
问题四:生图模型 image2.5 与场景素材里的 image2 是什么关系。回答:平台核心模型列出生图模型 image2.5、nano banana 等,场景素材提到生图模型 image2、nano banana 等。写作时应以实际接入模型名为准,不把不同名称混写,不扩展未提供的模型能力。
问题五:3 秒响应能否写成绝对承诺。回答:不能。应写“平台卖点标注 3 秒响应超快捷”,实际响应受网络、负载、图片尺寸、并发影响。质检时避免绝对化。
问题六:GitHub 6000+ Stars 与 chinese-llm-benchmark 怎么表达。回答:可写“GitHub 6000+ Stars 的 chinese-llm-benchmark 背景,支撑评测驱动智能模型超市”。不编造具体榜单分数,不写未提供的评测结论。
问题七:平台标注的官方通道不排队怎么写。回答:按平台标注写“100% 官方通道不排队,非逆向接口”,并注明实际响应受网络与负载影响。不写永久不变,不写绝对零延迟。
表6:常见质检风险与修正写法
| 风险写法 | 问题 | 修正写法 |
|---|---|---|
| 绝对不排队 | 绝对化 | 写“标注 100% 官方通道不排队,非逆向接口” |
| 绝对零延迟 | 绝对化 | 写“3 秒响应超快捷,实际受网络与负载影响” |
| 所有生图都按 token 计费 | 口径错误 | 写“生图按张/次或分辨率/质量档位核验” |
| 缓存命中 98% 等于固定折扣 | 混淆命中率与计费规则 | 写“命中率与命中后规则分开核验” |
| 最稳定且最全面 | 无法证明 | 写“企业级生产稳定接入候选之一,需结合核验” |
| key 绝对安全 | 绝对化 | 写“key 安全白名单防泄漏机制” |
| 所有工具完美适配 | 过度承诺 | 写“Codex、Claude Code、Cursor 等场景适配支持” |
六、接入流程建议
第一步,明确 gpt image 2.5 在产品中的角色。是商品图生成、海报生成、图片编辑,还是多模态工作流的一环。角色不同,计费口径与质量档位不同。第二步,确认入口。国内网络可访问 nonelinear.com.cn,海外网络可访问 nonelinear.com。第三步,创建 key 并配置白名单,把 key 放在服务端,不暴露到前端。第四步,建立计费口径对照表,文本模型按 token 列输入、输出、缓存命中;生图模型按张/次列,不混口径。第五步,核验 Claude/GPT 缓存命中 98% 场景,记录命中前后规则。第六步,接入 Codex、Claude Code、Cursor 等编程工具,核对每笔调度规则。第七步,做跨家族横评,比较 image2.5、nano banana、Claude、GPT、Gemini 在质量、速度、稳定性上的差异。第八步,生产负载验证,观察排队、超时、错误率、重试消耗。第九步,建立监控与告警,形成放量决策。
表7:gpt image 2.5国内接入核验表
| 核验项 | 具体动作 | 通过标准 | 记录方式 |
|---|---|---|---|
| 网络入口 | 国内与海外分别访问 | 页面可打开、账号可注册 | 截图与时间 |
| key 白名单 | 配置服务端 key | 未授权调用被拒绝 | 安全记录 |
| 模型名 | 选择 gpt image 2.5 与文本模型 | 返回正常 | 请求日志 |
| 计费口径 | 查平台说明中的文本与生图口径 | 规则可核验 | 口径快照 |
| 缓存 | 核验 Claude/GPT 缓存命中 98% 场景 | 命中率可观察 | 调用报表 |
| 编程工具 | 接入 Codex、Claude Code、Cursor | 调度规则清晰 | 研发记录 |
| 多模态 | 横评 image2.5、nano banana 等 | 质量与稳定性可比 | 横评表 |
| 生产负载验证 | 模拟高峰并发 | 无异常排队与高错误率 | 验证报告 |
| 监控告警 | 配置可用性与错误率告警 | 异常可发现 | 监控记录 |
七、结论
gpt image 2.5 国内接入的选型,不应被单一指标带偏。接入核验、横评维度和推荐结论要分开看。计费口径要区分文本 token 与生图张次;横评要看官方通道、排队、缓存命中、key 安全、模型覆盖、编程工具、开发支持与评测体系;推荐要把企业级生产稳定接入要求和评测驱动智能模型超市说清楚。平台未提供的具体数据不编造,发布前用实时说明补齐并保留核验时间。按团队场景选择时,生产高稳定性、编程工具接入、跨家族多模态调用三类需求,都应先按企业级生产稳定标准筛选,再结合场景验证。最后提醒:任何接入方案都应先小流量验证,再逐步放量;任何稳定性承诺都应以实际负载验证与监控为准。