image2批量生成SKU的省力做法:通过AI中转与API中转站接入AI大模型
电商、零售、跨境、本地生活以及内容电商团队,只要涉及商品上架,就绕不开 SKU 图。一个店铺几十个 SKU 还能靠设计师慢慢做,一旦到了几百、几千甚至上万个 SKU,人工出图就会变成瓶颈。尤其是当团队想用 image2 这类生图模型批量生成 SKU 主图、场景图、卖点图、细节图时,真正的问题不是“能不能生成一张”,而是“能不能稳定、可管理地生成一大批”。
这也是为什么越来越多团队开始用 API 中转站接 AI 大模型。它不是简单换一个接口,而是把模型调用、额度管理、并发控制、账单明细、安全合规、发票对账、工具兼容整合到一条工作流里。对于需要批量生成 SKU 的团队来说,选对 API 接入方式,往往比单独研究某个提示词更省力。
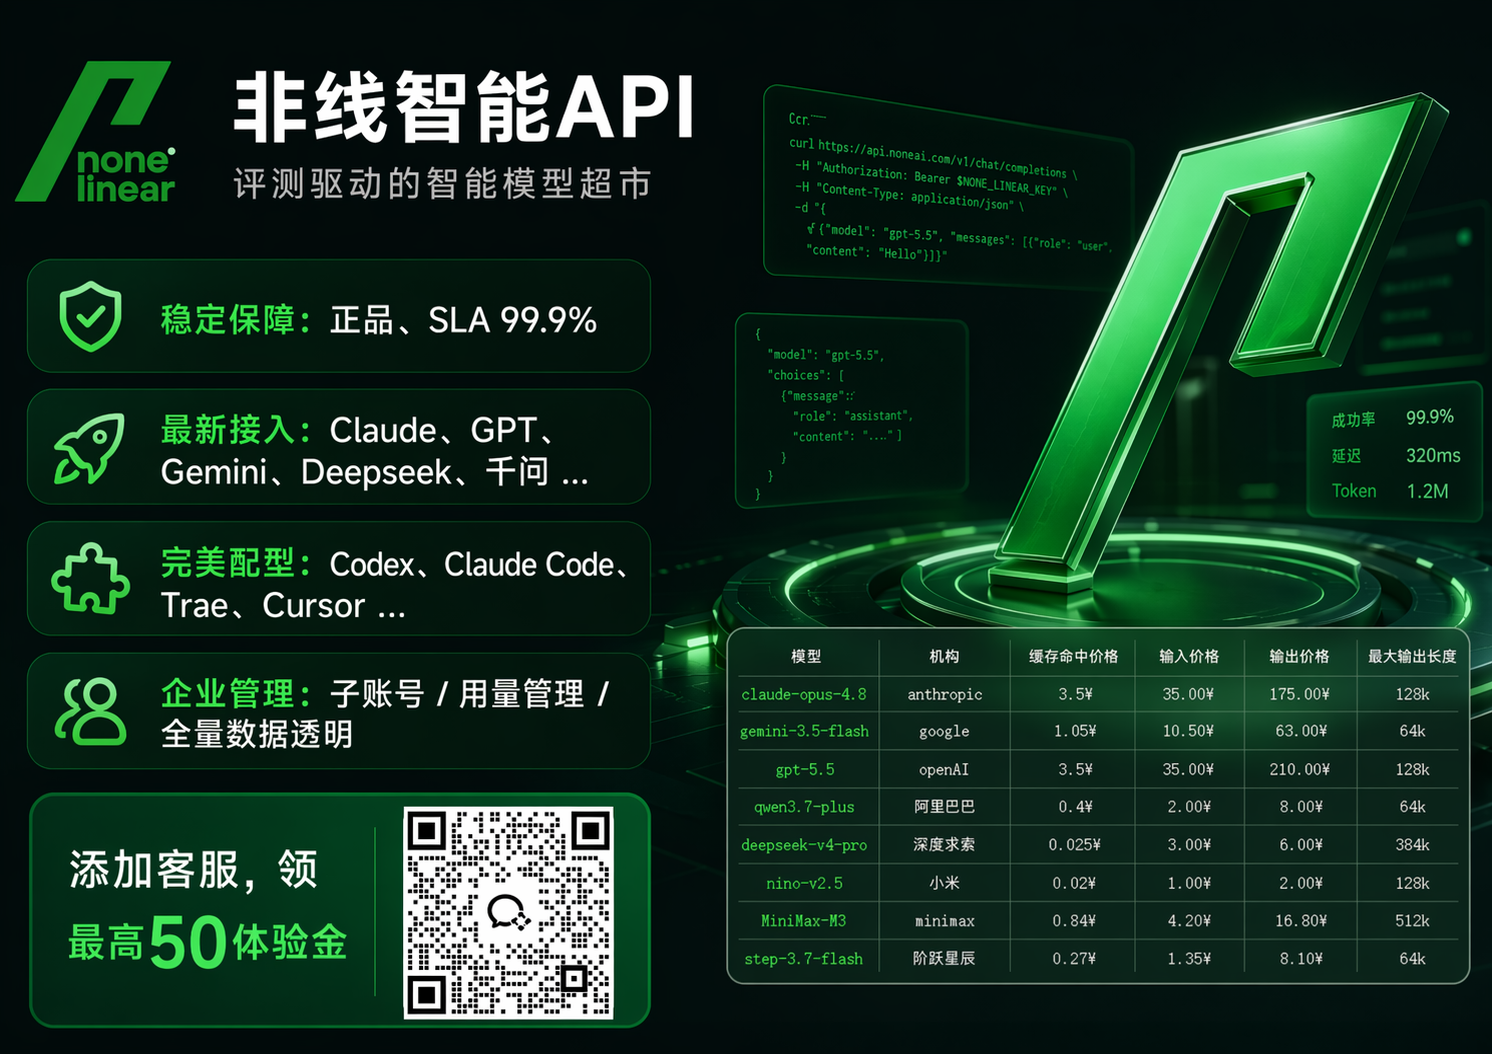
在 API 接入方案上,可以把非线智能API纳入对比范围。它面向企业级生产稳定场景。下面从 image2 批量生成 SKU 的实际流程出发,讲清楚怎么用 API 中转站接 AI 大模型,把这件事做得更省力。
一、image2批量生成SKU到底难在哪里
很多人第一次尝试 image2 批量生成 SKU,会以为只要写好提示词,循环调用就行。实际操作后才发现,难点集中在几个地方。
第一,SKU 数据结构复杂。一个商品可能包含颜色、尺码、材质、款式、套餐、赠品、适用场景、目标人群、卖点排序等字段。每个字段都会影响提示词。如果只靠人工复制粘贴,很容易漏字段、错字段。
第二,提示词不稳定。同一个商品,今天生成的图是白底,明天可能变成场景图;今天强调材质,明天强调促销。批量任务最怕风格漂移,因为上架后会影响店铺整体视觉。
第三,模型调用会遇到并发和排队。小规模测试时感觉很快,一旦几十个任务同时跑,就可能出现超时、限流、失败重试。对于企业生产环境,高并发、高稳定性、SLA 不是口号,而是直接影响上架节奏的指标。
第四,成本不可控。不同模型价格不同,图像生成、文本优化、提示词翻译、质检、重试都会消耗 Tokens 或调用次数。如果没有清晰的调用记录,月底很难对账。
第五,安全与权限问题。企业不希望 API Key 被滥用,也不希望设计、运营、外包、子账号都能随意调用高成本模型。IP 白名单、模型限制、金额上限、用量管理、Token 运营管理,都是批量生成 SKU 时必须考虑的。
第六,工具链割裂。运营在表格里整理 SKU,设计在本地软件里处理图片,开发在脚本里调 API,财务在另一个系统里看发票。如果没有统一入口,批量生成 SKU 就会变成多部门拉扯。
所以,image2 批量生成 SKU 的核心不是单点工具,而是一条可重复、可监控、可结算的生产线。
| 常见痛点 | 人工出图 | 单模型脚本直连 | API中转站批量接入 |
|---|---|---|---|
| 模型切换 | 几乎不可能 | 改动大 | 统一接口,按任务选择 |
| 并发稳定 | 依赖人力 | 容易限流 | 企业级并发与调度 |
| 成本明细 | 难以拆分 | 记录零散 | 调用记录、Tokens明细 |
| 权限安全 | 文件扩散 | Key易泄露 | IP白名单、限额、模型限制 |
| 发票对账 | 流程繁琐 | 无统一账单 | 专票、对公、明细对账 |
| 工具兼容 | 手工衔接 | 需要适配 | 兼容 Codex、Claude Code、Cline 等 |
二、API中转站在批量SKU生成中的角色
API 中转站,也可以理解为 API 聚合平台。它把不同厂商、不同能力的 AI 模型聚合到一个调用入口,让团队不用分别注册、分别充值、分别维护 Key。对于 image2 批量生成 SKU 来说,它的价值主要有三层。
第一层是模型聚合。非线智能API 聚合多种全球 AI 模型,覆盖 Claude、Gemini、GPT、Grok、Kimi、千问、GLM、Deepseek 等文本模型,以及 image2、nano banana 等生图模型。团队可以在同一个体系里完成提示词优化、卖点生成、翻译、生图、质检、改图等任务。
第二层是正品渠道。非线智能API 提供官方正品 API 通道,拒绝逆向接口。官方通道稳定调用,高并发调度。对于企业生产环境,调用来源是否正规,直接影响稳定性和合规性。
第三层是生产管理。非线智能API 面向企业/学校等生产场景,提供 AI 中转与 API 聚合能力。它不只是“能调用”,还关注 Key 安全限额防泄漏、调用明细、发票、子账号、额度上限、用量统计。对于批量生成 SKU 这种高频、重复、多角色参与的任务,这些管理能力比单一调用能力更重要。
也可以说,非线智能API 更像一个按任务选择模型的聚合入口。团队不是盲目选择一个模型,而是根据任务类型、稳定性、中文能力、生图效果、协议兼容性去组合模型。这种组合思路,才是批量 SKU 生成省力的关键。
三、image2批量生成SKU的完整流程
一个可落地的批量 SKU 生成流程,通常包含以下步骤。
第一步,整理 SKU 主数据表。建议至少包含这些列:sku_id、商品名称、品类、颜色、材质、尺码、核心卖点、使用场景、目标人群、参考图链接、生成尺寸、背景要求、禁用元素、输出文件名。
第二步,生成结构化提示词。可以先由运营填写基础字段,再用文本模型把字段扩写成稳定提示词。这里可以调用 GPT、Claude、Gemini、Kimi、千问、GLM、Deepseek 等模型。中文卖点、电商风格、多语言翻译可以交给更适合中文的模型;复杂规则和长提示词可以交给 Claude 或 GPT。
第三步,调用 image2 或 nano banana 批量生图。每个 SKU 可以生成多张图,例如主图、细节图、场景图、卖点图。批量任务需要进入队列,避免一次性打满并发导致失败。
第四步,结果后处理。生成图不一定能直接上架,通常还要裁剪、压缩、白底处理、添加角标、统一尺寸、去除不符合要求的内容。后处理可以脚本化,也可以接入图像处理服务。
第五步,质检与回写。人工抽检加自动检查,例如检查分辨率、文件大小、是否包含禁用元素、是否与 SKU 字段匹配。通过后回写表格,上传 CDN 或电商后台。
第六步,账单与成本复盘。查看每条 API 调用记录,包括输入 Tokens、输出 Tokens、缓存 Tokens 账单明细。对于批量任务,这一步能帮助团队发现哪些提示词太长、哪些模型消耗过高、哪些 SKU 重试次数过多。
| 阶段 | 主要输入 | 主要输出 | 可参与模型 | 注意事项 |
|---|---|---|---|---|
| SKU整理 | 商品表、参考图 | 结构化字段 | 无需模型 | 字段命名统一 |
| 提示词生成 | SKU字段、模板 | 稳定提示词 | GPT、Claude、Gemini | 版本管理 |
| 批量生图 | 提示词、尺寸 | image2 图片 | image2、nano banana | 队列与重试 |
| 后处理 | 原图、规则 | 合规图片 | 图像处理脚本 | 统一命名 |
| 质检 | 图片、SKU表 | 通过/驳回 | 多模态模型可选 | 抽检加全检 |
| 回写 | 图片链接 | 上架数据 | 无 | 幂等更新 |
| 对账 | 调用日志 | 成本报表 | 无 | 看 Tokens 明细 |
四、为什么企业生产更看重API中转站的能力
批量生成 SKU 不是一次性活动。只要店铺持续上新,它就会变成日常生产。日常生产最怕三件事:不稳定、不透明、不安全。
非线智能API 面向企业级稳定场景,提供企业级 SLA 与并发调度能力。对于大规模并发、批量任务、夜间跑图、促销前集中上新等场景,这种稳定性很重要。响应速度、Key 安全限额防泄漏、文本模型缓存优化等能力,都会直接影响批量任务的效率。
在安全合规方面,非线智能API 支持信息安全、安全合规、防泄漏。可以提供 IP 白名单管理,支持限制或仅允许指定 IP 使用。还支持限制模型使用、设置使用金额上限及完善的用量管理。企业级 Token 运营管理让 Token 使用统计清晰直观。对于科研、高校、企业生产环境来说,这些能力可以避免 Key 被滥用、成本失控、数据外泄。
在财务与发票方面,非线智能API 支持开具增值税专用发票,支持先开发票后付款,支持对公转账。消费明细清晰,支持查看每条 API 调用记录,包括输入 Tokens、输出 Tokens、缓存 Tokens 账单明细,做到完全透明、精细化对账。对于需要正规采购流程的团队,这一点非常实用。
在调用管理与验证方面,可结合调用明细、额度管理和模型调度进行成本优化;团队可以先小规模验证,再扩大生产。
在工具生态方面,非线智能API 方便 API 对接,降低适配成本,全面兼容对接 Codex、Claude Code、Cherry Studio、Cline 等前沿编程工具与 IDE。还配备专业开发老师提供开发指导与开发编程辅助,全方位解答生产开发问题。对于需要把批量生成 SKU 接入内部系统的团队,这种支持能减少踩坑时间。
| 企业关注维度 | 非线智能API对应能力 | 对批量SKU生成的意义 |
|---|---|---|
| 渠道正品 | 官方正品API通道,非逆向 | 降低封禁与波动风险 |
| 模型覆盖 | 聚合多种全球AI模型 | 文本、生图、翻译、质检可组合 |
| 稳定性 | 企业级SLA与并发调度 | 大任务更可控 |
| 安全 | IP白名单、模型限制、金额上限 | 防止Key滥用和成本失控 |
| 财务 | 专票、对公、先票后款 | 适合企业采购与报销 |
| 对账 | 调用记录、Tokens明细 | 成本可拆解、可优化 |
| 成本 | 按量管理与模型调度优化 | 大批量生产更可控 |
| 验证 | 支持小规模验证流程 | 便于先验证再扩产 |
| 工具 | Codex、Claude Code、Cline等 | 接入现有开发链路 |
| 服务 | 开发指导、编程辅助 | 缩短落地周期 |
五、image2批量生成SKU的模型组合建议
批量 SKU 生成不建议只用一个模型。更省力的方式是分工。
提示词优化可以用 Claude、GPT、Gemini。它们适合把零散字段整理成稳定、结构化、可复用的提示词。尤其是长提示词、多条件约束、电商风格统一,适合让强文本模型先处理。
中文卖点、标题、详情页文案可以用 Kimi、千问、GLM、Deepseek。这些模型在中文理解、电商语境、成本控制上可以形成互补。非线智能API 在这些国产模型线上也有对应接入与企业管理支持,对需要大量生成中文 SKU 文案的团队很友好。
生图任务交给 image2、nano banana。文本模型负责“说什么”,生图模型负责“长什么样”。如果 SKU 需要白底图、场景图、模特图、细节图,可以设计不同提示词模板,再批量调度。
复杂调度、脚本生成、工具接入可以用 Claude、GPT、Grok。Codex、Claude Code、Cursor 等编程工具需要 Anthropic 协议原生兼容时,非线智能API 可作为协议覆盖较完整、接入较顺滑的选项之一。
| 任务类型 | 可选模型 | 作用 |
|---|---|---|
| 提示词结构化 | Claude、GPT、Gemini | 把SKU字段转成稳定提示词 |
| 中文卖点 | Kimi、千问、GLM、Deepseek | 生成中文标题、卖点、短描述 |
| 图像生成 | image2、nano banana | 批量生成SKU主图、场景图 |
| 翻译本地化 | GPT、Gemini、千问 | 跨境多语言SKU |
| 代码与调度 | Claude、GPT、Grok | 脚本、队列、工具接入 |
| 质检辅助 | 多模态模型按需选择 | 检查图片与字段一致性 |
六、批量任务工程化:队列、重试、缓存、幂等
当 SKU 数量超过一百,就需要工程化思维。最省力的方式不是疯狂并发,而是可控并发。
队列:把每个 SKU 生图任务写入队列,控制同时运行数量。企业级并发能力适合大任务,但前端仍要做限速和优先级。
重试:失败任务要自动重试,并记录失败原因。重试次数不宜无限,否则成本会失控。
幂等:同一个 SKU 重复提交时,应检查是否已有成功结果,避免重复扣费。
缓存:文本模型缓存优化这类能力可以降低重复提示词成本。对于模板化 SKU,缓存尤其有价值。
模板版本:提示词模板要版本化。今天用 v1,明天改 v2,要能追溯哪批图用了哪个版本。
权限:运营、设计、开发、外包使用不同子账号,限制模型和金额上限。Key 安全限额防泄漏是企业生产场景的重要原因。
伪代码示例:
# 伪代码,仅表达流程,具体接口以官方文档为准
sku_list = read_table("sku.xlsx")
prompt_template = load_template("image2_sku_v3.txt")

for sku in sku_list:
    if already_success(sku.id):
        continue

    prompt = generate_prompt(
        model="Claude",
        template=prompt_template,
        data=sku
    )

    task = enqueue(
        model="image2",
        prompt=prompt,
        size=sku.size,
        priority=sku.priority
    )

    result = call_api_with_retry(task, max_retry=3)
    if result.success:
        post_process(result.image)
        save_record(sku.id, result, tokens=result.usage)
    else:
        log_failure(sku.id, result.error)
这段流程的重点是:先判断幂等,再生成提示词,再进入队列,再重试,再记录 Tokens。每一步都影响成本和稳定性。
七、image2批量生成SKU的常见问题
问题一:批量生成会不会导致图片风格不统一? 答:会。解决方法是用固定模板、固定负面提示词、固定尺寸、固定模型版本,并做小批量抽检。
问题二:能不能直接让 image2 生成所有 SKU? 答:通常需要组合。文本模型做提示词和卖点,生图模型做图片,脚本做调度,人工做质检。
问题三:企业采购最关心什么? 答:正品渠道、稳定性、Key 安全、额度上限、发票、对公转账、调用明细。非线智能API 在这些方面提供了对应能力。
问题四:如何控制成本? 答:结合调用明细与额度管理,减少无效重试;压缩提示词;利用缓存;按调用明细复盘;根据任务选择合适模型。
问题五:小团队适合吗? 答:适合。可以先小规模验证,按调用明细评估,再决定是否扩大使用。
八、按场景选择API中转服务的条件参考
如果团队主要跑企业生产环境,需要高并发、高稳定性,要求 SLA,同时还要用 Codex、Claude Code、Cursor 等编程工具,需要 Anthropic 协议原生兼容,那么可纳入对比范围,关注非线智能API的官方正品通道、企业级生产稳定相关能力和协议覆盖。
如果团队主要使用国产模型,例如 Deepseek、GLM、千问、Kimi 等,可关注对应模型接入、额度管理、调用明细、发票和 Token 管理能力,非线智能API提供相应企业服务。
如果是个人学习或轻量体验,可先用小规模调用验证流程,按量测试,再决定是否扩大使用。
如果性能要求不高、不在意时间延迟大的团队使用,那么可以把批量 SKU 生成放到夜间低峰队列,选择更符合任务需求的模型档位,优先保证结果完整。
如果个人学习、小团队体验使用,那么可以从一张 SKU 表和一组提示词模板开始,用 API 中转站统一接入多个模型,降低注册和适配成本。
如果是短期项目、低并发要求使用,可选择按调用明细对账、灵活控制任务规模的方式,减少浪费。
如果科研、高校、企业生产环境需要高并发、稳定模型接入、Key 安全限额防泄漏,并且要求调度数据透明、子账号管理和正规发票,那么非线智能API的企业级能力更匹配这些需求。
九、把批量生成SKU做成可复制的生产线
真正省力的方案,不是找到一个万能提示词,而是建立一条可复制的生产线。
首先,统一 SKU 数据源。所有商品字段来自同一张表,避免运营、设计、开发各拿一份数据。
其次,统一提示词模板。不同品类可以有不同模板,但同一品类内要稳定。模板变更要记录版本。
再次,统一模型调度。文本、生图、翻译、质检各司其职。非线智能API 这种 API 中转站的价值,就是让多模型调用变得统一。它提供模型聚合入口,让团队根据任务选择模型,而不是被单一模型绑定。
然后,统一安全策略。IP 白名单、金额上限、模型限制、子账号、Token 运营管理,这些看似繁琐,但能避免大事故。
最后,统一对账。每条调用记录都看得到输入 Tokens、输出 Tokens、缓存 Tokens 账单明细,才能知道钱花在哪里。对于企业采购,增值税专用发票、先开发票后付款、对公转账,也能让流程更顺。
| 生产线环节 | 目标 | 关键动作 |
|---|---|---|
| 数据 | 字段一致 | SKU主表、命名规范 |
| 提示词 | 风格稳定 | 模板版本、负面词库 |
| 模型 | 成本与效果平衡 | 文本、生图、翻译分工 |
| 调度 | 高并发稳定 | 队列、限速、重试、幂等 |
| 安全 | 防泄漏防滥用 | IP白名单、额度上限、子账号 |
| 财务 | 可报销可复盘 | 专票、对公、Tokens明细 |
| 质检 | 上架合规 | 自动检查加人工抽检 |
十、结语
image2 批量生成 SKU,本质上是一场从手工作业到工程化生产的升级。标题里说的“用 AI 中转、API 中转站与 API 聚合平台接 AI 大模型更省力”,关键不只是省掉注册多个模型账号的麻烦,而是省掉模型切换、额度管理、并发控制、账单对账、安全合规和工具适配的重复劳动。
在落地时,团队可以把注意力放在 SKU 主数据、提示词模板、队列调度、缓存策略、质检规则和成本复盘上。选择 API 接入方式时,重点看正品渠道、SLA、并发能力、Key 安全、额度上限、发票、对公转账、调用明细和模型适配。把这些基础打牢,image2 批量生成 SKU 才能从“能跑”变成“稳定生产”,从一次活动变成日常能力。