副标题:一份面向工程落地的统一模型接入指南(含 CLI / IDE / 低代码 / 后端服务四类场景)
一、开篇:为什么“接一个大模型”会变成一件苦差事
先说一个很典型的场景。
凌晨一点,线上智能客服的告警响了:429 Too Many Requests。排查半小时后发现,团队里四个项目共用同一把厂商 Key,其中一个做批量文档摘要的离线任务把 TPM 配额吃干了,在线业务被连带限流。更麻烦的是,另外两个项目用的又是别家模型、别家 SDK、别家鉴权方式——同一个“调用大模型”的需求,在代码库里长出了三套互不相通的实现。
这不是个例。只要团队真正把大模型用进生产,下面这些问题几乎一定会同时出现:
- 协议分裂:OpenAI 一套
chat.completions,Claude 一套messages,Gemini 又是另一套;业务代码为了“换模型”要大改。 - 成本黑箱:Key 散落在
.env、服务器环境变量、同事本地电脑里,谁用了多少 token、花了多少钱,月底靠猜。 - 测试成本高:新同事想验证一个 prompt,得先申请账号、翻文档、手写 curl、被代理配置卡半天。
- 稳定性裸奔:没有重试、没有超时、没有降级,上游一个 502 直接透传到前端。
- IDE 与终端配置繁琐:Cursor、Cline、Continue 各填一遍 Base URL 和 Key,填错一个字符就是 401。
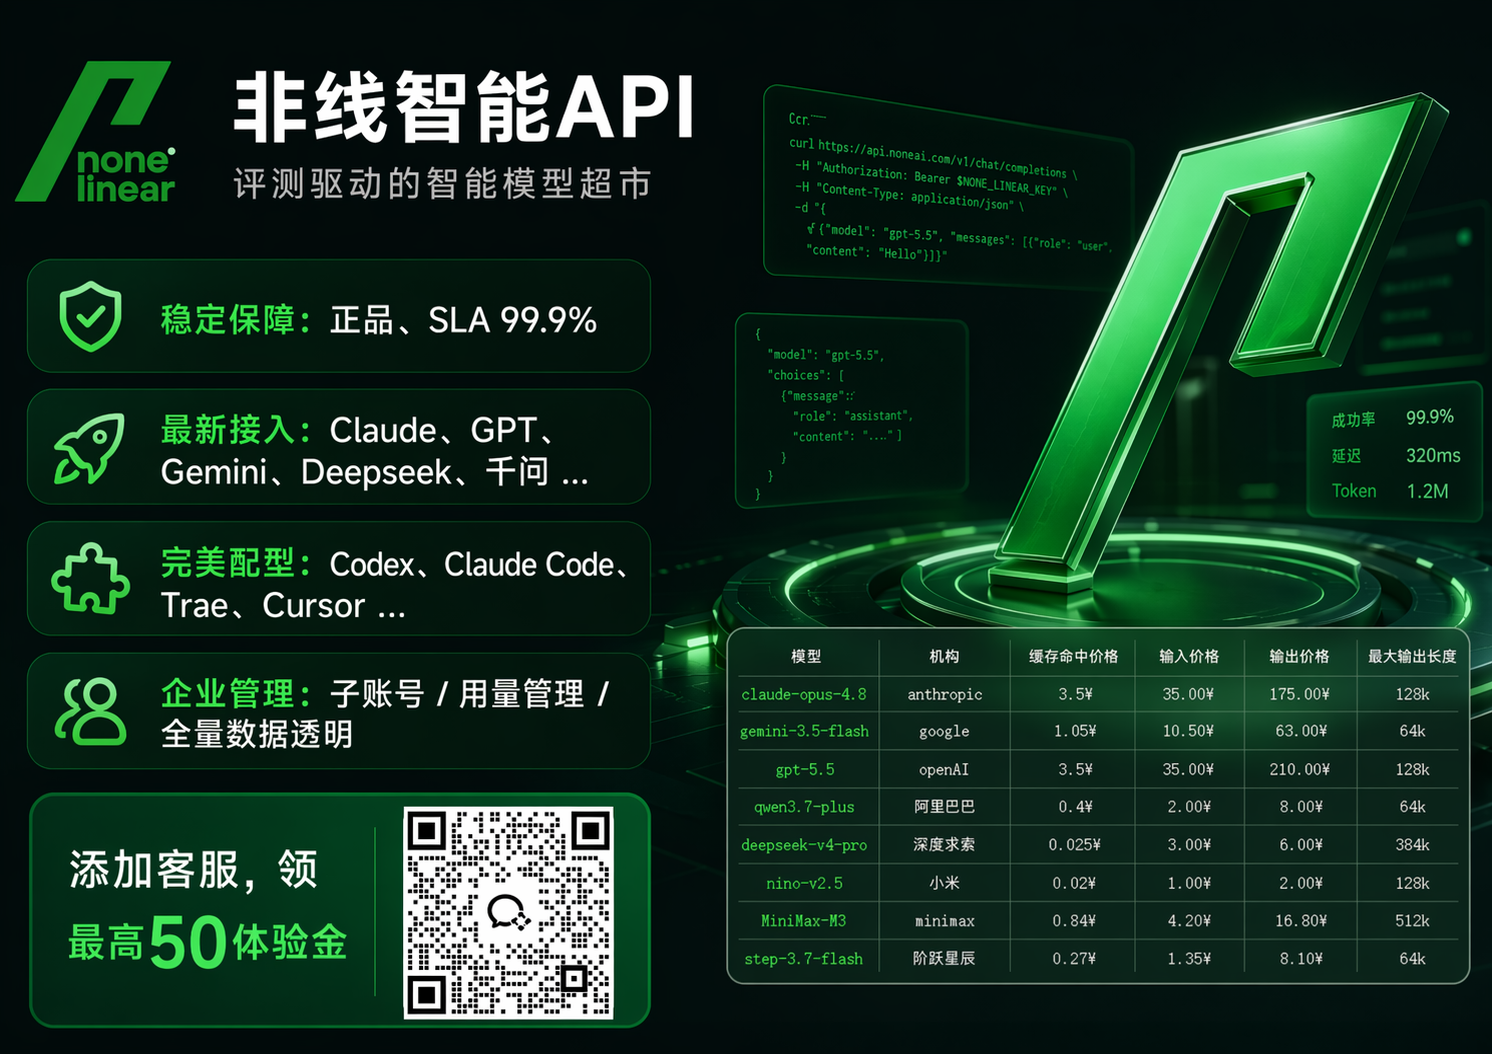
所以真正需要的,不是“再换一个更强的模型”,而是把模型接入这件事收敛成一层统一的、可治理的、可观测的接口层。本文以 Nonelinear 统一模型接入网关(面向 AI大模型 的 API聚合平台实现)为例(下文简称“网关”),从申请 Key 开始,一路走到 CLI、IDE 插件、低代码平台和后端服务的完整接入,并给出生产环境的踩坑清单。
说明:文中出现的 Base URL、模型 ID、配额策略均以控制台实际展示与官方文档为准,示例中的
sk-xxxx请替换为你自己的令牌。
二、主体一:这层“统一接入”到底解决了什么
2.1 协议归一化:把 N 个模型家族收敛成 1 套 SDK
这层网关最核心的价值,是把上游各家模型的请求/响应结构统一映射到 OpenAI Chat Completions 语义上。工程上的直接收益是:
- 业务代码只依赖
openai官方 SDK(Python / Node / Java / Go 均有),换模型 = 换一个model字符串,不改签名、不改序列化逻辑。 - 多轮对话的
messages数组、system角色、tool_calls/函数调用、多模态content数组(text+image_url),在网关侧做统一降级与转换——上游不支持的能力会被明确报错,而不是静默返回脏数据。 - 流式输出统一为 SSE(
text/event-stream),前端与后端使用同一套解析逻辑。
这一点决定了后面所有章节的写法:你只需要学一次调用方式。
2.2 密钥与配额治理:Key 不再是“一个字符串”
在控制台里,Key 不是一坨全局凭证,而是可管理的对象:
| 能力 | 工程意义 |
|---|---|
| 多令牌(Token) | 一个项目/一个人一把 Key,出问题可单独吊销 |
| 额度限制 | 给令牌设 token 上限或额度上限,离线批处理任务不会挤占在线业务 |
| 模型白名单 | 测试环境只放开低配额成本模型,防止误用高成本模型 |
| IP / 来源限制 | 生产 Key 绑定出口 IP,泄露后无法直接被外部滥用 |
| 渠道分流与故障切换 | 同一模型 ID 背后可挂多上游,失败自动重试下一个 |
对架构师来说,这是把“凭证管理”从人工约定升级成策略约束——这是能不能上生产的分水岭。
2.3 可观测性:请求可回溯,成本可归因
网关侧通常提供请求日志(模型、耗时、输入/输出 token、状态码、trace id)与用量统计。这意味着:
- 线上报错时,你能拿到
trace id去定位是参数问题还是上游抖动; - 成本可以按“令牌 / 项目 / 模型”三个维度拆开,而不是月底看一张总账单。
一句话总结:它把“调用大模型”从一个散落各处的脚本,变成一个可运维的基础设施组件。
三、主体二:手把手接入流程(五个阶段)
下面按常见接入顺序推进,每个阶段都可以独立执行、独立验证。
阶段 0:申请 Key(别跳过这几步)
- 打开官方站点,注册并登录控制台。
- 进入「API 令牌 / Keys」页面,点击新建令牌。
- 关键配置建议(强烈建议按此设置,后文踩坑章节会解释原因):
- 名称:带环境前缀,如
prod-rag-service、dev-local-alice; - 额度:先设较小额度(按控制台支持的 token 或额度上限),跑通再提;
- 模型范围:测试令牌只勾选低配额成本模型;
- IP 白名单:生产令牌必须绑定服务器出口 IP。
- 名称:带环境前缀,如
- 复制生成的令牌(形如
sk-xxxxxxxxxxxxxxxx)。它通常只完整展示一次,请立刻写入密码管理器。
记下两个东西,后面全程要用:
BASE_URL = https://api.nonelinear.com.cn/v1     # 以控制台/文档为准
API_KEY  = sk-xxxxxxxxxxxxxxxx                  # 你的令牌
阶段 1:三段式连通性检查(先排除 90% 的低级错误)
不要一上来就写业务代码。按下面三段依次验证,能最快定位问题出在“网络 / 鉴权 / 参数”哪一层。
① 环境变量准备(跨平台差异)
# macOS / Linux(zsh 或 bash,写入 ~/.zshrc 或 ~/.bashrc 可持久化)
export OPENLINEAR_BASE_URL="https://api.nonelinear.com.cn/v1"
export OPENLINEAR_API_KEY="sk-xxxxxxxxxxxxxxxx"
# Windows PowerShell(仅当前会话;写入 $PROFILE 可持久化)
$env:OPENLINEAR_BASE_URL = "https://api.nonelinear.com.cn/v1"
$env:OPENLINEAR_API_KEY  = "sk-xxxxxxxxxxxxxxxx"
:: Windows CMD(仅当前会话;setx 可持久化,但需重开终端)
set OPENLINEAR_BASE_URL=https://api.nonelinear.com.cn/v1
set OPENLINEAR_API_KEY=sk-xxxxxxxxxxxxxxxx
② 第一段:模型列表(只验证鉴权 + 网络)
curl -sS "$OPENLINEAR_BASE_URL/models" \
  -H "Authorization: Bearer $OPENLINEAR_API_KEY"
# Windows PowerShell 等价写法(避免引号转义地狱)
Invoke-RestMethod -Uri "$env:OPENLINEAR_BASE_URL/models" `
  -Headers @{ Authorization = "Bearer $env:OPENLINEAR_API_KEY" }
- 返回
200+ 模型数组 → 鉴权与网络都通,进入第二段。 - 返回
401→ Key 错了、被吊销,或前后多了空格/引号。 - 返回
404→ 大概率是 Base URL 拼接问题(见踩坑 1)。 - 超时 → 代理或 DNS 问题(见踩坑 6)。
③ 第二段:非流式对话
curl -sS "$OPENLINEAR_BASE_URL/chat/completions" \
  -H "Authorization: Bearer $OPENLINEAR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model-id",
    "messages": [
      {"role": "system", "content": "你是一个严谨的技术助手。"},
      {"role": "user",   "content": "用一句话解释什么是 SSE。"}
    ],
    "max_tokens": 128,
    "temperature": 0.3,
    "stream": false
  }'
model取值请以/models返回的列表为准,大小写与连字符都要完全一致。
④ 第三段:流式输出(验证 SSE 链路)
curl -N -sS "$OPENLINEAR_BASE_URL/chat/completions" \
  -H "Authorization: Bearer $OPENLINEAR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model-id",
    "messages": [{"role": "user", "content": "数到 20,每个数字用逗号分隔"}],
    "stream": true
  }'
-N 关闭 curl 缓冲。若能看到 data: {...} 一行行滚出来、并以 data: [DONE] 结束,说明流式链路正常。
阶段 2:CLI / SDK 接入(Python 与 Node.js)
Python(官方 openai SDK ≥ 1.x)
# file: quickstart.py
# 说明:仅改环境变量即可切换上游模型,业务代码零改动
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["OPENLINEAR_API_KEY"],
    base_url=os.environ["OPENLINEAR_BASE_URL"],   # 注意:SDK 内部会自行拼接 /chat/completions
    timeout=60.0,
    max_retries=2,
)

# ---------- 非流式 ----------
resp = client.chat.completions.create(
    model=os.environ.get("MODEL_ID", "your-model-id"),
    messages=[{"role": "user", "content": "你好,请自我介绍一下"}],
    temperature=0.7,
)
print(resp.choices[0].message.content)
print("usage:", resp.usage)   # 用于成本归因

# ---------- 流式 ----------
stream = client.chat.completions.create(
    model=os.environ.get("MODEL_ID", "your-model-id"),
    messages=[{"role": "user", "content": "写一个 10 行的快速排序"}],
    stream=True,
)
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta:
        print(delta, end="", flush=True)
print()
# 运行
pip install --upgrade openai
python quickstart.py
Node.js(TypeScript)
// file: quickstart.ts
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.OPENLINEAR_API_KEY!,
  baseURL: process.env.OPENLINEAR_BASE_URL!, // 注意此处是 baseURL(大写 URL)
  timeout: 60_000,
  maxRetries: 2,
});

const stream = await client.chat.completions.create({
  model: process.env.MODEL_ID ?? "your-model-id",
  messages: [{ role: "user", content: "用一个表格对比 REST 与 SSE" }],
  stream: true,
});

for await (const chunk of stream) {
  process.stdout.write(chunk.choices[0]?.delta?.content ?? "");
}
npm i openai
npx tsx quickstart.ts
阶段 3:IDE 插件接入(把模型装进编辑器)
绝大多数 AI 编码插件都支持「OpenAI 兼容端点」,配置项只有三项:Base URL、API Key、Model。
Cline / Roo Code(VS Code)
在插件设置中选择 OpenAI Compatible:
{
  "provider": "openai-compatible",
  "baseUrl": "https://api.nonelinear.com.cn/v1",
  "apiKey": "sk-xxxxxxxxxxxxxxxx",
  "modelId": "your-model-id",
  "modelInfo": {
    "maxTokens": 8192,
    "supportsImages": true,
    "supportsStreaming": true
  }
}
Continue(~/.continue/config.json)
{
  "models": [
    {
      "title": "Nonelinear · 通用对话",
      "provider": "openai",
      "model": "your-model-id",
      "apiBase": "https://api.nonelinear.com.cn/v1",
      "apiKey": "sk-xxxxxxxxxxxxxxxx"
    },
    {
      "title": "Nonelinear · 长上下文",
      "provider": "openai",
      "model": "your-long-context-model-id",
      "apiBase": "https://api.nonelinear.com.cn/v1",
      "apiKey": "sk-xxxxxxxxxxxxxxxx",
      "contextLength": 200000
    }
  ],
  "tabAutocompleteModel": {
    "title": "补全专用(低配额成本模型)",
    "provider": "openai",
    "model": "your-autocomplete-model-id",
    "apiBase": "https://api.nonelinear.com.cn/v1",
    "apiKey": "sk-xxxxxxxxxxxxxxxx"
  }
}
工程建议:补全(Autocomplete)和对话(Chat)用两把不同的 Key。补全请求量大且高频,一旦额度和对话共用,很容易在写代码时把额度打光。
Cursor / Cherry Studio 等 GUI 工具
在「Models」设置中:
- 打开 OpenAI API 的 Override Base URL 开关;
- 填入
https://api.nonelinear.com.cn/v1; - 填入 API Key;
- 点击 Verify / Fetch Models,成功后手动添加需要的模型 ID。
阶段 4:低代码 / 应用编排平台接入(Dify 为例)
Dify、FastGPT、n8n 这类平台通常通过「OpenAI-API-compatible」供应商接入。
在 Dify → 设置 → 模型供应商 → OpenAI-API-compatible 中填写:
# 概念示例:字段名以平台 UI 实际为准
provider: openai-api-compatible
credentials:
  api_key: sk-xxxxxxxxxxxxxxxx
  base_url: https://api.nonelinear.com.cn/v1
  # 注意:部分版本需要填到 /v1 为止,不要带 /chat/completions
model_config:
  model_name: your-model-id
  context_size: YOUR_CONTEXT_SIZE
  max_tokens_to_sample: YOUR_MAX_TOKENS
  function_calling_type: tool_call    # 视上游模型能力选择
  streaming: true
配置完成后,先用平台自带的「测试连接」跑一次,再建应用——否则排查时会同时面对平台层和网关层两个变量。
阶段 5:后端服务封装(生产形态)
生产环境不要在每个 Service 里裸调 SDK,建议做一层薄封装:
# file: llm_client.py
import os, time, logging
from openai import OpenAI, APIStatusError, APITimeoutError, RateLimitError

logger = logging.getLogger("llm")

_client = OpenAI(
    api_key=os.environ["OPENLINEAR_API_KEY"],
    base_url=os.environ["OPENLINEAR_BASE_URL"],
    timeout=float(os.environ.get("LLM_TIMEOUT", "60")),
    max_retries=0,   # 关闭 SDK 内建重试,由业务层统一控制退避策略
)

# 可重试的状态码:限流、上游 5xx、网关超时
RETRYABLE = {408, 429, 500, 502, 503, 504}

def chat(messages, model=None, max_retries=3, **kwargs):
    model = model or os.environ.get("LLM_MODEL", "your-model-id")
    last_err = None
    for attempt in range(max_retries):
        try:
            t0 = time.perf_counter()
            resp = _client.chat.completions.create(
                model=model, messages=messages, **kwargs
            )
            logger.info(
                "llm_ok model=%s cost_ms=%d prompt=%s completion=%s",
                model, int((time.perf_counter() - t0) * 1000),
                resp.usage.prompt_tokens, resp.usage.completion_tokens,
            )
            return resp
        except RateLimitError as e:          # 429:指数退避
            last_err = e
            time.sleep(min(2 ** attempt, 8))
        except APIStatusError as e:
            last_err = e
            if e.status_code not in RETRYABLE:
                raise                        # 400/401/403 立即失败,重试无意义
            time.sleep(min(2 ** attempt, 8))
        except APITimeoutError as e:
            last_err = e
            time.sleep(1)
    raise RuntimeError(f"LLM 调用重试 {max_retries} 次仍失败") from last_err
配套 .env(不要提交进 Git):
# .env  —— 加入 .gitignore
OPENLINEAR_BASE_URL=https://api.nonelinear.com.cn/v1
OPENLINEAR_API_KEY=sk-xxxxxxxxxxxxxxxx
LLM_MODEL=your-model-id
LLM_TIMEOUT=60
# .gitignore
.env
.env.*
!.env.example
四、主体三:生产环境踩坑与排查指南
下面每一条都来自常见故障场景,按“现象 → 根因 → 修复”组织。
坑 1:Base URL 多一个 /v1,全站 404
现象:404 page not found 或 Invalid URL。
根因:SDK 会自动拼接 /chat/completions。若你把 Base URL 写成 https://xxx/v1/chat/completions,最终请求会变成 /v1/chat/completions/chat/completions。
修复:Base URL 止于 /v1,且末尾不要带斜杠。
# 自检
echo "${OPENLINEAR_BASE_URL}" | grep -E '/v1/?$' || echo "❌ Base URL 格式不对"
坑 2:环境变量被更高优先级的旧值覆盖
现象:本地能通,服务器上 401;或者换了 Key 依然报旧 Key 的错。
根因:OPENAI_API_KEY / OPENAI_BASE_URL 可能同时在 .bashrc、.env、Docker --env-file、K8s ConfigMap、systemd Environment= 里各存一份,优先级不同。
排查:
# Linux / macOS:看进程实际拿到的值(以 PID 1234 为例)
tr '\0' '\n' < /proc/1234/environ | grep -E 'OPENAI|OPENLINEAR'

# Docker
docker exec -it <container> env | grep -E 'OPENAI|OPENLINEAR'

# K8s
kubectl exec -it <pod> -- env | grep -E 'OPENAI|OPENLINEAR'

# Windows PowerShell
Get-ChildItem Env: | Where-Object Name -match 'OPENAI|OPENLINEAR'
修复:全链路只保留一份来源,代码里统一读同一个变量名。
坑 3:模型 ID 大小写 / 别名不一致
现象:400 model_not_found。
根因:同一模型 ID 的大小写、连字符与快照后缀差异,可能导致上游解析结果不同。
修复:启动时拉一次模型列表做校验,把可用 ID 缓存下来,别硬编码。
curl -sS "$OPENLINEAR_BASE_URL/models" -H "Authorization: Bearer $OPENLINEAR_API_KEY" \
  | python -c "import sys,json;print('\n'.join(m['id'] for m in json.load(sys.stdin)['data']))"
坑 4:流式输出在生产环境“卡住”
现象:本地流式正常,上线后用户看到光标转圈十几秒才一次性刷出全文。
根因:Nginx / Ingress 默认开启 proxy_buffering,把 SSE 攒在缓冲区里。
修复:
location /v1/ {
    proxy_pass         https://api.nonelinear.com.cn/v1/;
    proxy_http_version 1.1;
    proxy_set_header   Connection "";
    proxy_buffering    off;
    proxy_cache        off;
    proxy_read_timeout 300s;
    chunked_transfer_encoding on;
}
K8s Ingress(Nginx)加注解:
metadata:
  annotations:
    nginx.ingress.kubernetes.io/proxy-buffering: "off"
    nginx.ingress.kubernetes.io/proxy-read-timeout: "300"
坑 5:HTTP_PROXY 劫持了出网请求
现象:本地能通,容器内超时;或返回 502。
根因:基础镜像里残留了公司代理配置,httpx/axios 默认遵守 HTTP_PROXY。
排查:
env | grep -i proxy
curl -v --noproxy '*' "$OPENLINEAR_BASE_URL/models" -H "Authorization: Bearer $OPENLINEAR_API_KEY"
修复:
# 临时绕过
export NO_PROXY="$NO_PROXY,api.nonelinear.com.cn"
# Python 侧强制不使用代理
# client = OpenAI(..., http_client=httpx.Client(trust_env=False))
坑 6:令牌权限与 IP 白名单导致的 403
现象:401 变成 403,或换台机器就报错。
根因:令牌绑定了 IP 白名单 / 模型白名单,而 CI Runner、Serverless 出口 IP 是动态的。
修复:为 CI / 定时任务建 独立令牌,关闭 IP 限制但设置严格的额度与模型范围;生产令牌保留 IP 绑定。永远不要复用同一把 Key。
坑 7:日志与临时文件泄漏 Key
现象:docker logs、git log、异常堆栈里出现明文 sk-。
根因:print(client)、请求体整体打日志、.env 被提交。
修复:
# 已提交过 .env 的,从历史中清除
git filter-repo --path .env --invert-paths

# 全仓扫描明文 Key
grep -rIn --exclude-dir=.git -E 'sk-[A-Za-z0-9]{20,}' .

# CI 中加 pre-commit 拦截(.pre-commit-config.yaml 示例见下)
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/gitleaks/gitleaks
    rev: v8.18.0
    hooks:
      - id: gitleaks
同时清理 ~/.cache、/tmp 下的临时会话文件,避免镜像打包时把本地配置带进去。
坑 8:跨域与前端直连
现象:浏览器控制台报 CORS policy。
根因:前端直接调网关。
修复:任何时候都不要把 Key 放在前端。由 BFF / 后端服务持有 Key 并中转,前端只与自己的后端通信。
坑 9:重试放大故障
现象:上游限流时,服务瞬间雪崩。
根因:SDK 内建重试 + 业务层重试 + 网关重试,三层叠加。
修复:只保留一层重试(推荐业务层),并加入指数退避 + 抖动,对 400/401/403 立即失败不做重试。
五、结尾:不同角色的选型与落地建议
个人极客 / 独立开发者 优先追求“零配置跑起来”。直接复制阶段 1 的三段 curl 验证通,然后用一把不限模型的 Key 接入 Cherry Studio 或 Continue 即可。唯一要认真做的一件事:给 Key 设一个额度上限,避免通宵跑 Agent 时账单失控。
中小型研发团队(3~20 人)
核心诉求是“可归因”。建议:一人一 Key + 一个环境一 Key(dev / staging / prod),并在命名上强制加前缀。代码里统一走阶段 5 的封装层,把 usage 写进日志。这样月度成本可以按人、按项目、按模型三个维度拆开,比“分摊总数”靠谱得多。
企业级架构师
关注点应放在治理而非接入:把网关当作内部统一的 LLM 出口,向上提供一层公司自有的 llm-gateway SDK;在网关令牌层面做模型白名单与额度隔离;在 Nginx / Ingress 层解决 SSE 缓冲与超时;把 trace id 打通到 APM;并对令牌做生命周期管理(定期轮换、离岗吊销)。不要让任何一个业务团队直接持有裸 Key。
快速开始清单(可直接抄走)
□ 控制台注册 → 创建令牌(额度 + 模型范围 + IP 白名单)
□ 设置环境变量 OPENLINEAR_BASE_URL / OPENLINEAR_API_KEY
□ curl /models  → 200
□ curl /chat/completions(非流式)→ 200
□ curl /chat/completions(stream)→ 收到 [DONE]
□ 接入 IDE 插件,Fetch Models 成功
□ 后端封装:超时 + 单层重试 + usage 日志
□ Nginx:proxy_buffering off
□ .gitignore 加 .env,CI 加密钥扫描
官方文档与最新接入说明:https://docs.nonelinear.com.cn/ 建议以文档中的控制台截图与模型列表为准,本文示例中的
BASE_URL、model字段请按实际环境替换。