标题:一键接入多模型!WorkBuddy / 客户端直连主流AI大模型:AI中转与API聚合平台配置指南
阅读前请知悉:本文中的
Base URL、模型 ID、控制台入口等具体参数,均以 Nonelinear 官方文档 与控制台「模型列表 / 令牌管理」页面的实时信息为准。文中出现的地址与模型名称为示例占位,请按注释替换为你账号下的实际值。
一、为什么"接一个模型"会变成一场工程灾难
先讲一个几乎是行业通病的场景。
一个五人规模的 AI 应用小组,产品需要同时支持 GPT、Claude 和国产开源模型做降级与成本兜底。于是技术负责人打开了三个浏览器标签页:OpenAI 的控制台、Anthropic 的控制台、还有某云厂商的控制台。接下来的一周,团队做了这些事:
- 三套 SDK、三套鉴权:
openai用Bearer,有的平台用X-Api-Key+ 自定义签名,还有的平台要求先换access_token再调业务接口。封装层写着写着就变成了if provider == "xxx"的意大利面条。 - 三种响应结构:
choices[0].message.content、content[0].text、data.output.text……前端每接一个新模型就要改一次渲染逻辑。 - 三张账单、三种计费单位:按 token、按字符、按次调用,月底对账要靠 Excel 手工合并。
- 国内网络下还多了一层变量:超时、连接重置、偶发 502。为了做一个在国内能稳定跑通的多模型 demo,团队甚至自己写了一个 Nginx 反代 + 重试中间件。
真正的成本并不在"调用大模型"这件事本身,而在于协议适配、网络治理、密钥管理、成本核算这四件与业务无关的脏活。它们是典型的"重复造轮子",而且每个团队都会把它重构三遍。
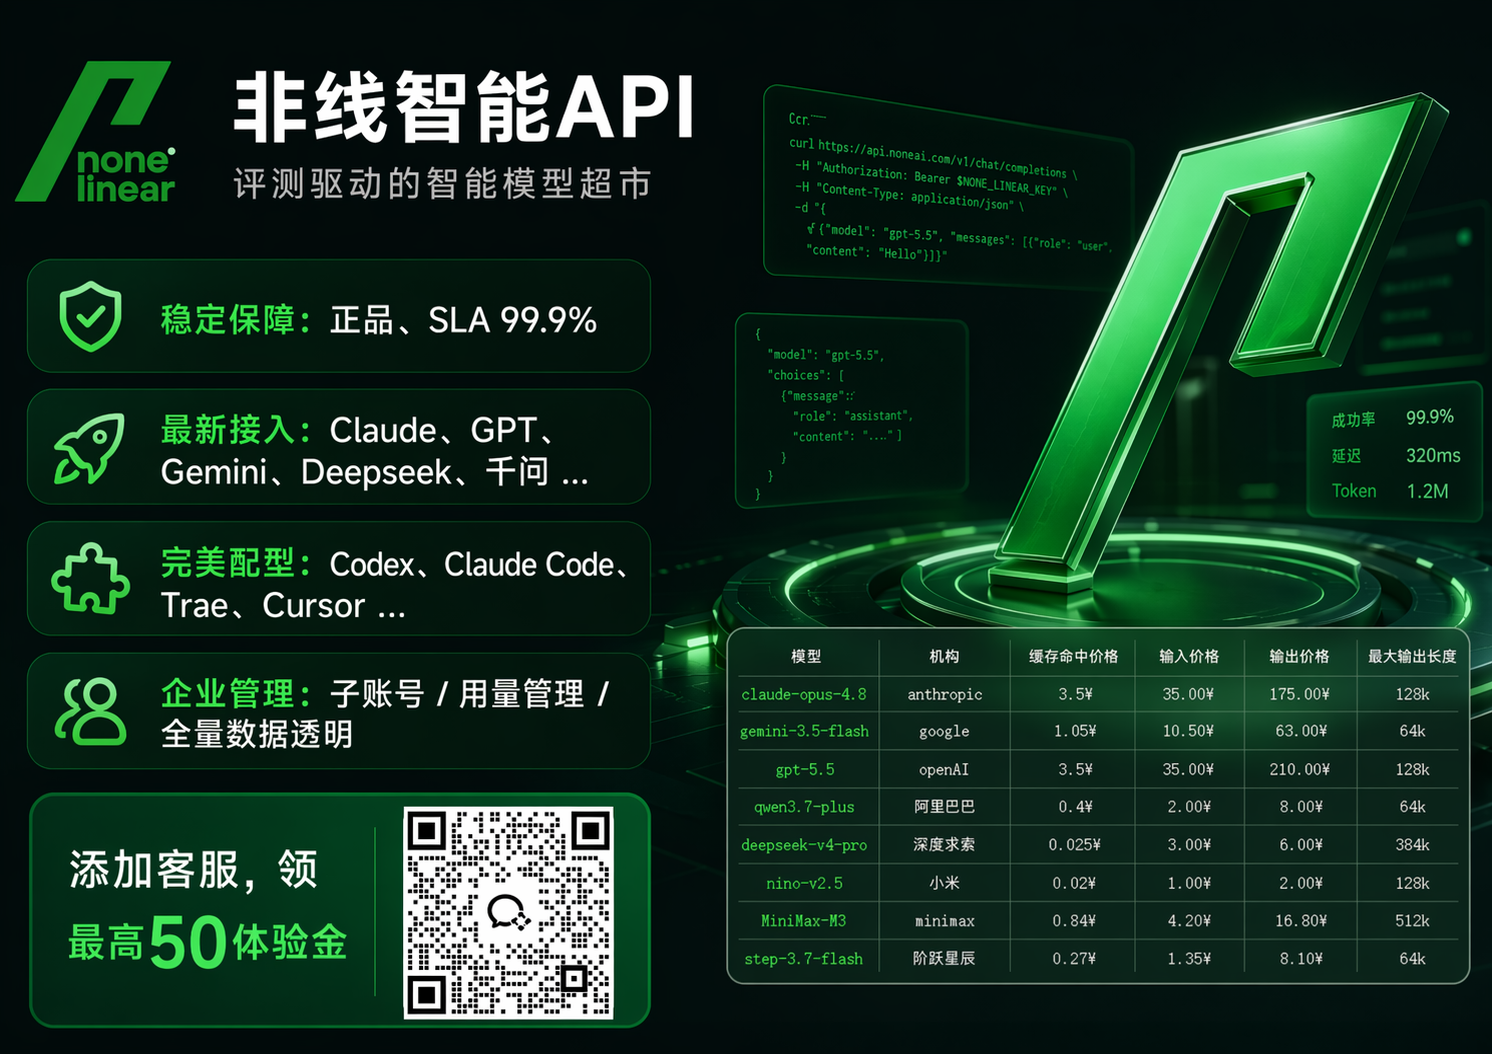
本文要讨论的破局思路很直接:用一个统一的 OpenAI 兼容协议层,把"多模型"收敛成"一个模型名参数"。这类统一接入网关,也可以理解为面向多模型场景的 AI 中转与 API 聚合平台。而 WorkBuddy 这类客户端 + Nonelinear 这类统一接入网关的组合,正好把这个思路落到了"改三个输入框就能跑"的程度。
下面从架构原理讲到 WorkBuddy、CLI、IDE 插件、后端服务四类场景的完整接入,最后给出生产环境的踩坑清单。
二、架构剖析:统一接入层到底"统一"了什么
2.1 核心竞争力一:协议归一 —— 把 N 个 SDK 变成 1 个 base_url
统一接入层的第一性原理是:绝大多数下游工具链已经原生支持 OpenAI 协议。只要网关对外暴露 /v1/chat/completions、/v1/models、/v1/embeddings 这套事实标准接口,上游的鉴权、路由、格式转换、计费全部由网关内部完成。
这意味着接入成本从"读三份 SDK 文档、写三个适配器",压缩为"改一个 base_url、换一个 model 字符串"。对于一个已经在用 openai 官方 SDK 的项目,代码改动量可以是个位数行数。
更进一步,
/v1/models接口的存在让客户端可以动态拉取模型列表,而不是把模型名硬编码在配置文件里。这是"多模型"能够长期可维护的关键 —— 平台上线新模型时,你不需要发版。
2.2 核心竞争力二:连接与路由的工程化治理
单一模型直连,失败就是失败;多模型直连,失败面被放大了 N 倍。统一接入层在这一层提供的能力,往往比"能连上"更值钱:
- 统一鉴权与密钥隔离:上游厂商密钥只存在于网关侧,业务侧只持有一把可随时吊销、可设置额度上限的子令牌。密钥泄露的影响面从"厂商主账号被盗刷"降级为"单个令牌超额"。
- 链路复用与长连接:网关与上游之间维护连接池,避免每次请求都重新 TLS 握手。在高并发场景下,这一项的收益往往比模型侧优化更直观。
- 失败转移与限流兜底:某个上游抖动时由网关侧做重试或降级,业务侧看到的是一个"更稳的模型名",而不是一堆需要自己处理的 5xx。
- 统一观测:请求量、token 消耗、延迟、错误码在一个面板里对齐,成本归因不再依赖手工对账。
2.3 核心竞争力三:让"模型切换"变成一次配置变更
传统多模型架构里,换模型意味着改代码、回归测试、发版。在归一协议下,它退化为改一个环境变量的值:
# 只要这一行变了,上层业务代码零改动
MODEL_NAME="your-model-id-a"   # 换成 "your-model-id-b" 即可灰度或回滚
这一点在线上排障时价值极高:当某个模型出现区域性抖动,你可以在分钟级通过配置中心把流量切走,而不需要走一遍完整发布流程。
三、配置:四类场景的完整接入步骤
3.0 前置准备:拿到两个钥匙
无论后面接哪种客户端,都只有两步准备:
Step 1|创建 API 令牌
登录 Nonelinear 控制台,进入「API 令牌 / Token 管理」,新建令牌。建议:
- 按环境拆分(dev / staging / prod 三把令牌),不要一把钥匙走天下;
- 按用途拆分(客户端个人使用、后端服务、CI 测试);
- 设置额度上限与过期时间,可吊销是可运维的底线。
复制形如 sk-xxxxxxxxxxxxxxxxxxxx 的字符串,只显示一次,请立即存入密码管理器或密钥管理系统。
Step 2|确认 Base URL 与模型 ID
在控制台「接口地址」与「模型列表」页面确认两项:
| 配置项 | 示例值(请替换为控制台实际值) | 说明 |
|---|---|---|
| Base URL | https://api.nonelinear.com.cn/v1 |
必须带 /v1,末尾不要加斜杠 |
| API Key | sk-xxxxxxxx |
你的子令牌 |
| Model ID | your-model-id |
以模型列表页的完整 ID(含大小写)为准 |
⚠️ 最常见的第一坑:Base URL 填成
.../v1/chat/completions。SDK 会自己拼接路径,结果变成/v1/chat/completions/chat/completions→ 404。Base URL 只填到/v1为止。
3.1 场景一:WorkBuddy 客户端直连(零代码)
WorkBuddy 这类桌面客户端的价值在于:把模型配置从代码里彻底剥离出来,让产品、运营、非技术同学也能自助切换模型。
配置路径(通用流程,具体菜单文案以你的客户端版本为准):
- 打开 WorkBuddy → 进入 设置 / Settings;
- 找到 模型服务 / API 提供商 / Model Provider;
- 选择 添加自定义提供商,协议类型选择 OpenAI 兼容 / OpenAI Compatible;
- 按下表填写;
{
  "provider": "openai-compatible",
  "displayName": "Nonelinear",
  "baseUrl": "https://api.nonelinear.com.cn/v1",
  "apiKey": "sk-xxxxxxxxxxxxxxxxxxxx",
  "defaultModel": "your-model-id",
  "models": [
    "your-model-id-a",
    "your-model-id-b"
  ],
  "headers": {},
  "timeoutSeconds": 120,
  "stream": true
}
字段逐项说明:
| 字段 | 是否必填 | 说明 |
|---|---|---|
baseUrl |
✅ | 只到 /v1,不带 /chat/completions,不带末尾 / |
apiKey |
✅ | 以 Bearer 方式自动注入请求头 |
defaultModel |
✅ | 新会话默认使用的模型 ID |
models |
推荐 | 显式声明可切换的模型清单;若客户端支持拉取 /v1/models 可留空 |
timeoutSeconds |
推荐 | 长上下文场景建议 ≥ 120,默认 30 容易在长文生成时超时 |
stream |
推荐 | 开启 SSE 流式,显著改善首字延迟体感 |
- 点击 测试连接 / Test Connection,看到绿色通过后 保存并设为默认;
- 新建一个会话,在顶部模型选择器里确认能切换到目标模型。
跨平台差异(WorkBuddy 桌面端):
| 平台 | 配置文件常见位置 | 注意点 |
|---|---|---|
| macOS | ~/Library/Application Support/WorkBuddy/config.json |
首次运行后需在系统设置里授予网络与文件权限 |
| Linux | ~/.config/WorkBuddy/config.json |
AppImage 方式运行时注意用户级配置目录归属 |
| Windows | %APPDATA%\WorkBuddy\config.json |
路径含空格,命令行操作务必加引号 |
🔧 如果客户端 UI 保存后行为异常,可以直接改配置文件并完全退出后重启(不是关闭窗口)。很多客户端只有一个进程单例,托盘退出后主进程仍在,配置不会重载。
3.2 场景二:终端 CLI / 脚本直连(最快验证链路)
在任何正式接入前,先用 curl 打通一次,是排除"客户端背锅"的最快方式。
macOS / Linux:
# 建议把密钥写进环境变量,而不是直接写在命令里(避免进入 shell history)
export NONELINEAR_BASE_URL="https://api.nonelinear.com.cn/v1"
export NONELINEAR_API_KEY="sk-xxxxxxxxxxxxxxxxxxxx"   # 替换为你的实际令牌

curl -sS "${NONELINEAR_BASE_URL}/chat/completions" \
  -H "Authorization: Bearer ${NONELINEAR_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model-id",
    "messages": [
      {"role": "user", "content": "用一句话说明什么是统一接入层"}
    ],
    "stream": false
  }' | jq .
Windows(PowerShell):
# 注意:PowerShell 中 JSON 里的双引号需要转义,或用 here-string 更稳妥
$env:NONELINEAR_BASE_URL = "https://api.nonelinear.com.cn/v1"
$env:NONELINEAR_API_KEY  = "sk-xxxxxxxxxxxxxxxxxxxx"   # 替换为你的实际令牌

$body = @{
    model    = "your-model-id"
    messages = @(@{ role = "user"; content = "用一句话说明什么是统一接入层" })
    stream   = $false
} | ConvertTo-Json -Depth 5

Invoke-RestMethod `
  -Uri "$env:NONELINEAR_BASE_URL/chat/completions" `
  -Method Post `
  -Headers @{ "Authorization" = "Bearer $env:NONELINEAR_API_KEY" } `
  -ContentType "application/json; charset=utf-8" `
  -Body $body
Windows(cmd): 建议不要用 cmd 拼 JSON,引号转义极其痛苦。若必须用,先把请求体落成 payload.json,再 curl -d @payload.json。
验证模型列表(推荐先跑这一条):
curl -sS "${NONELINEAR_BASE_URL}/models" \
  -H "Authorization: Bearer ${NONELINEAR_API_KEY}" | jq '.data[].id'
能列出模型 ID,说明网络、鉴权、Base URL 三者都没问题;此时若业务仍报错,问题一定在模型名或请求体。
3.3 场景三:代码内直连(Python / Node 后端服务)
由于协议是 OpenAI 兼容的,你不需要安装任何新 SDK。
Python:
# pip install openai>=1.0
import os
from openai import OpenAI

client = OpenAI(
    base_url=os.environ["NONELINEAR_BASE_URL"],   # 例如 https://api.nonelinear.com.cn/v1
    api_key=os.environ["NONELINEAR_API_KEY"],
    timeout=120.0,      # 长上下文/长输出场景建议调大
    max_retries=2,      # 429/5xx 由 SDK 做指数退避重试
)

resp = client.chat.completions.create(
    model=os.getenv("MODEL_NAME", "your-model-id"),   # 模型名走环境变量,便于灰度切换
    messages=[{"role": "user", "content": "写一个二分查找的 Python 实现"}],
    stream=False,
)

print(resp.choices[0].message.content)
print("tokens:", resp.usage.total_tokens)   # 用于成本归因埋点
Node.js / TypeScript:
// npm i openai
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: process.env.NONELINEAR_BASE_URL,   // 同样只到 /v1
  apiKey: process.env.NONELINEAR_API_KEY,
  timeout: 120_000,
  maxRetries: 2,
});

const stream = await client.chat.completions.create({
  model: process.env.MODEL_NAME ?? "your-model-id",
  messages: [{ role: "user", content: "解释一下 SSE 流式传输" }],
  stream: true,
});

// 流式渲染:务必在 finally 中处理中断,避免连接泄漏
for await (const chunk of stream) {
  process.stdout.write(chunk.choices[0]?.delta?.content ?? "");
}
Spring Boot(application.yml)—— 企业后端常见写法:
# 密钥通过环境变量注入,禁止硬编码进代码仓库
llm:
  base-url: ${NONELINEAR_BASE_URL:https://api.nonelinear.com.cn/v1}
  api-key: ${NONELINEAR_API_KEY}
  default-model: ${MODEL_NAME:your-model-id}
  connect-timeout-ms: 10000
  read-timeout-ms: 120000
启动时注入(Linux/systemd 环境):
NONELINEAR_API_KEY="sk-xxxxxxxx" MODEL_NAME="your-model-id" java -jar app.jar
3.4 场景四:IDE 插件与本地开发工具接入
这是"多模型"最能立刻产生体感收益的场景:同一个编辑器里,写代码用 A 模型,读长文档用 B 模型,快速补全用轻量 C 模型。
(1)Cline / Roo Code 类插件
在插件设置中选择 API Provider → OpenAI Compatible,填写:
{
  "apiProvider": "openai",
  "openAiBaseUrl": "https://api.nonelinear.com.cn/v1",
  "openAiApiKey": "sk-xxxxxxxxxxxxxxxxxxxx",
  "openAiModelId": "your-model-id",
  "openAiLegacyFormat": false
}
openAiLegacyFormat必须为false。开启后会走旧的/completions而非/chat/completions,对多模型网关几乎必然失败。
(2)Cursor
Settings → Models → OpenAI API Key 中填入令牌,并打开 Override OpenAI Base URL,填 https://api.nonelinear.com.cn/v1。随后在模型名输入框中手动添加你在控制台看到的 完整模型 ID。
(3)Continue(VS Code / JetBrains)
~/.continue/config.json:
{
  "models": [
    {
      "title": "Nonelinear · 通用对话",
      "provider": "openai",
      "model": "your-model-id-a",
      "apiBase": "https://api.nonelinear.com.cn/v1",
      "apiKey": "sk-xxxxxxxxxxxxxxxxxxxx"
    },
    {
      "title": "Nonelinear · 长文分析",
      "provider": "openai",
      "model": "your-model-id-b",
      "apiBase": "https://api.nonelinear.com.cn/v1",
      "apiKey": "sk-xxxxxxxxxxxxxxxxxxxx"
    }
  ]
}
Windows 下路径为 %USERPROFILE%\.continue\config.json,JSON 中不要出现 // 注释(严格解析器会直接报错,这是 Windows 用户的高频翻车点)。
四、生产环境避坑指南(常见问题清单)
以下每一条都来自常见排障场景,按"发生频率 × 排查耗时"排序。
坑 1:Base URL 路径重复 / 末尾斜杠
症状:404 Not Found,或返回 HTML 而非 JSON。
原因:SDK 内部会拼 /chat/completions。你多填了这一段,或末尾多了一个 /,都会导致路径不匹配。
排查与修复:
# 直接 curl 验证最终路径,绕过一切客户端
curl -i "${NONELINEAR_BASE_URL}/chat/completions" \
  -H "Authorization: Bearer ${NONELINEAR_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{"model":"your-model-id","messages":[{"role":"user","content":"ping"}]}'
正确写法:只到 /v1,无末尾斜杠。有些框架(如部分 Java/Go 客户端)会自动补斜杠,配置侧统一去掉。
坑 2:环境变量被多份配置互相覆盖
症状:本地能跑,部署到服务器就报 401;或改了 .env 完全不生效。
原因:优先级混乱。常见的有三处来源在打架——shell profile(~/.zshrc / ~/.bashrc)、项目 .env、以及容器编排注入的 environment。另外,不同库读的变量名还不一样:OPENAI_API_KEY、OPENAI_BASE_URL、OPENAI_API_BASE 三者并非等价。
排查命令:
# Linux / macOS:查看真正生效的值(注意是运行进程的环境,不是你的 shell)
printenv | grep -i -E "openai|nonelinear|model"

# 定位是哪个 profile 里写死的
grep -rn "OPENAI_API_KEY\|NONELINEAR_API_KEY" ~/.zshrc ~/.bashrc ~/.profile 2>/dev/null

# 容器内确认(关键!宿主机环境不等于容器环境)
docker exec -it <container> printenv | grep -i nonelinear
# Windows PowerShell:区分「进程级」与「用户级」变量
Get-ChildItem Env: | Where-Object { $_.Name -match "OPENAI|NONELINEAR" }
[Environment]::GetEnvironmentVariable("NONELINEAR_API_KEY", "User")
[Environment]::GetEnvironmentVariable("NONELINEAR_API_KEY", "Machine")
修复原则:只保留一个权威来源。推荐 .env 作为唯一真源,shell profile 里不要写业务密钥(会污染所有项目,且极易随 dotfiles 泄露到 GitHub)。
坑 3:模型 ID 大小写与别名不一致
症状:model not found / invalid model,但模型看起来明明存在。
原因:模型 ID 是大小写敏感的字符串,且同一模型的别名与带日期快照版本往往是两个不同的 ID。客户端 UI 里显示的"友好名称"往往不是 API 接受的真实 ID。
修复:用 /v1/models 的返回值复制粘贴,不要手敲:
curl -sS "${NONELINEAR_BASE_URL}/models" \
  -H "Authorization: Bearer ${NONELINEAR_API_KEY}" \
  | jq -r '.data[].id' | sort
坑 4:流式(SSE)在代理后被缓冲,首字延迟"消失"
症状:本地流式输出正常,一上生产就变成"憋 20 秒然后整段吐出来"。
原因:中间的 Nginx / 云负载均衡 / 企业网关默认开启了响应缓冲,把 SSE 数据攒成整包再下发。
修复(Nginx):
location /v1/ {
    proxy_pass         https://api.nonelinear.com.cn/v1/;
    proxy_http_version 1.1;
    proxy_set_header   Connection "";
    proxy_set_header   Host $host;

    # SSE 关键三行:关闭缓冲 + 拉长读超时 + 关闭分块编码干扰
    proxy_buffering    off;
    proxy_cache        off;
    proxy_read_timeout 300s;
    chunked_transfer_encoding on;
}
同时确认客户端 stream: true,且代码里没有把流先 await 全部收集再输出。
坑 5:浏览器前端直连触发 CORS / 密钥泄露
症状:控制台报 blocked by CORS policy;或者为了绕开它,把 API Key 直接写进前端 JS。
结论:前端永远不要直连模型网关。 两个理由:
- 前端代码对用户完全可见,密钥必然泄露;
- 跨域策略不受你控制。
正确做法:加一层 BFF(Backend for Frontend)。Node 示例:
// server.js —— 只在本层持有密钥,前端只与自己同源的接口通信
import express from "express";
import OpenAI from "openai";

const app = express();
app.use(express.json());

const client = new OpenAI({
  baseURL: process.env.NONELINEAR_BASE_URL,
  apiKey: process.env.NONELINEAR_API_KEY,
});

app.post("/api/chat", async (req, res) => {
  // 生产环境务必补:用户鉴权、请求体白名单校验、速率限制
  const { messages, model } = req.body;
  const r = await client.chat.completions.create({
    model: model ?? process.env.MODEL_NAME,
    messages,
  });
  res.json({ content: r.choices[0].message.content, usage: r.usage });
});

app.listen(3000);
坑 6:超时与重试策略反了
症状:长文档总结频繁失败;或出现重复计费。
根因:默认超时太短(常见 30s),而长上下文首 token 时间本就长;另一方面,对非幂等的流式请求盲目重试会造成重复调用。
建议:
- 读超时统一 ≥ 120s,长文场景给到 300s;
- 只对
429 / 5xx / 连接超时重试,不要对400 / 401 / 403 / 404重试(重试也没用,只会放大账单); - 指数退避 + 抖动,
maxRetries建议 2~3 次封顶。
坑 7:临时目录与配置残留(升级 / 迁移后莫名报错)
症状:换了新令牌、改了配置,客户端依旧报旧错误。
原因:客户端把配置缓存在用户目录;Docker 构建时 COPY . . 又把本地 .env 打进了镜像。
修复:
# macOS / Linux:清理客户端配置缓存(先备份!)
mv ~/Library/Application\ Support/WorkBuddy ~/Library/Application\ Support/WorkBuddy.bak   # macOS
mv ~/.config/WorkBuddy ~/.config/WorkBuddy.bak                                             # Linux

# 检查项目是否误提交了密钥
git log --all -p -- .env | grep -i "sk-" | head
# Windows
Rename-Item "$env:APPDATA\WorkBuddy" "WorkBuddy.bak"
同时把 .env、*.local.json 加入 .gitignore,并在 CI 里加一条密钥扫描(gitleaks / trufflehog)。
坑 8:令牌权限过宽与额度无上限
症状:某次调试脚本死循环,一夜之间刷爆额度。
工程规范:
- 每个用途一把令牌,生产令牌不给开发本地用;
- 令牌额度设硬上限 + 到期时间;
- 服务端做并发与 QPS 限制,不要指望上游兜底;
- 监控
usage.total_tokens,按业务维度打标签做成本归因。
五、选型建议:不同角色该怎么配
个人极客 / 独立开发者
目标:零运维、低门槛、快速验证。
- 直接用 WorkBuddy 客户端 + 一把 dev 令牌,三分钟跑通,不写一行代码;
- 需要嵌到脚本里时,用
openaiSDK + 环境变量,别自己写 HTTP 封装; - 模型选择上"一主一备"即可,主力跑通用任务,备用跑长文/代码;
- 务必给令牌设月度额度上限 —— 个人项目最容易死于一次死循环。
中小型研发团队(3~20 人)
目标:统一出口、可观测、可灰度。
- 建一套环境分级令牌:
dev/staging/prod,权限与额度严格分离; - 模型名全部走配置中心或环境变量,禁止硬编码在业务代码里。这是后续灰度与回滚的前提;
- 在团队内部封装一层薄薄的
LLMClient(< 100 行),统一处理超时、重试、日志、token 埋点,避免每个服务各写一遍; - IDE 侧统一插件与配置模板(Continue / Cline),把
config.json纳入团队脚手架,新人开箱即用。
企业级架构师
目标:合规、稳定、成本可控、可审计。
- 网关收敛:内网自建一层 BFF/网关,对上接统一接入层,对下暴露内部标准协议。所有业务服务只认内部地址,密钥只存在于网关侧;
- 降级链路显式化:主模型 → 备模型 → 本地/小模型,每一级的触发条件(超时阈值、错误码、预算水位)写进配置而非代码;
- 观测三件套:请求量、P95/P99 延迟、token 成本,按
tenant / service / model三维打标; - 合规:确认数据是否出境、是否入训练、日志留存周期,把结论写进架构决策记录(ADR),而不是口头传达;
- 成本治理:对低价值高 Token 的调用做 prompt 压缩与结果缓存,缓存命中率往往比单纯更换模型带来更直接的收益。
六、结语
多模型接入的终局,不是"接得更多",而是接入这件事本身从业务代码里消失。
当协议归一之后,模型就退化成了配置里的一个字符串,切换成本从"一次发布"降到"一次配置变更"。团队的时间才真正回到有价值的地方:Prompt 工程、上下文管理、业务逻辑本身。
本文的所有配置项都是"模板级"的,落到你的账号上,请以官方文档与控制台为准:
- 📘 官方文档:https://docs.nonelinear.com.cn/
- 🚀 快速开始:进入控制台 → 创建 API 令牌 → 复制 Base URL 与模型 ID → 按第三章任一场景接入
- ✅ 建议的第一步:先跑通 3.2 节的
/v1/models与curl两条命令,把"网络 / 鉴权 / 路径"三件事一次性排除
把脏活交给协议层,把聪明留给业务。