 正文:
hy4-preview版本表现:
- 测试题数:约1.5万
- 总分(准确率):74.7%
- 平均耗时(每次调用):95s
- 平均token(每次调用消耗的token):6352
- 平均花费(每千次调用的人民币花费):111.6
1、新旧对决
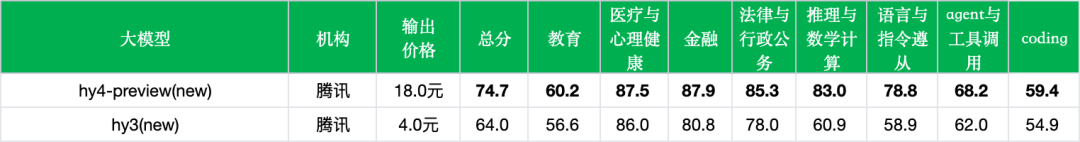
对比参照模型 hy3,hy4-preview 在 ReLE 中文综合评测中的变化非常剧烈:综合得分大幅跃升,榜单排名直冲前十五;但与之对应的,是单次调用的生成耗时、Token 消耗以及综合花费均出现了数倍乃至数十倍的上涨。具体对比数据如下:
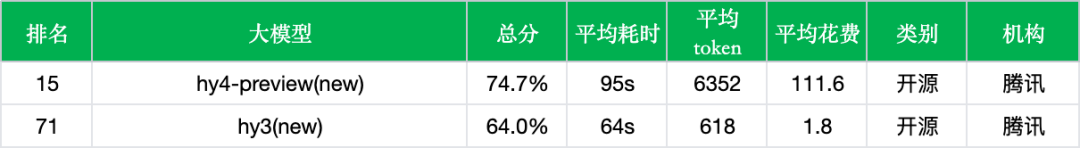
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
*输出价格单位: 元/百万token
- 总分与排名显著上移:hy4-preview 综合得分从 64.0% 提升至 74.7%(+10.7 个百分点),总榜排名直接从第 71 位跃升至第 15 位,实现了混元模型在中文综合榜单中的梯队跨越。
- 推理与数学增长大:推理与数学计算从 60.9% 飙升至 83.0%,大幅提升 22.1 个百分点,是所有细分项中进步最显著的维度,体现了新模型在数理逻辑与深度思考上的重度投入。
- 语言与指令遵循大幅强化:语言与指令遵从从 58.9% 提升至 78.8%(+19.9 个百分点)。对长指令解析、复杂格式约束和多要求任务的处理能力明显改善,是带动总分上涨的另一大主力。
- 专业领域全面补齐:法律与行政公务从 78.0% 提至 85.3%(+7.3 个百分点),金融从 80.8% 提至 87.9%(+7.1 个百分点),Agent 与工具调用从 62.0% 提至 68.2%(+6.2 个百分点),展现出均衡的能力结构改善。
- Coding稳步提升:Coding 从 54.9% 提升至 59.4%(+4.5 个百分点)。在 ReLE 中文评测数据下有所进步,但官方主打的代码仓库级工程能力,仍需结合后文多轮 Agent 基准综合评估。
- 教育与医疗平稳微升:教育从 56.6% 升至 60.2%(+3.6 个百分点),医疗与心理健康从 86.0% 升至 87.5%(+1.5 个百分点)。医疗基线原本较高,本轮主要以稳固为主。
- 响应耗时明显拉长:单次平均耗时从 64 秒增加到 95 秒(约为上一代的 1.5 倍)。慢思考和长上下文验证机制虽然换来了更高的准确率,但也牺牲了交互场景下的即时反馈速度。
- Token膨胀与成本跃升:平均单次 Token 生成量从 618 暴增至 6352(约 10 倍);输出单价由 4.0 元/百万token 调整为 18.0 元/百万token,综合千次调用成本从 1.8 元攀升至 111.6 元(约为上一代的 62 倍)。显然,hy4-preview 从hy3 的低成本定位,转向重度资源消耗的旗舰路线。
2、横向对比
在当前主流大模型的竞争格局中,hy4-preview 作为腾讯混元新一代开源旗舰,究竟处在什么梯队?我们从成本档位、代际梯队和开源商用三个维度进行横向剖析:
同成本档位对比
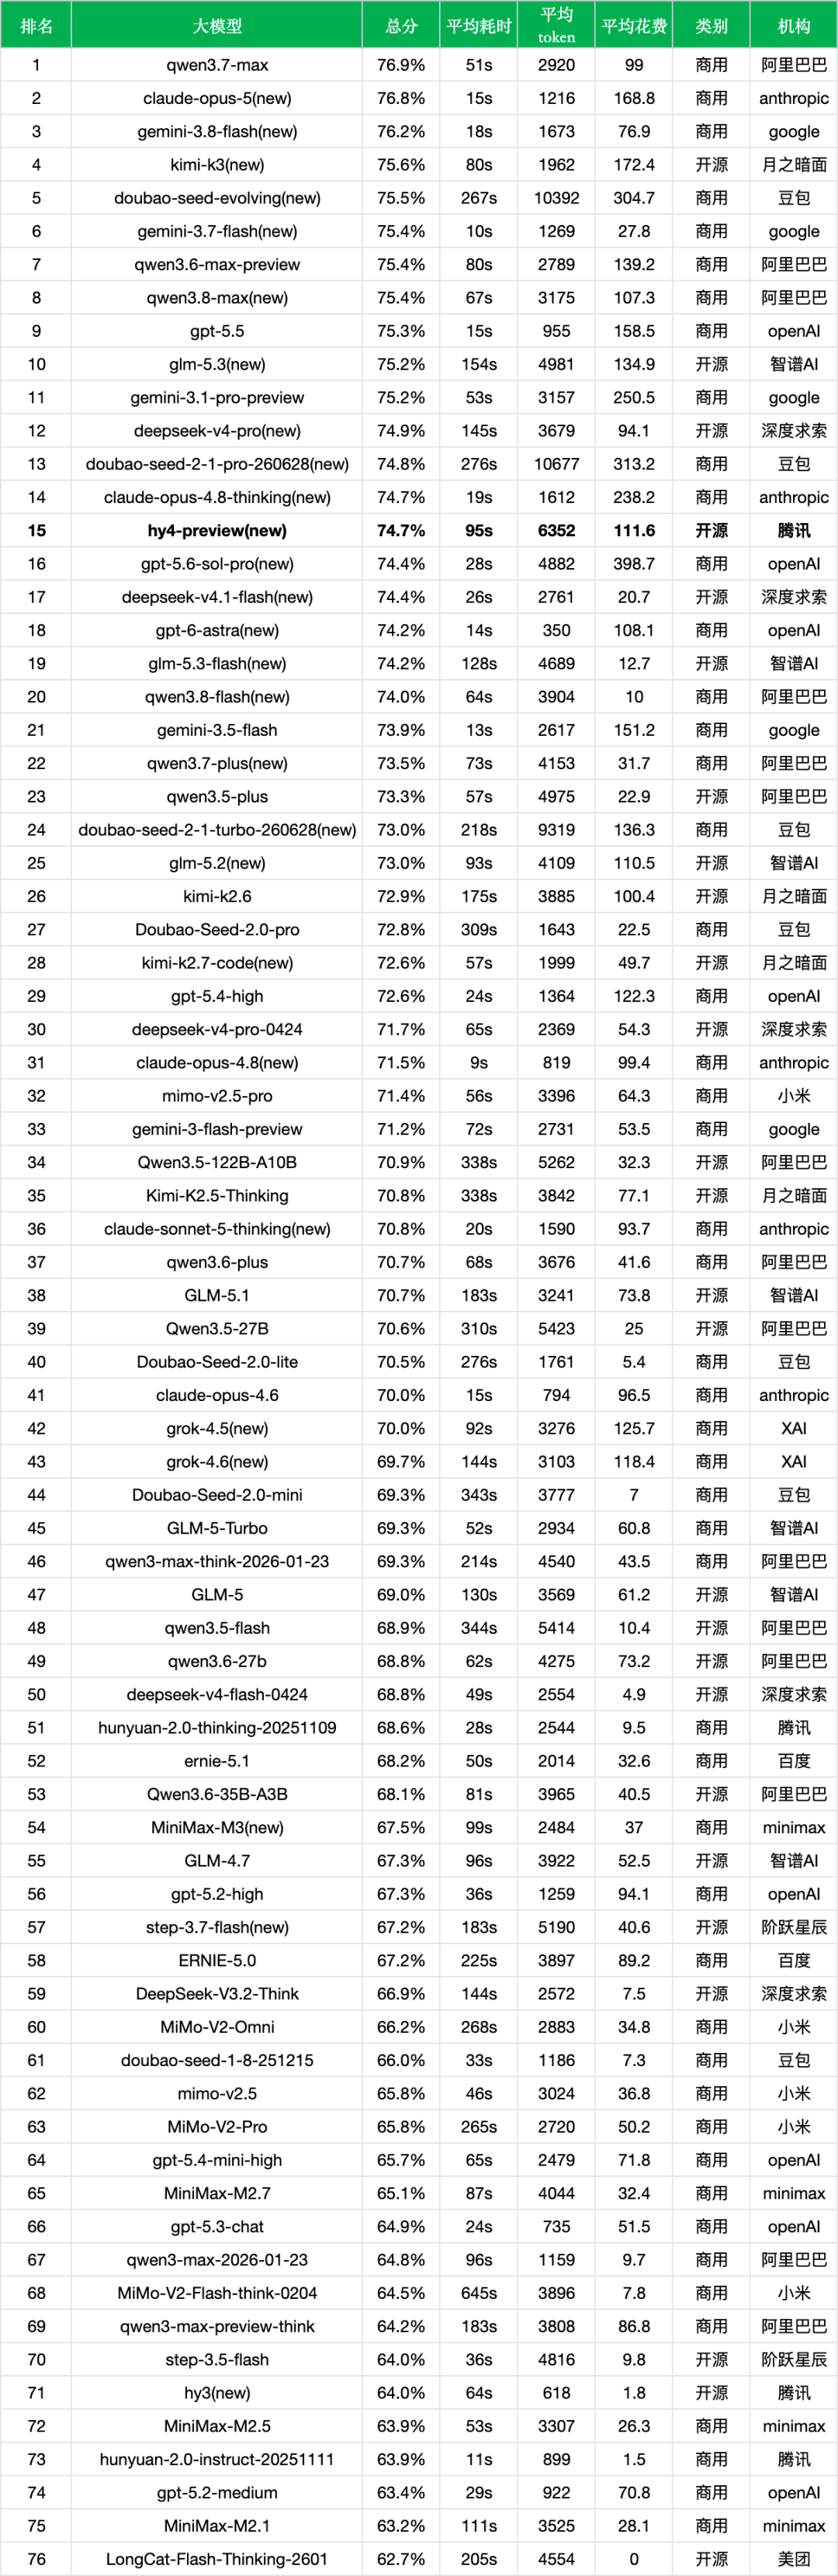
- 约90至130元档位表现稳健:在千次调用百元左右的高成本区间,hy4-preview(74.7%,111.6元)展现出了相当的竞争力。它在中文场景下,超过了同成本档位的 gpt-6-astra(74.2%,108.1元)、gpt-5.4-high(72.6%,122.3元)和 kimi-k2.6(72.9%,100.4元),但低于国内的 qwen3.7-max(76.9%,99元)、qwen3.8-max(75.4%,107.3元)与 deepseek-v4-pro(74.9%,94.1元)。
- 响应延迟不占优势:hy4-preview 平均耗时 95 秒,虽快于长思考开源竞品 deepseek-v4-pro(145s)、glm-5.3(154s)和 kimi-k2.6(175s),但明显慢于 qwen3.7-max(51s)、qwen3.8-max(67s)以及海外闭源模型 gpt-6-astra(14s)、gpt-5.4-high(24s)等。
- 向下看低成本Flash:对比当前势头迅猛的轻量选手 deepseek-v4.1-flash(74.4%,20.7元)、glm-5.3-flash(74.2%,12.7元)和 qwen3.8-flash(74.0%,10元),hy4-preview 虽在总分上略胜一筹(高 0.3~0.7 个百分点),但调用花费高出 5 至 10 倍。
新旧模型对比
- 混元产品线跃迁:上一代 hy3(64.0%,第71位)仅处在中下游,早期混元版本 hunyuan-2.0-thinking(68.6%)和 hunyuan-2.0-instruct(63.9%)也多在 50 名开外。hy4-preview(74.7%,第15位)的推出,直接将腾讯混元拉入榜单前列。
- 战略路线重塑:hy3 时代主打 1.8 元/千次的低成本跑批,而 hy4-preview 则转向追求高上限的生产力旗舰。两者不仅是版本迭代,更是产品定位上的转向。
开源/商用对比
- 开源阵营内部格局:在开源权重模型中,hy4-preview 位列前列,仅次于 kimi-k3、glm-5.3 与 deepseek-v4-pro,并优于一众轻量开源模型。
- 与商用闭源相比:面对 qwen3.7-max、claude-opus-5、gemini-3.8-flash 等商用天花板,hy4-preview 在中文综合理解上已咬得很紧,为企业私有化部署和深度微调提供了较高水准的开源底座选择。
- 业务落地权衡:高准确率与深度思考伴随着高延迟与高 Token 开销。如果业务追求快响应与成本,Flash 阵营依然是首选;如果看重私有权重、超长上下文以及复杂代码与智能体任务的上限,hy4-preview 的价值则更为突出。
3、官方评测
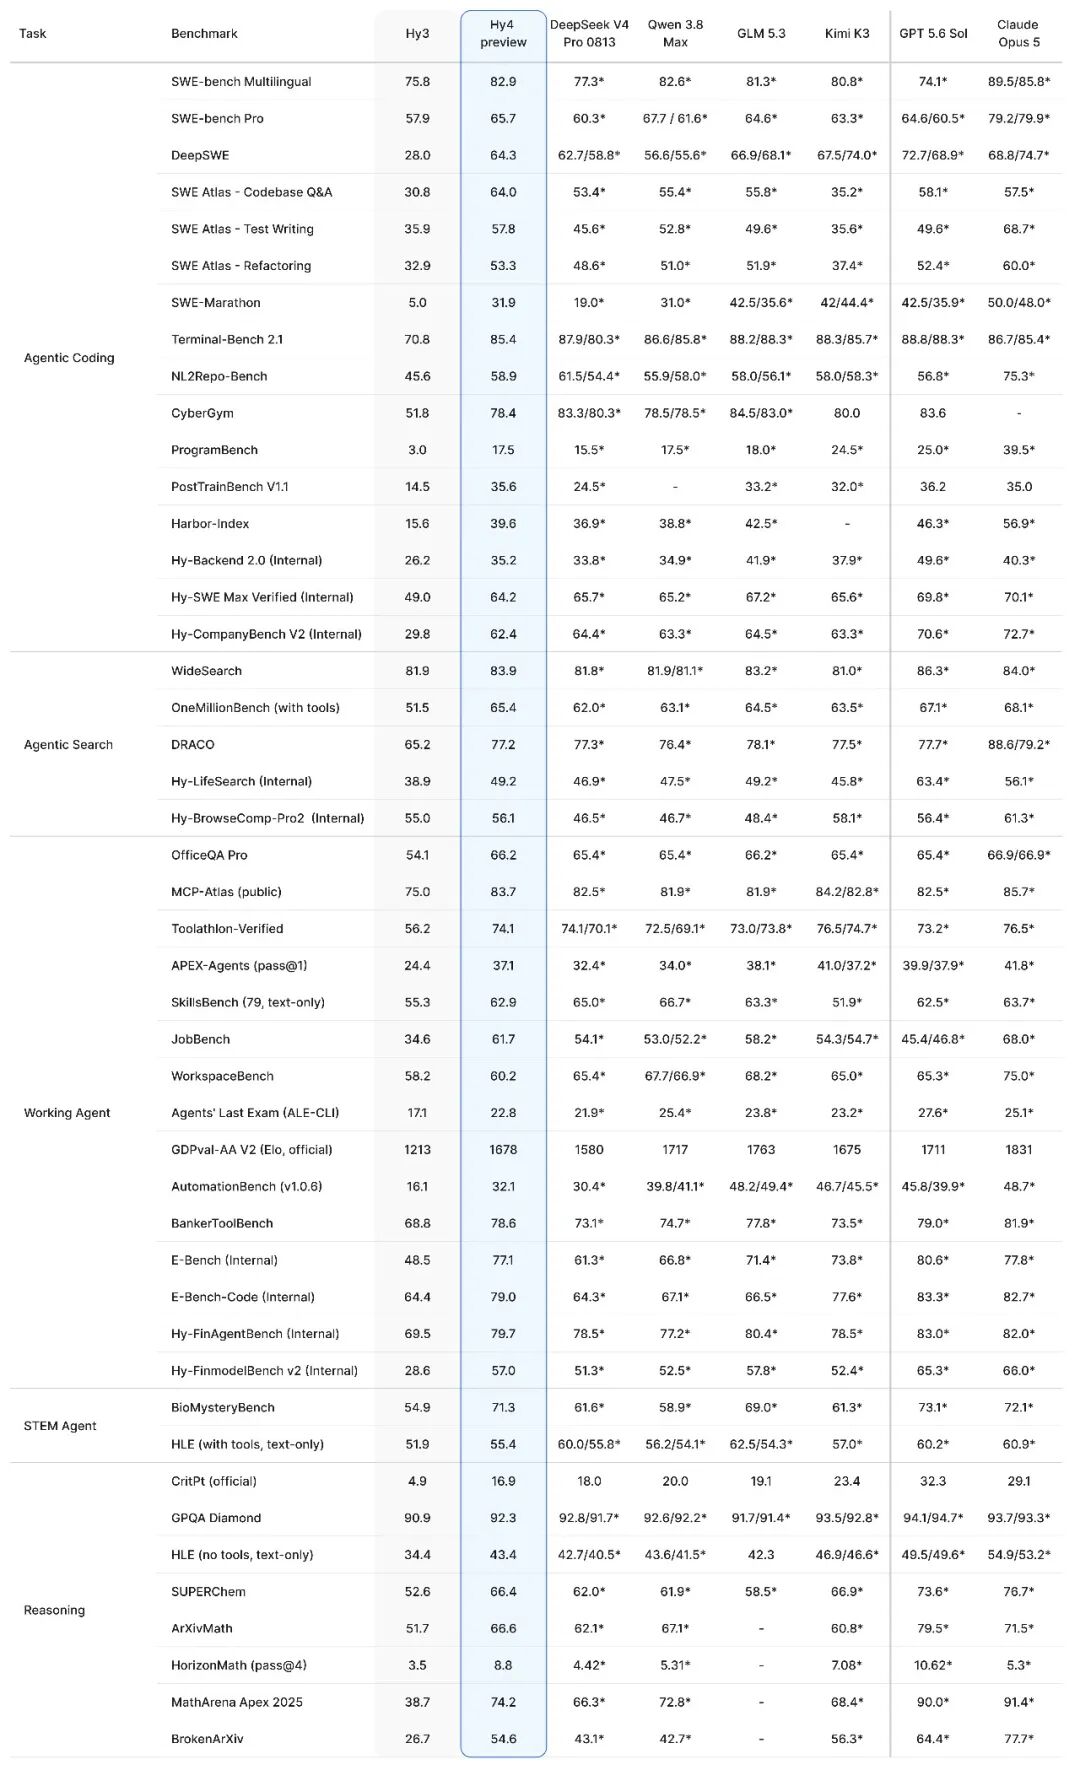
根据腾讯混元官方博客(https://hy.tencent.ai/research/hy4-preview)及开源公告,官方重点展示了模型在 MoE 架构创新、长程软件工程及复杂智能体任务上的基准数据:
软件工程与代码智能体
针对核心主打的软件工程场景,官方公布了一系列高难度代码智能体评测基准:
- 开源工程基准:SWE-bench Multilingual 达 82.9,SWE-bench Pro 达 65.7,DeepSWE 达 64.3,Terminal-Bench 2.1 达 85.4,NL2Repo-Bench 为 58.9,CyberGym 达 78.4。
- SWE Atlas代码全流程:Codebase Q&A 得分 64.0,测试用例编写(Test Writing)57.8,代码重构(Refactoring)53.3。
- 内部工程评测:在 Hy-SWE Max Verified(64.2)与 Hy-CompanyBench V2(62.4)等企业级真实场景中均取得稳健成绩。
Agent、搜索与办公任务
在复杂 Agent 与日常办公协作方面:
- 智能搜索与工具整合:WideSearch 达到 83.9,OneMillionBench(含工具调用)达 65.4,DRACO 达 77.2。
- 办公生产力套件:OfficeQA Pro 达 66.2,MCP-Atlas 为 83.7,Toolathlon-Verified 达 74.1,BankerToolBench 为 78.6,Hy-FinAgentBench 达 79.7。
- 真实工程盲测:官方组织 163 位内部专家对 203 个真实工程任务展开双盲评审,Hy4 preview 均分达 2.99/4(高于 GLM 5.3 的 2.92/4 与 Kimi K3 的 2.94/4),对 GLM 5.3 胜平负为 46.8%/12.8%/40.4%,对 Kimi K3 为 51.2%/7.9%/40.9%。
STEM与推理基准
在科研与高难度数理推理基准上:
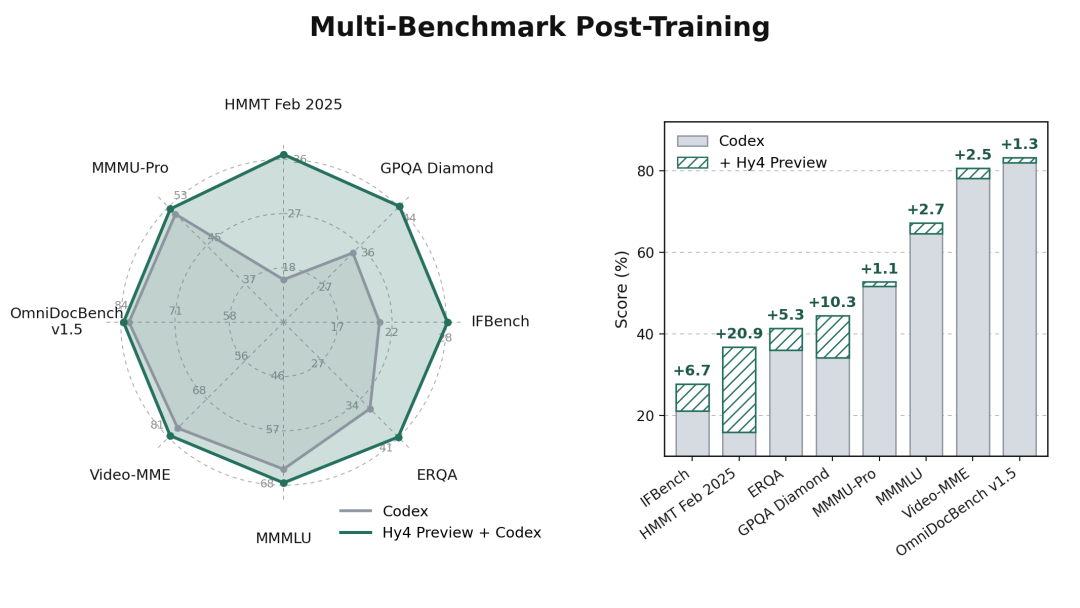
- 前沿科学评测:GPQA Diamond 达 92.3,SUPERChem 为 66.4,ArXivMath 为 66.6,MathArena Apex 2025 为 74.2,BioMysteryBench 为 71.3,HLE with tools 达 55.4。
- 早期版本说明:官方同时指出,Hy4 preview 仍处于迭代初期,在复杂任务中仍存在长思考过度自我验证、回答冗长等局限,后续正式版将继续优化预训练与对齐策略。
非线智能官网 https://nonelinear.com.cn/static/models.html 已上线 hy4-preview,,支持一键接入(附接入代码),添加客服 发送 体验金,可享20-50元首充奖励,欢迎对比体验。。
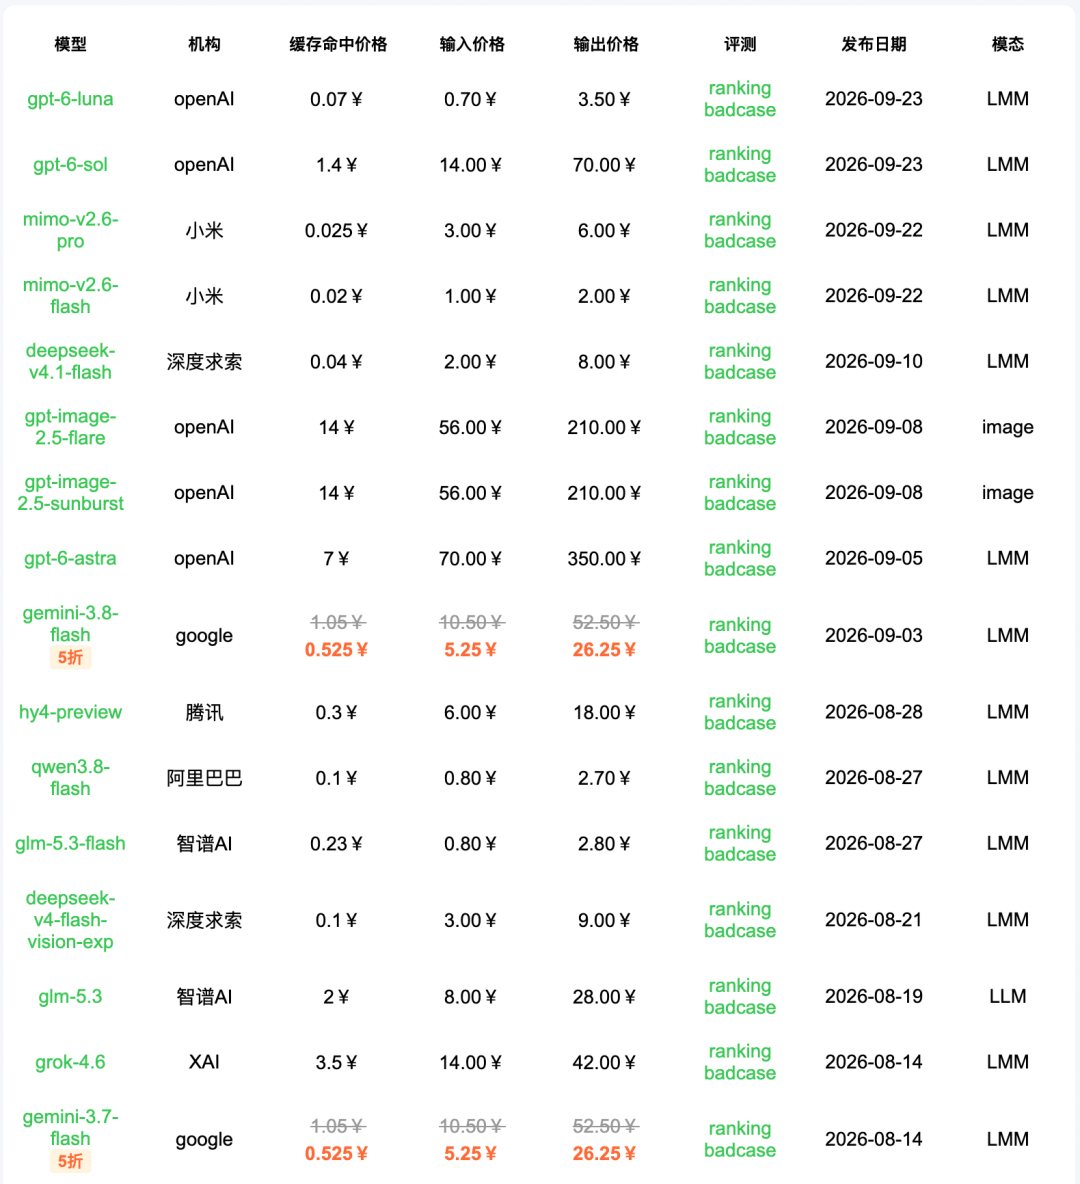
快速接入代码如下:
from openai import OpenAI


client = OpenAI(
    base_url="https://api.nonelinear.com.cn/v1",
    api_key="YOUR_API_KEY",
)


response = client.chat.completions.create(
    model="hy4-preview",
    messages=[
        {"role": "user", "content": "分析一个大型代码仓库的模块结构,并给出重构风险清单"}
    ],
)


print(response.choices[0].message.content)