 正文:
mimo-v2.6-pro版本表现:
- 测试题数:约1.5万
- 总分(准确率):69.6%
- 平均耗时(每次调用):95s
- 平均token(每次调用消耗的token):4126
- 平均花费(每千次调用的人民币花费):24元
1、新旧对决
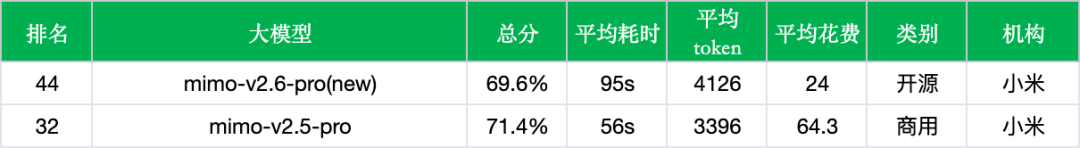
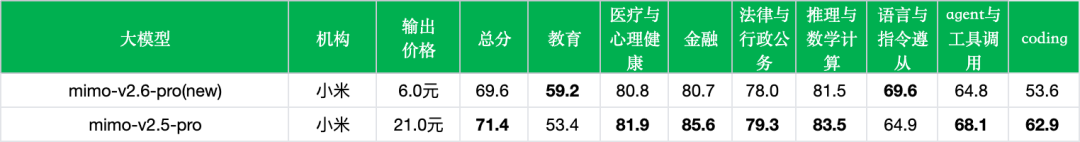
与上一代mimo-v2.5-pro相比,新版在本次中文综合评测中呈现出“成本大幅下降、响应时间变长、部分板块回调”的特征,具体数据如下:
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
*输出价格单位: 元/百万token
- 总分和名次:综合准确率从71.4%降至69.6%,小幅回调1.8个百分点;在当前榜单中的综合排名由第32位变为第44位。
- 两项有所提升:教育板块从53.4%提升至59.2%(+5.8个百分点),语言与指令遵从从64.9%提升至69.6%(+4.7个百分点),这两项也是八个板块中仅有的上升项。
- coding回调最大:代码能力(coding)从62.9%降至53.6%,回落9.3个百分点;金融从85.6%降至80.7%(-4.9个百分点),Agent与工具调用从68.1%微降至64.8%(-3.3个百分点)。
- 其他维度小幅下降:推理与数学计算从83.5%降至81.5%(-2.0个百分点),法律与行政公务从79.3%降至78.0%(-1.3个百分点),医疗与心理健康从81.9%降至80.8%(-1.1个百分点)。
- 耗时和token:平均耗时从56s延长至95s,增幅约70%;平均生成token从3396增至4126,增长约21.5%。这表明在大规模强化学习后,模型在解题时倾向于展开更完整的推导链条。
- 调用花费:输出价格由21.0元下调至6.0元/百万token,带动平均每千次调用花费从64.3元降至24元,降幅高达62.7%,大幅降低了实际调用门槛。
2、横向对比
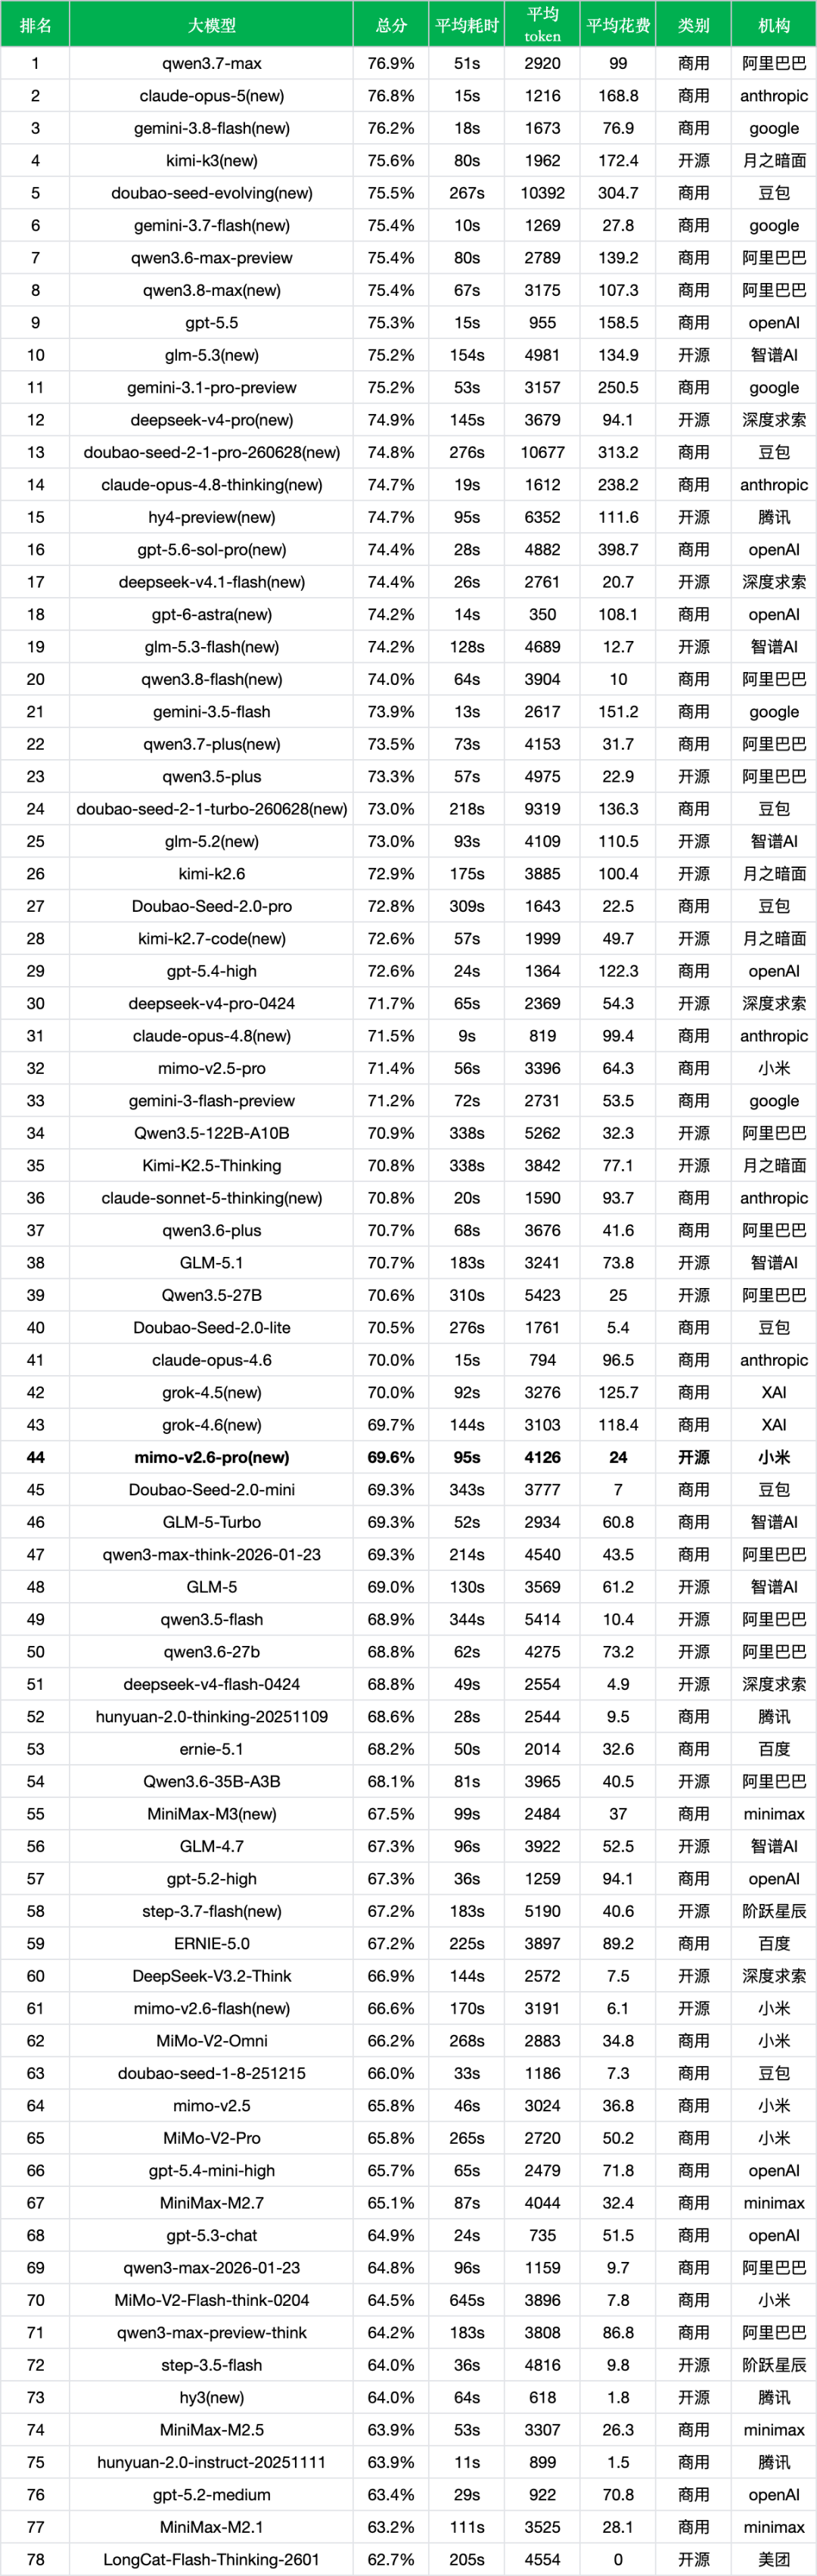
把mimo-v2.6-pro放入当前评测大盘,可以清晰观察其在中文准确率、响应延迟与成本上的定位:
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
同成本档位对比
- 在20至35元/千次调用的相近成本组中,mimo-v2.6-pro(69.6%,24元)的准确率低于deepseek-v4.1-flash(74.4%,20.7元)、qwen3.5-plus(73.3%,22.9元)与gemini-3.7-flash(75.4%,27.8元),略低于Qwen3.5-27B(70.6%,25元)。在中文场景的表现上,同成本档位竞品依然具备较强竞争力。
- 响应延迟差异同样显著:mimo-v2.6-pro平均耗时95s,明显长于deepseek-v4.1-flash(26s)、qwen3.5-plus(57s)及gemini-3.7-flash(10s)。若业务场景对即时交互延迟要求较高,需结合具体任务进行针对性测算。
新旧模型对比
- 对比上一代Pro:mimo-v2.5-pro为71.4%、64.3元,新版mimo-v2.6-pro为69.6%、24元。新版以较低的中文单轮准确率波动,换来了60%以上的成本下降,同时在模型开源属性上提供了更多自主可控的部署空间。
- 对比同代Flash:同系列的mimo-v2.6-flash为66.6%、6.1元/千次调用,但其实测平均耗时达到170s。Pro版本不仅准确率高出3.0个百分点,且实测耗时相对更短,在综合体验上更具平衡性。
开源/商用对比
- 在开源阵营横向对比中,mimo-v2.6-pro(69.6%,24元)落后于deepseek-v4.1-flash与qwen3.5-plus,但相比高花费的hy4-preview(74.7%,111.6元)具有明显的成本优势。开源权重为私有化部署和垂直微调提供了良好基础,实际选型需综合考虑部署成本与业务场景适配度。
3、官方评测
小米官方将MiMo-V2.6-Pro定位为原生全模态模型,重点展示了强化学习在Agent、长程软件工程及视觉任务中的显著突破。以下数据均来自小米官方发布页及基准图表:
软件工程与Agent基准
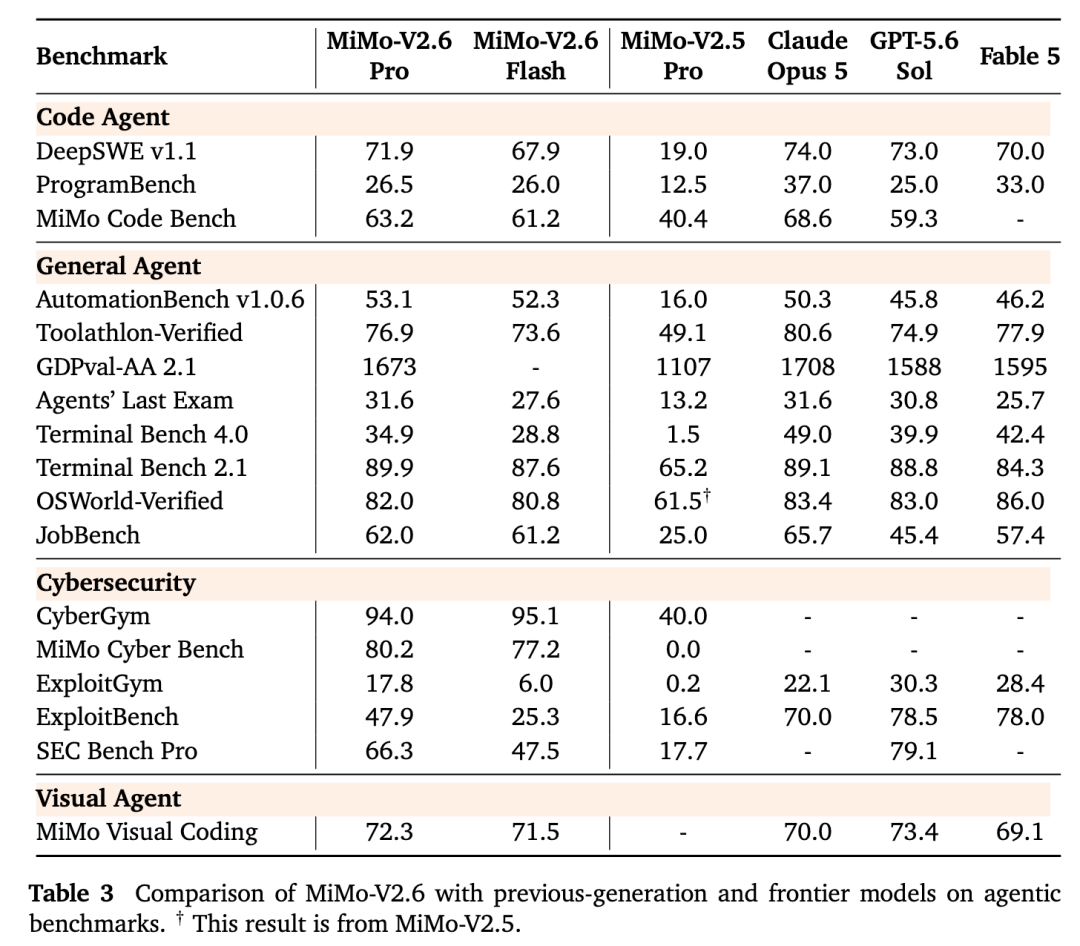
- 代码智能体:在官方基准中,MiMo-V2.6-Pro的DeepSWE v1.1达到71.9,ProgramBench为26.5,MiMo Code Bench为63.2,较上一代MiMo-V2.5-Pro(对应为19.0、12.5和40.4)取得跨越式提升;在DeepSWE v1.1上逼近Claude Opus 5(74.0)与GPT-5.6 Sol(73.0)。
- 通用智能体:Toolathlon-Verified得分76.9,Terminal Bench 2.1达89.9,Agents’ Last Exam为31.6,均大幅领先于旧版(49.1、65.2和13.2);在更具挑战性的Terminal Bench 4.0上得分为34.9,与顶尖闭源模型仍有一定差距。
- 安全与视觉任务:CyberGym达到94.0,MiMo Visual Coding为72.3,展现出针对特定攻防与视觉编程任务的专门优化;ExploitBench得分为47.9。
官方同时披露,MiMo-V2.6-Pro在Artificial Analysis Intelligence Index上取得约46分,体现了其在多维度推理体系下的综合竞争力。
强化学习过程与案例
小米公布的数据显示,Pro与Flash在不足6天的训练中各完成30步强化学习,累计覆盖约75万条轨迹,Pro训练任务的平均通过率相对提升约12%。在训练过程中,DeepSWE v1.1得分从58.4持续攀升至72.6,验证了强化学习在长链路代码修复任务上的有效性。
在落地案例方面,官方展示了MiMo-V2.6-Pro协助材料科研团队进行金属有机框架(MOF)材料的模拟与筛选,以及在专家引导下完成Lean 4形式化数学证明。在Lean 4任务中,模型生成并整合了6000余行源码且顺利通过内核核验,体现了其在严密逻辑推导与专业工具链交互中的深度应用潜力。
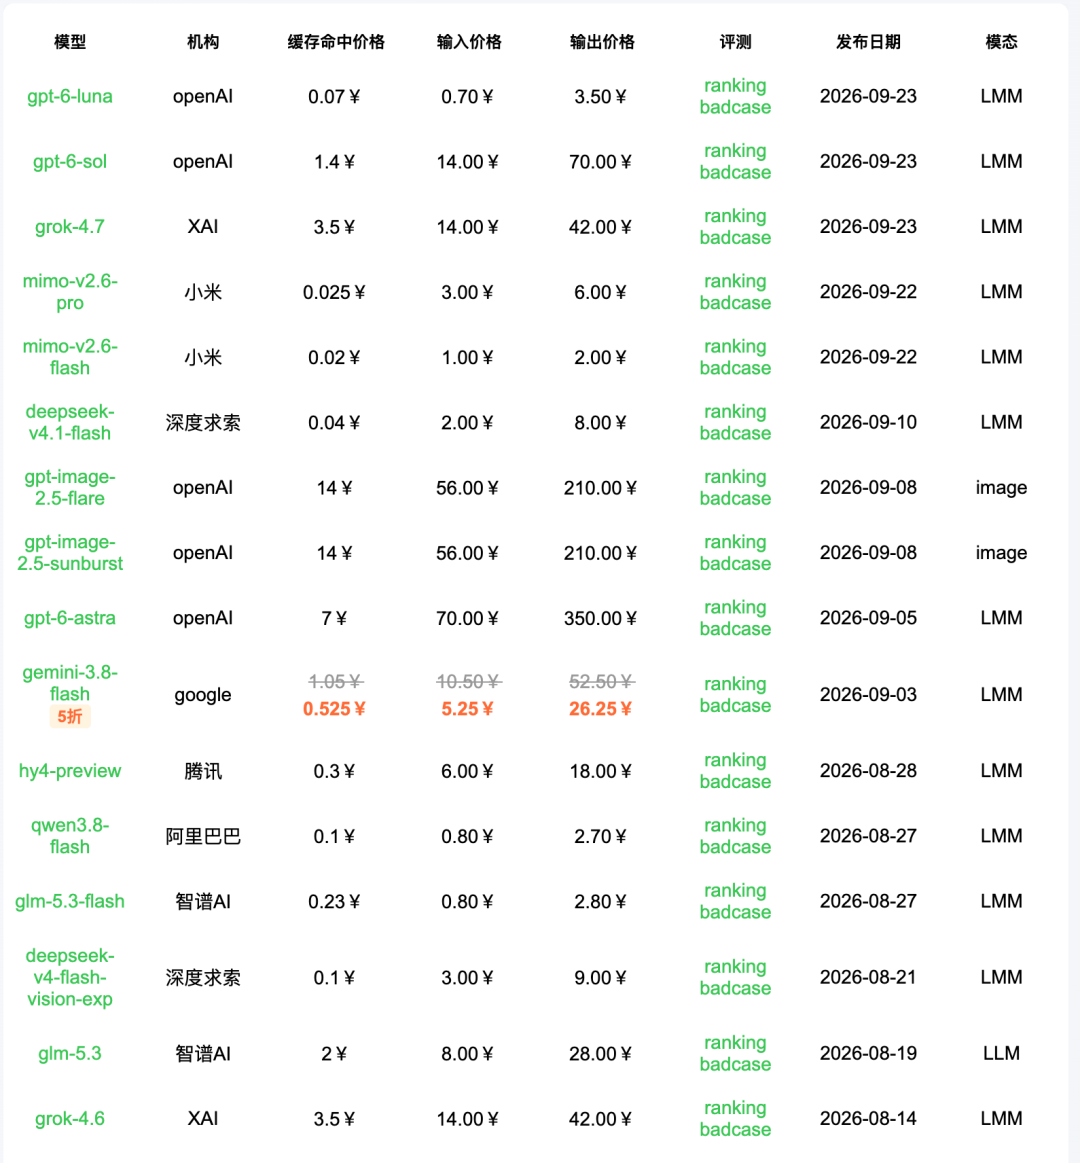
非线智能官网 https://nonelinear.com.cn/static/models.html 已上线mimo-v2.6-pro,支持一键接入(附接入代码),添加客服 发送 体验金,可享20-50元首充奖励,欢迎对比体验。
 快速接入代码如下:
from openai import OpenAI


client = OpenAI(
    base_url="https://api.nonelinear.com.cn/v1",
    api_key="YOUR_API_KEY",
)


response = client.chat.completions.create(
    model="mimo-v2.6-pro",
    messages=[
        {"role": "user", "content": "分析这个代码仓库的模块依赖,并列出优先修复的风险"}
    ],
)


print(response.choices[0].message.content)