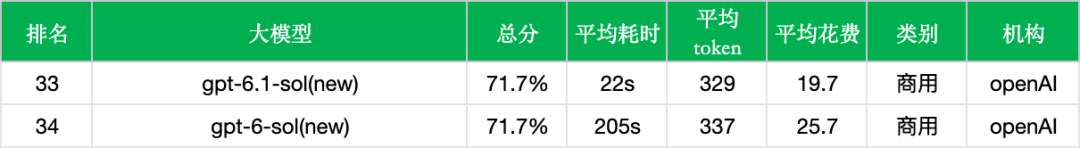
gpt-6.1-sol 版本表现:
- 总分(准确率):71.7%
- 平均耗时(每次调用):22s
- 平均token(每次调用消耗的token):329
- 平均花费(每千次调用的人民币花费):19.7元
1、新旧对决
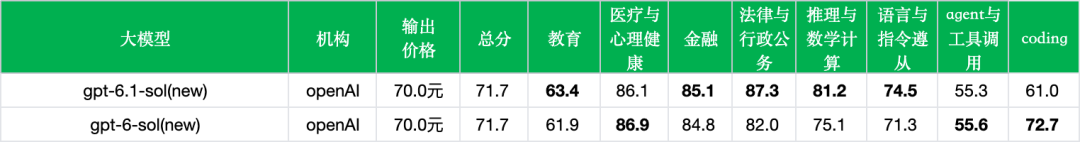
和上一代 GPT-6 Sol 相比,新版的综合准确率稳定在 71.7%,但响应速度和调用成本迎来了一轮大幅优化。拆开来看细分板块,模型则经历了一轮明显的“技能重配”:数理逻辑与法律大幅走强,而 Coding 能力出现了回落。
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
*输出价格单位: 元/百万token
- 总分基持平:两代模型的综合准确率双双定格在 71.7%,在总榜上紧挨着分列第 33 和第 34 位,整体实力处于同一基准线,差别主要体现在细项能力的重新分配。
- 推理数学与法律进步明显:推理与数学计算从 75.1% 冲上 81.2%(+6.1个百分点),法律与行政公务也从 82.0% 升至 87.3%(+5.3个百分点),是本次升级中幅度最大的两个亮点。
- 语言、教育与金融稳步上扬:语言与指令遵从由 71.3% 涨到 74.5%(+3.2个百分点),教育板块从 61.9% 提升至 63.4%(+1.5个百分点),金融领域微幅提升至 85.1%(+0.3个百分点),通用理解和文案处理更加扎实。
- Coding 板块出现明显滑坡:代码准确率由 72.7% 跌至 61.0%,降幅达 11.7 个百分点,是全部八大板块中波动大的一项;医疗健康(86.1%,-0.8个百分点)与 Agent 工具调用(55.3%,-0.3个百分点)则出现微幅波动。这也印证了一点:总分不变绝不等于能力分布不变,重心已有明显迁移。
- 响应耗时大幅削减:平均每次调用耗时从上一代的 205 秒大幅压缩至 22 秒,等待时间砍掉了将近九成(-89.3%)。这是本次实测体验升级最明显的一项,直接甩掉了前代动辄数分钟的超长思考包袱。
- token 略减,综合花费下降:平均单次消耗 token 从 337 微跌至 329(-2.4%);在标称输出价格同为 70元/百万token 的情况下,每千次调用的实际花费从 25.7 元降至 19.7 元,成本直接砍掉 23.3%,在上下文和推理调用上整体更经济。
2、横向对比
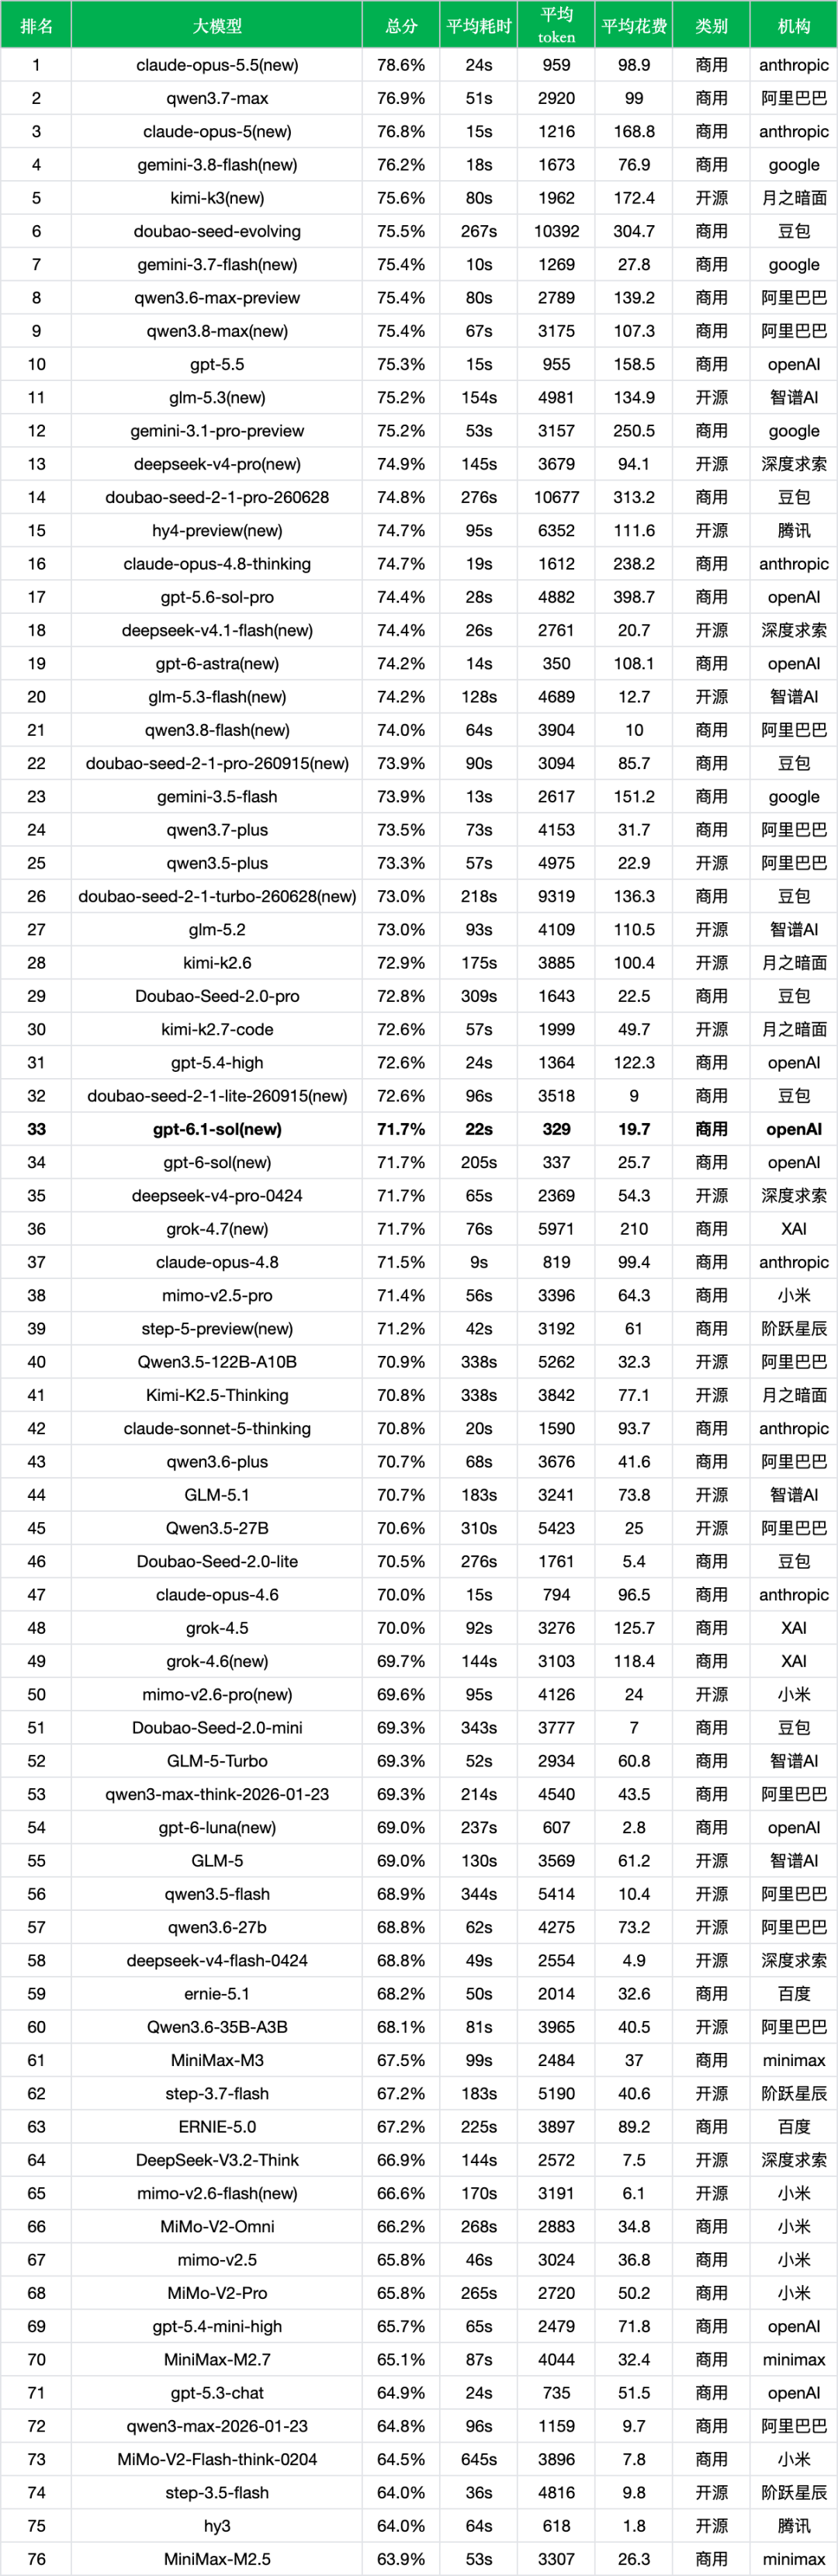
结合当前榜单,我们分别从同成本区间、同系列定位以及开源模型三个维度来观察其定位。
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
*输出价格单位: 元/百万token
同成本档位对比
- 在 15~30 元/千次调用的成本区间:gpt-6.1-sol(71.7%,19.7元)在成本上占有轻微优势,但在综合准确率上不及 deepseek-v4.1-flash(74.4%,20.7元)、qwen3.5-plus(73.3%,22.9元)以及 gemini-3.7-flash(75.4%,27.8元)。
- 耗时表现跃入主流梯队:gpt-6.1-sol 平均耗时 22 秒,与 deepseek-v4.1-flash(26秒)处于同一梯队,相比 qwen3.5-plus(57秒)更有优势,不过对比极致响应的 gemini-3.7-flash(10秒)仍有差距。但比起上一代的漫长等待,目前已完全具备即时交互体验。
- 同档位也存在明显弱势对手:面对 Qwen3.5-27B(70.6%,25元,310s)和 mimo-v2.6-pro(69.6%,24元,95s),gpt-6.1-sol 在总分、成本以及响应速度上全面占优。即使在同一预算区间内,各家模型的工程化体验仍拉开了显著代差。
OpenAI系列对比
- 与上一代 Sol 对比:新版本最大意义在于“提速降本”,让原本因为 200 秒以上高延迟而无法落地的业务有了重测价值;但在代码类场景下,则需要重点评估其 coding 能力下滑带来的影响。
- 对比低成本的 gpt-6-luna(69.0%,2.8元,237s):gpt-6.1-sol 准确率高出 2.7 个百分点且响应速度快了整整一个数量级,但千次成本大约是其 7 倍。预算极其敏感的离线批处理依然可以选 Luna,而追求交互和质量的场景新版 Sol 更实用。
- 对比高阶的 gpt-6-astra(74.2%,108.1元,14s)及 gpt-5.5(75.3%,158.5元,15s):新版 Sol 总分分别低了 2.5 和 3.6 个百分点,响应慢了几秒,但调用花费直接压缩至前者的五分之一到八分之一。是用高溢价换取顶尖精度,还是以低成本换取可用性,取决于具体的业务容忍度。
开源与商用模型对比
- 开源阵营的成本效率比:标为开源的 glm-5.3-flash(74.2%,12.7元,128s)综合准确率比 gpt-6.1-sol 高出 2.5 个百分点,千次花费还便宜 7 元,但代价是耗时长了近两分钟。
- 预算与耗时并非简单正比:编程专精的 kimi-k2.7-code(72.6%,49.7元,57s)在中文综合表现上高出 0.9 个百分点,但调用单价(近50元)和耗时均明显高出不少。虽然通用大榜不能完全代替专用代码工作流体验,但在泛化任务的成本效率比上,gpt-6.1-sol 显得更加轻便。
3、官方评测
OpenAI 官方发布页披露的核心基准里,着重强调了长程工程、系统操作以及推理效率等维度的提升:
软件工程与业务工作流
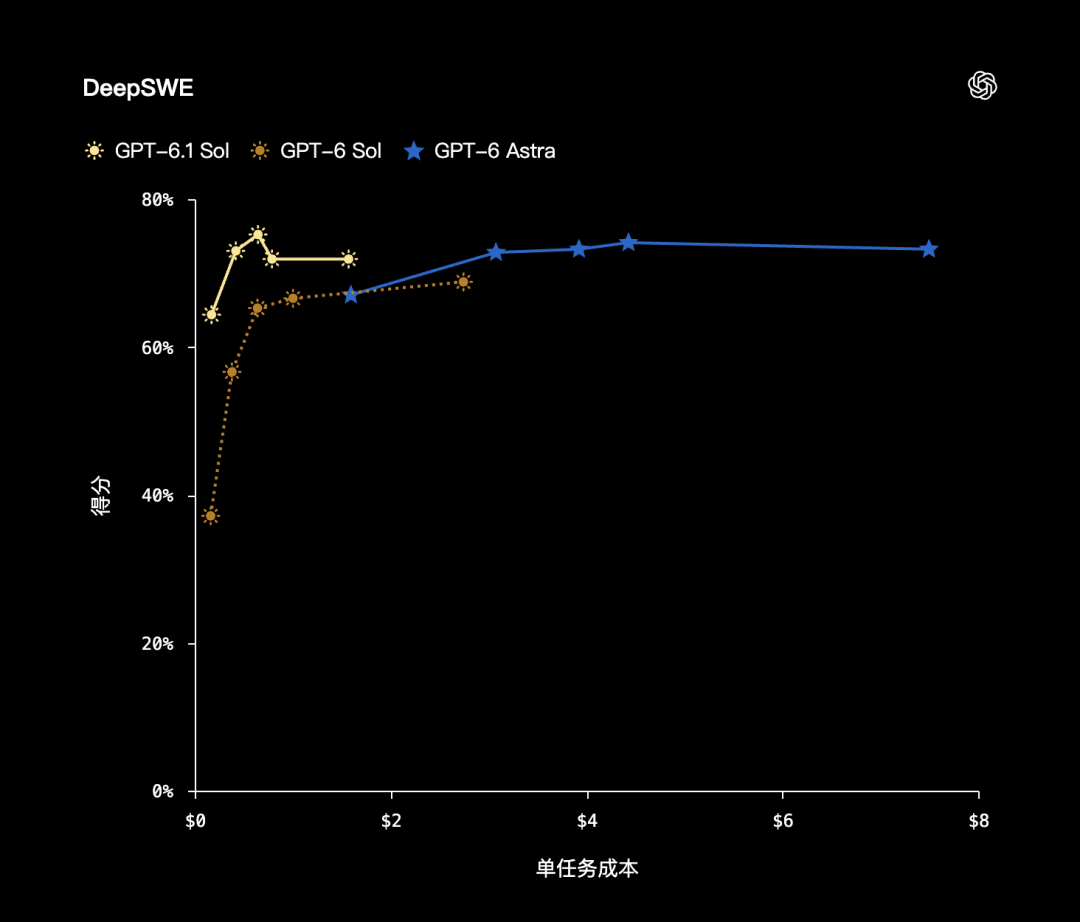
- DeepSWE v1.1(长程软件工程):官方数据显示,在较低推理强度设定下,GPT-6.1 Sol 的得分反而超越了上一代开启最高推理强度时 6.4 个百分点,展现出在真实仓库复杂工程任务中更高的思考产出比。
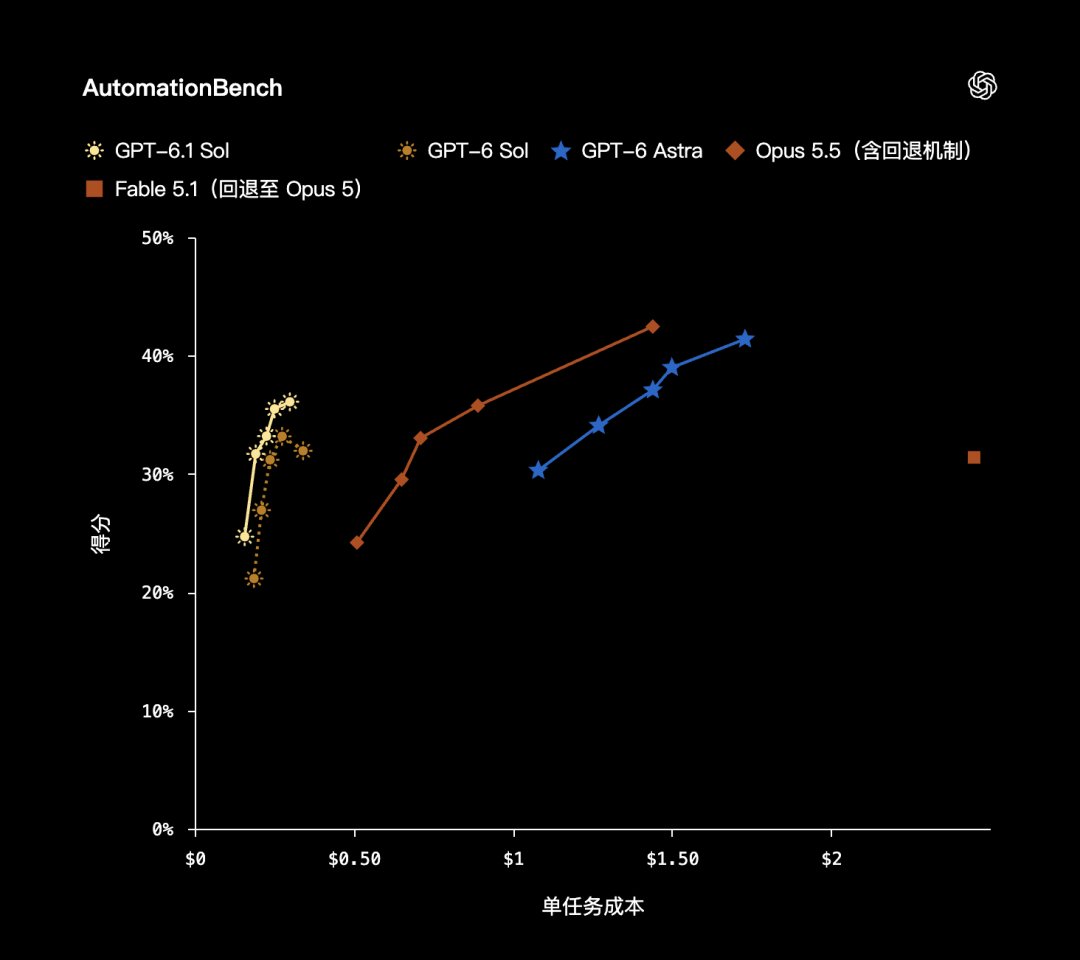
- AutomationBench 1.0.6(业务工作流自动化):在同等的 medium 推理强度设置下,新版比前代 GPT-6 Sol 提升了 4.8 个百分点。
计算机操作与科研
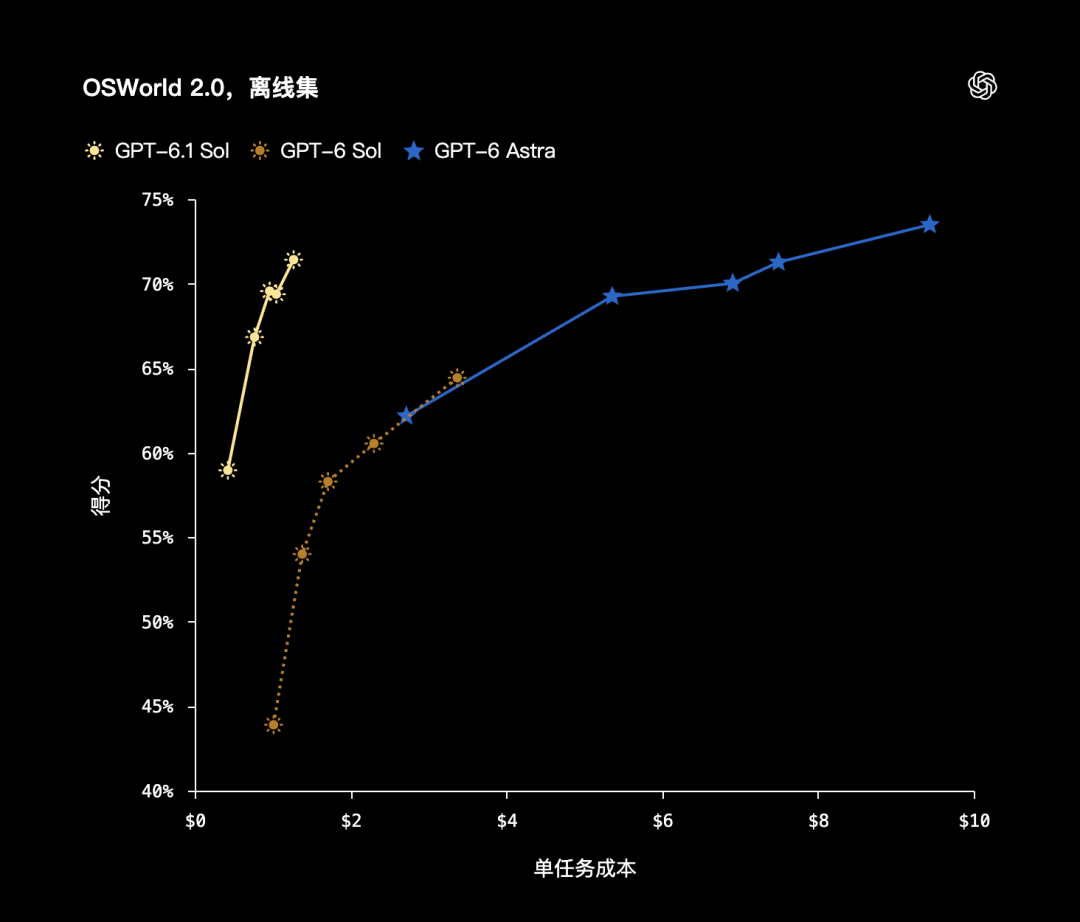
- OSWorld 2.0(计算机 GUI 操作):在最高推理强度下,新版比 GPT-6 Sol 提升了 7 个百分点(基于官方离线集的分步得分机制),智能体完成复杂桌面操作的达成度更佳。
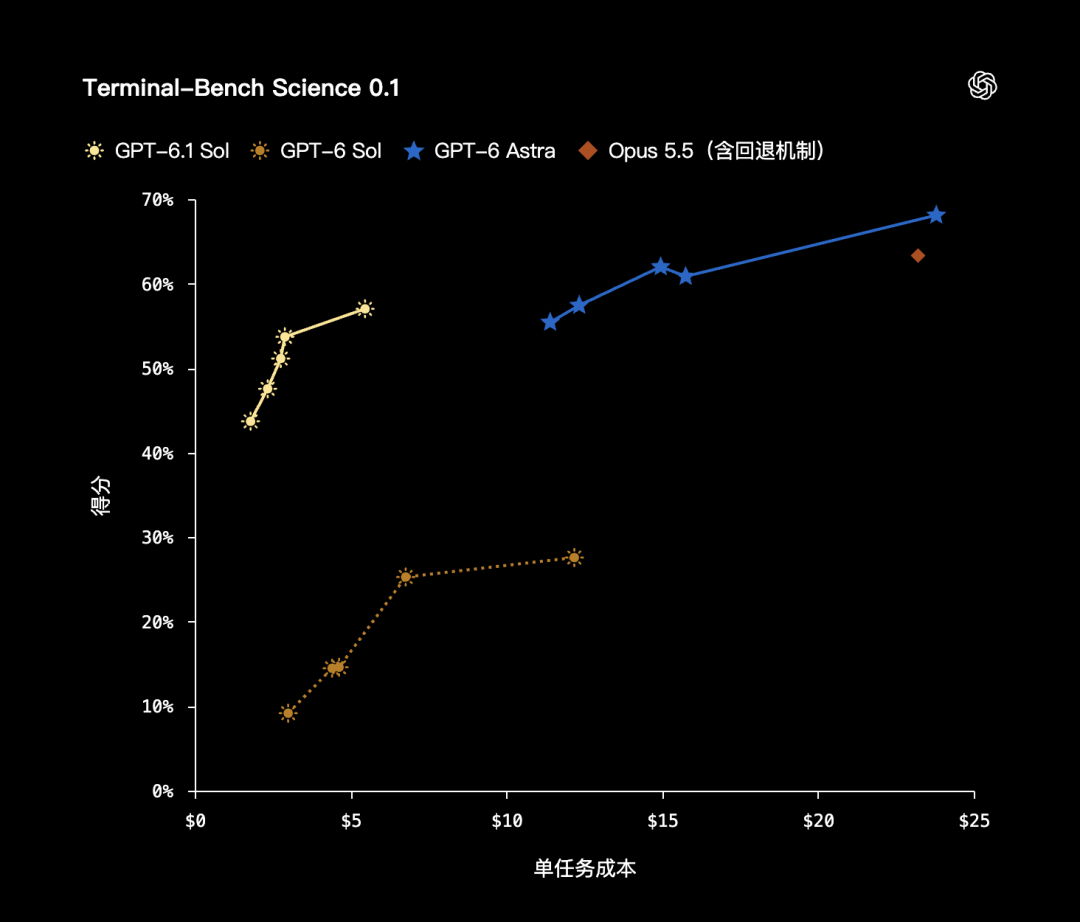
- Terminal-Bench Science 0.1(科研与命令行分析):在最高推理强度下,新版得分达到了上一代 GPT-6 Sol 的两倍以上,在数据模拟、分析与定理证明等硬核任务上进展明显。
事实准确性
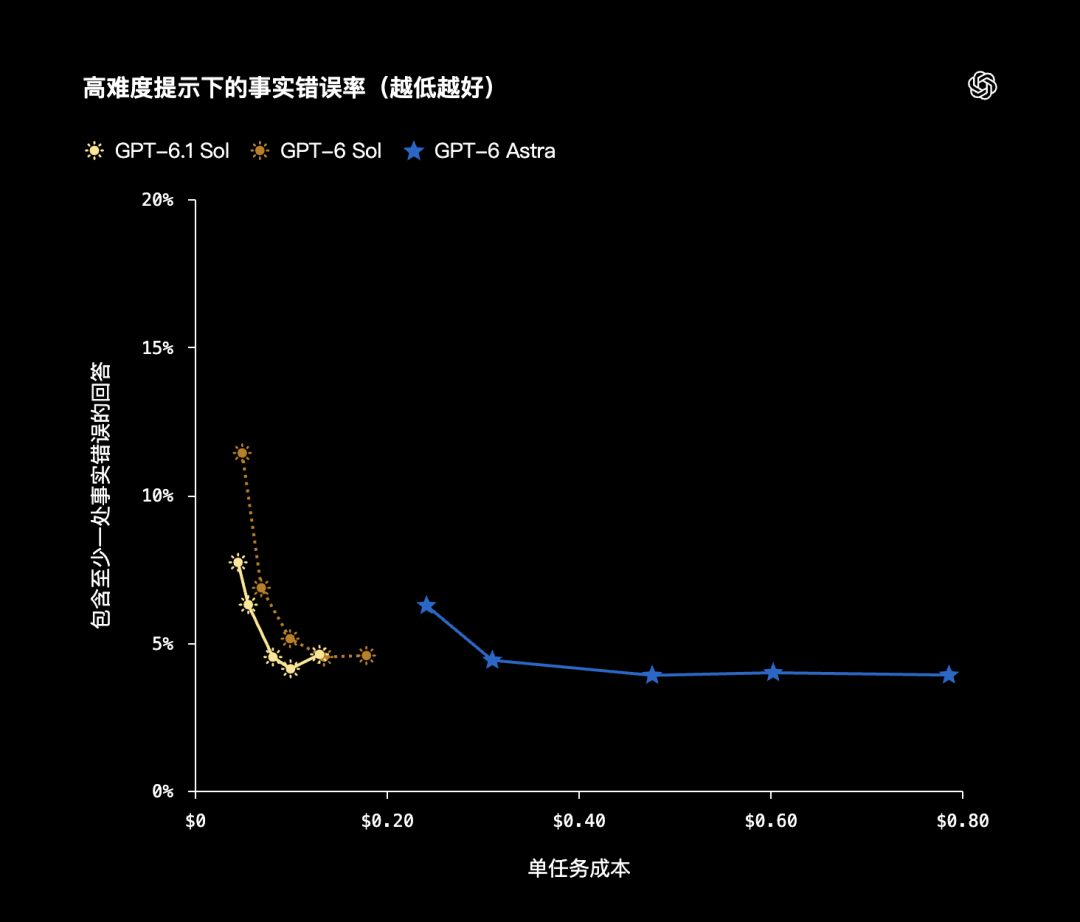
在 low 推理强度测试中,包含至少一处事实错误的回复比例由 11.4% 降至 7.7%,幻觉发生率相对降低了约 32%。这一测试集多来源于用户曾纠错的高难度对话样本,表明新版在严谨性和减少幻觉上确实下了一番功夫。
非线智能官网 https://nonelinear.com.cn/static/models.html 已上线 gpt-6.1-sol ,支持一键接入(附接入代码),添加客服 发送 体验金,可享20-50元首充奖励,欢迎对比体验。
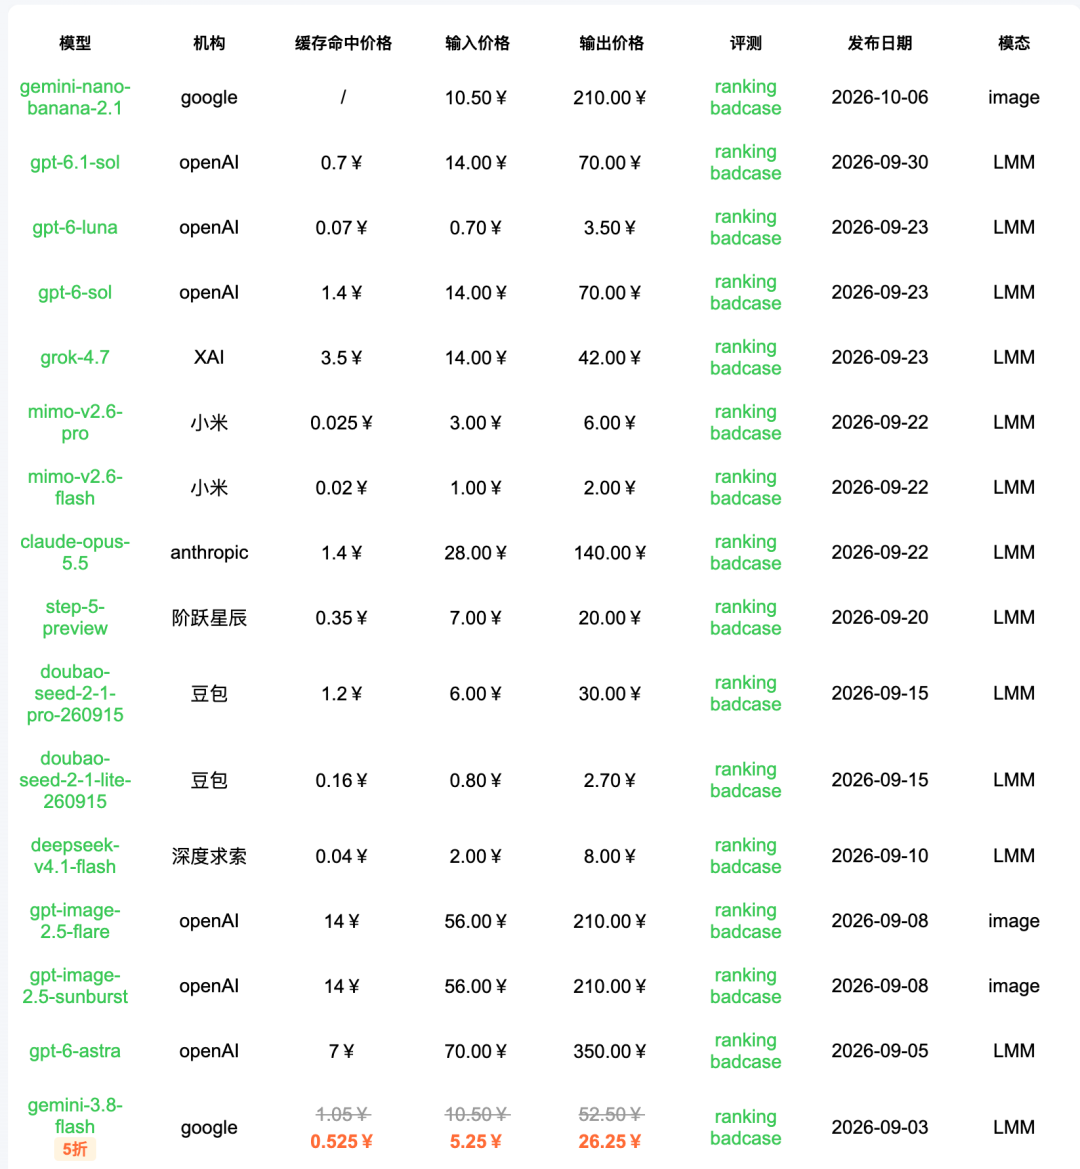
快速接入代码如下::
from openai import OpenAI


client = OpenAI(
    base_url="https://api.nonelinear.com.cn/v1",
    api_key="YOUR_API_KEY",
)


response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "user", "content": "阅读以下项目材料,梳理关键结论及需要补充的证据"}
    ],
)


print(response.choices[0].message.content)