 正文:
grok-4.7版本表现:
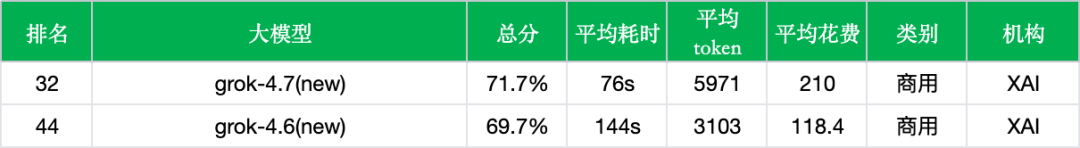
- 总分(准确率):71.7%
- 平均耗时(每次调用):76s
- 平均token(每次调用消耗的token):5971
- 平均花费(每千次调用的人民币花费):210元
1、新旧对决
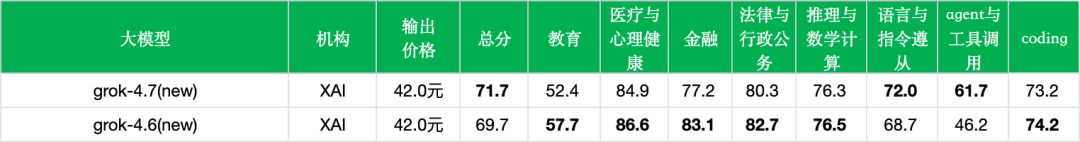
与grok-4.6相比,grok-4.7的中文综合准确率有所提升,但能力表现出现明显极化:增量几乎全集中在Agent与工具调用,部分传统知识类板块有所回调;同时模型生成耗时减半,但调用成本随之大幅上升。
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
*输出价格单位: 元/百万token
- 总分和名次:综合准确率由69.7%升至71.7%(+2.0个百分点),总榜排名从第44位升至第32位,整体跨过70%关口。
- 提升集中在两项:Agent与工具调用从46.2%飙升至61.7%(+15.5个百分点),是本次升级幅度最大的核心亮点;语言与指令遵从也从68.7%提升至72.0%(+3.3个百分点)。这反映出新版在智能体流程调度和复杂指令理解上的针对性强化。
- 回调也需要看到:在垂直知识与专业问答上出现不同程度的回落。其中金融从83.1%降至77.2%(-5.9个百分点),教育从57.7%降至52.4%(-5.3个百分点);法律与行政公务(-2.4个百分点)、医疗与心理健康(-1.7个百分点)、coding(-1.0个百分点)以及数学推理(-0.2个百分点)均有轻度下滑。
- 耗时与token:平均耗时从144s骤降至76s,响应速度提升近一倍(减少约47%);但平均单次Token消耗从3103增至5971(增加约92%),模型在给出最终答案前倾向于展开更长的推导与上下文信息。
- 调用花费:虽然输出价格维持在42元/百万token不变,但由于单次生成的Token量翻倍,千次调用平均花费由118.4元飙升至210元,调用成本实际增加了约77%。
2、横向对比
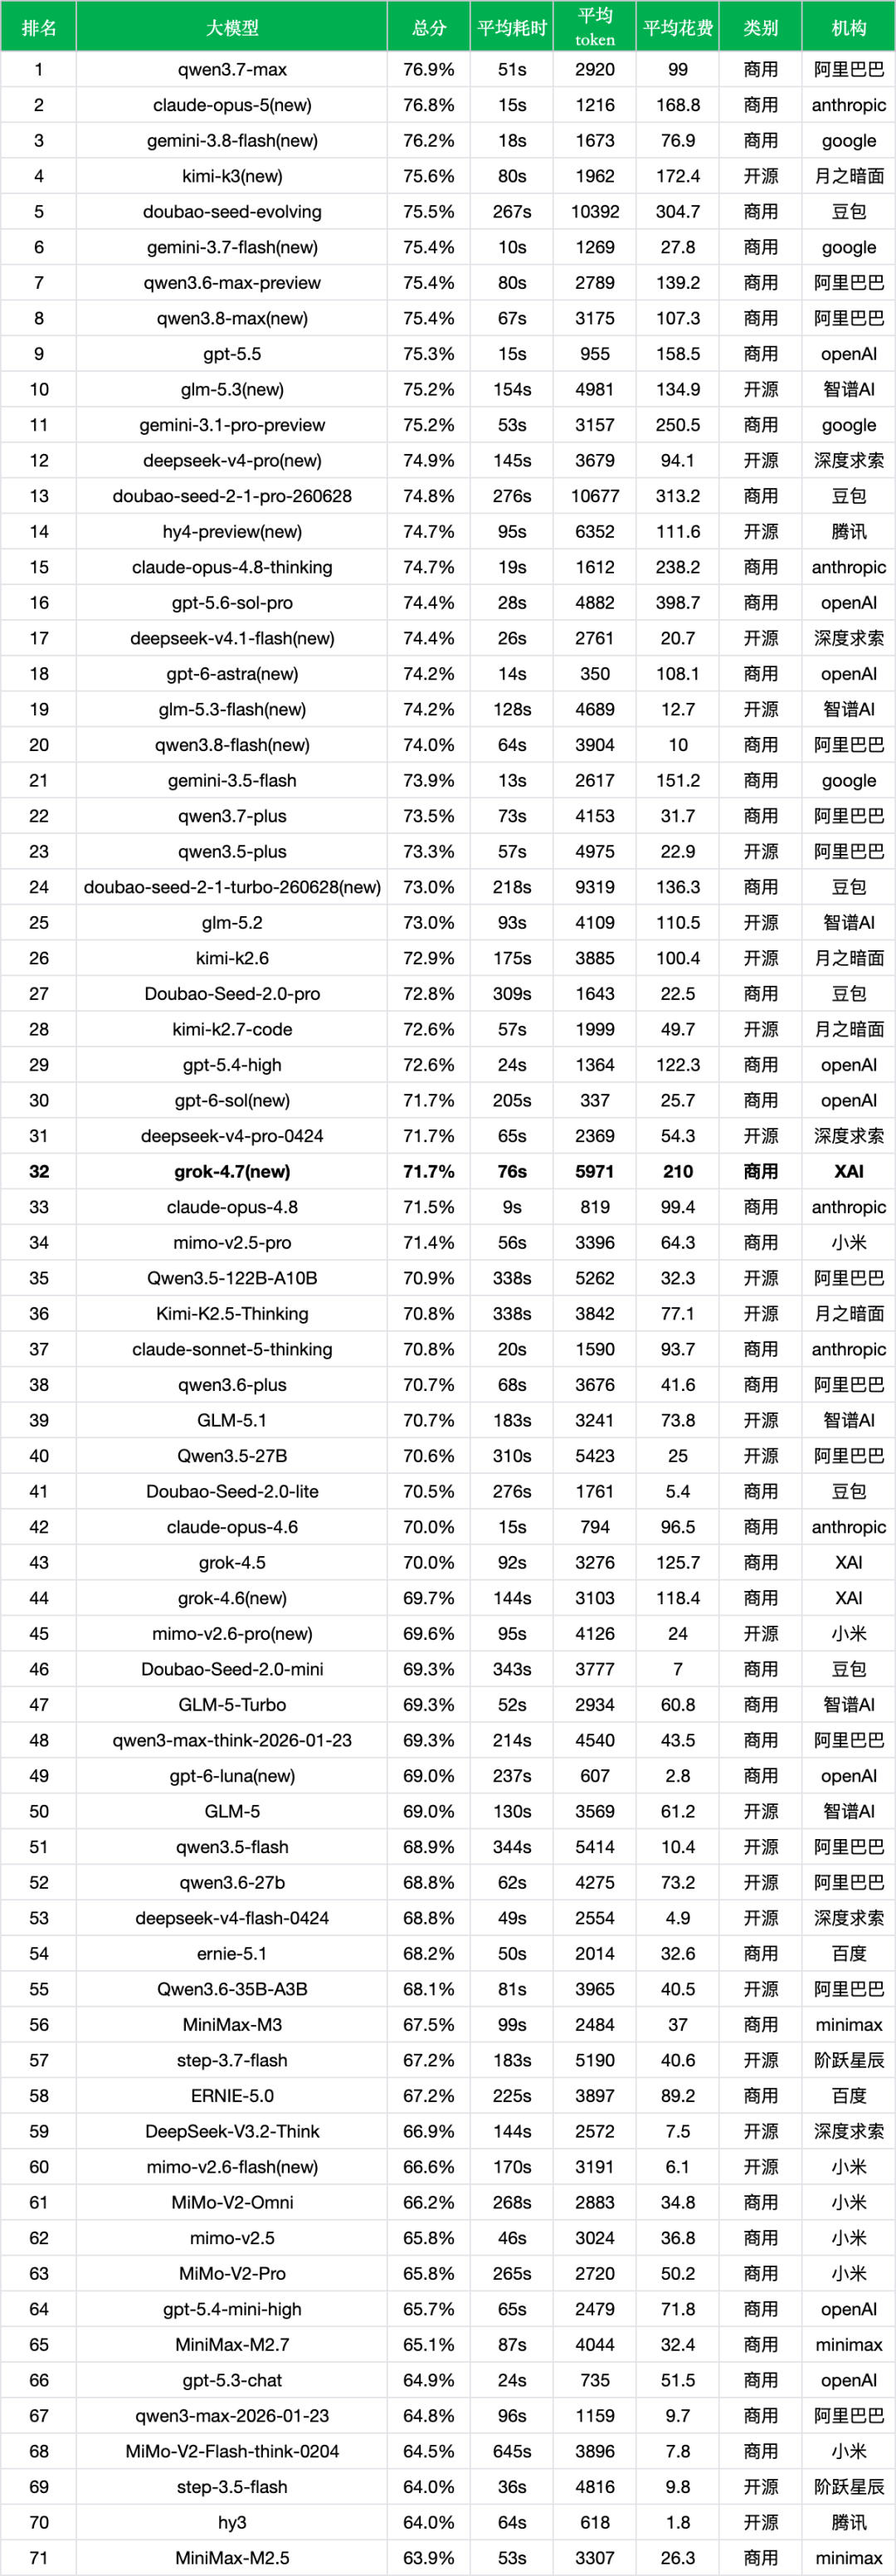
将grok-4.7放进当前总榜,从同成本区间、同系列定位以及开源模型三个维度观察其定位:
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark
同成本档位对比
- 在150至250元/千次调用的主力成本区间内,grok-4.7(71.7%,210元)在纯中文综合准确率上并不占优,低于claude-opus-5(76.8%,168.8元)、kimi-k3(75.6%,172.4元)以及claude-opus-4.8-thinking(74.7%,238.2元)。
- 平均耗时方面,grok-4.7的76s与kimi-k3(80s)基本相当,但显著慢于claude-opus-5(15s)和claude-opus-4.8-thinking(19s)。
新旧模型对比
- 从grok-4.5(70.0%,125.7元)、grok-4.6(69.7%,118.4元)到grok-4.7(71.7%,210元),4.7版本打破了前两代在70%附近的平台期,性能上限更高。
- 响应速度上,4.7以76s成为三代中最快的一款(4.5为92s,4.6为144s),但调用预算也是历代最高,选型时需权衡速度/Agent提升与成本增长。
开源与商用模型对比
- 开源阵营中的deepseek-v4-pro(74.9%,94.1元,145s)和hy4-preview(74.7%,111.6元,95s),在中文场景下的准确率均高于grok-4.7,且调用花费仅为其一半左右,不过生成延迟相对较长。
- deepseek-v4.1-flash(74.4%,20.7元,26s)更是实现了更高分数、低花费(仅20.7元)与快速响应(26s)的综合成本效率比优势。
3、官方评测
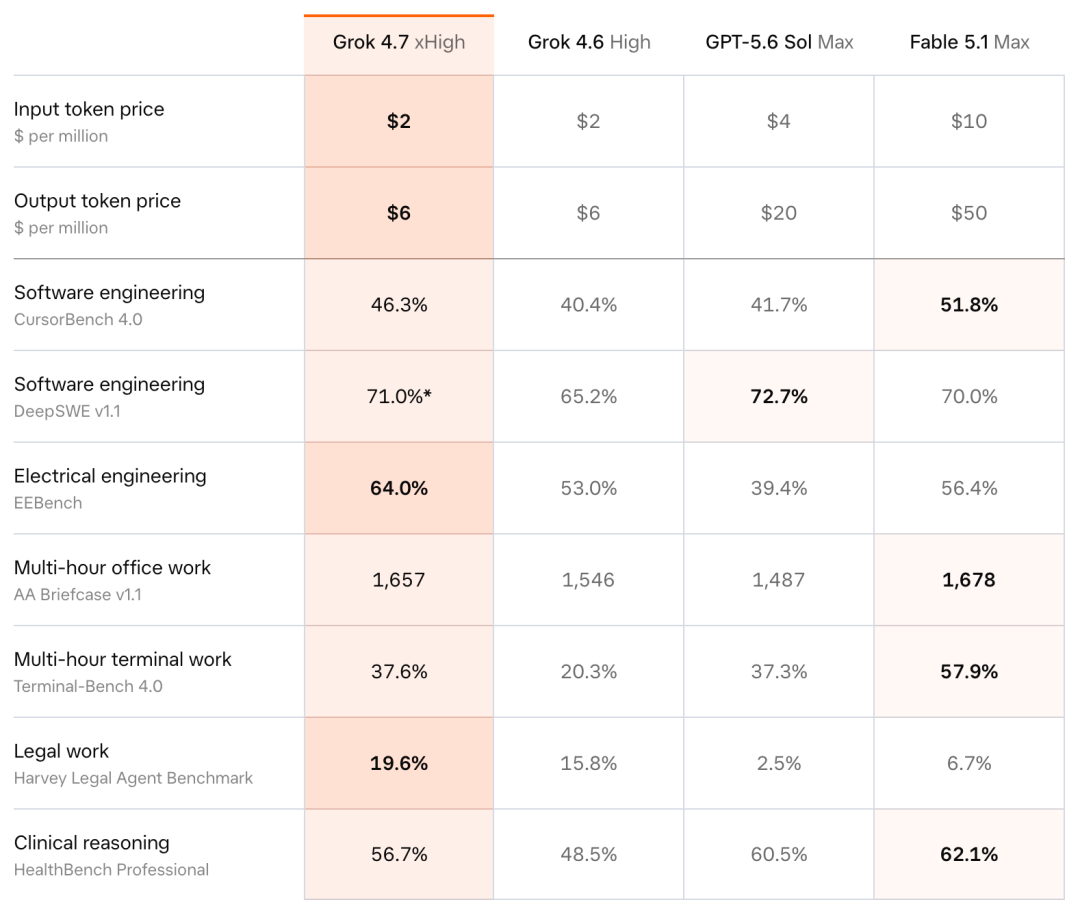
xAI官方公布的测试重点集中在软件工程实战、长程任务及专业安全领域,主要数据如下:
软件工程与长任务
- CursorBench 4.0:得分46.3%,体现了其在较长时间跨度代码开发中的上下文维持能力。
- DeepSWE v1.1(High Effort模式):斩获71.0%的高分,凸显其在自主软件工程修复上的强劲实力。
- Terminal-Bench 4.0:得分37.6%,展现了终端环境下的交互与操作能力。
专业知识工作
- EEBench电气工程基准:得分64.0%;AA Briefcase v1.1综合得分1657分。
- Harvey Legal Agent法律基准:得分19.6%;HealthBench Professional医疗基准:得分56.7%。
- 此外,官方还展示了复杂办公流GDPval等多项高难度专业任务测试。
安全基准
- LatchBio生物安全基准得分62.4%。
- HackerBench v0.3双用途安全攻防测试中,风险提示放行率仅为3.3%,展现出更加严格的安全对齐与风险拦截策略。
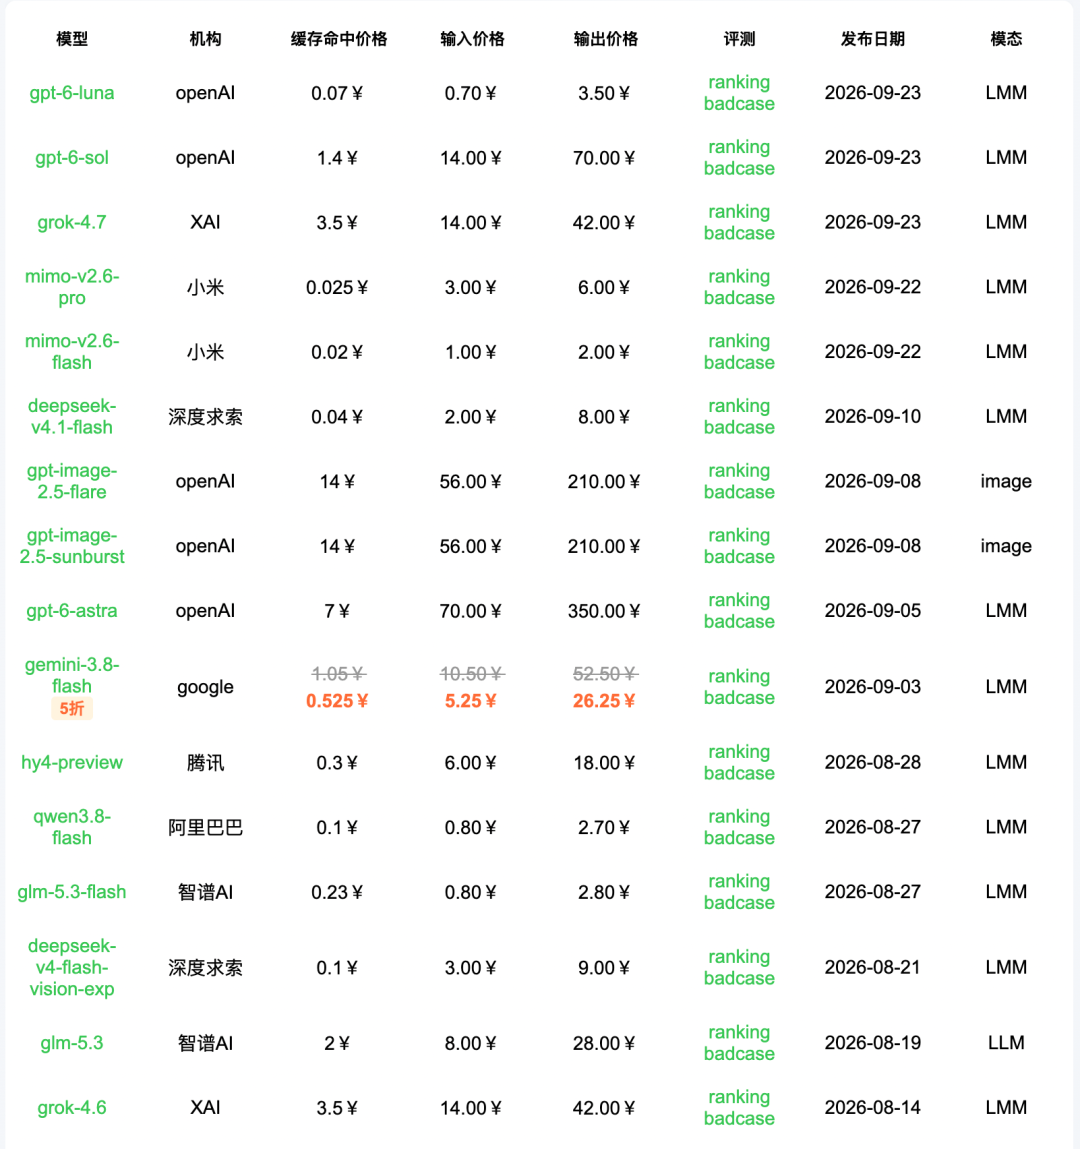
非线智能官网 https://nonelinear.com.cn/static/models.html 已上线 grok-4.7 ,支持一键接入(附接入代码),添加客服 发送 体验金,可享20-50元首充奖励,欢迎对比体验。
快速接入代码如下:
from openai import OpenAI


client = OpenAI(
    base_url="https://api.nonelinear.com.cn/v1",
    api_key="YOUR_API_KEY",
)


response = client.chat.completions.create(
    model="grok-4.7",
    messages=[
        {"role": "user", "content": "分析这份项目材料,梳理关键风险和下一步行动"}
    ],
)


print(response.choices[0].message.content)