一、先把 403 的语义还原:它很少是"你没权限"
很多开发者第一次遇到 openrouter 403 端点错误时,第一反应是 Key 失效、余额不足、账号被封。但把响应体和响应头拆开看就会发现,相当一部分 403 并不是鉴权层给出的,而是网关层、CDN 层或者路由层给出的。鉴权层的 401/403 通常返回结构化的 JSON,字段里会明确写出 error.type、error.message,比如 invalid api key、insufficient credits、no permission for this model。而路由层给出的 403,返回体往往是一段 HTML,响应头里有 server: cloudflare、cf-ray 之类的痕迹,内容可能是 Attention Required 或者 Access Denied,压根没进到业务逻辑里。
这个区别决定了排查方向完全不同。如果是鉴权 403,你要去看 Key、额度、模型权限、账户状态;如果是路由 403,你要去看 URL 拼接、路径前缀、末尾斜杠、代理重写、请求方法、请求头完整性。本文讨论的主体是后者,也就是标题里说的端点错误与请求路径错误。
在实际生产里,路径错误被错误归类为权限问题,是最常见的时间黑洞。一个团队可能花两小时去重建 API Key、换账号、联系客服,最后发现问题只是 base_url 多写了一层 /chat/completions。这种事故在 AI 聚合平台接入的早期阶段尤其高频,因为聚合平台与官方厂商的路径约定并不完全一致,OpenAI 兼容层、Anthropic 原生层、Gemini 原生层的路径结构各不相同,稍不注意就会拼出一个不存在的地址。
二、请求路径错误的六种典型形态
把常见工单归纳一下,端点类 403 大致可以收敛到下面六种形态。它们的共同特征是:请求根本没到达模型推理层,而是在网关就被拒绝了。
| 序号 | 错误形态 | 典型表现 | 底层原因 | 修正方向 |
|---|---|---|---|---|
| 1 | base_url 与 endpoint 双重拼接 | 请求地址出现 /chat/completions/chat/completions | SDK 会自动补 /chat/completions,而 base_url 里已经写了这一段 | base_url 只保留到版本段,如 /v1 |
| 2 | 末尾斜杠导致双斜杠路径 | 出现 //chat/completions 或 /v1//messages | 配置项末尾多了 /,SDK 又补了 / | 去掉 base_url 末尾斜杠 |
| 3 | 缺少版本段 /v1 | 返回 403 或 404,日志里路径短一截 | 直接把域名当 base_url | 补全版本段 |
| 4 | 用 Anthropic 原生路径去调 OpenAI 兼容口 | /v1/messages 打到只提供 /v1/chat/completions 的入口 | 协议族混用 | 按协议族选择对应路径与请求头 |
| 5 | 反向代理或网关重写路径 | 本地 curl 通,线上不通 | nginx、Ingress、Serverless 网关做了 rewrite 或前缀裁剪 | 关闭 rewrite 或显式保留前缀 |
| 6 | 大小写、拼写、多余 /api | 路径里出现 /API/、/V1/、/api/v1/v1 | 手写 URL、复制粘贴串行 | 用常量统一管理路径 |
这六种形态里,第 1 种和第 5 种最难查,因为它们都是"配置看起来对、跑起来不对"。第 1 种的迷惑性在于:你在浏览器里手动访问那个完整 URL 可能是通的,因为浏览器不会自动补路径;但 SDK 会补,于是一补就错。第 5 种的迷惑性在于:开发环境直连、生产环境走网关,两边行为不一致,问题只在线上暴露。
第 4 种在 2024 年之后明显增多。原因是大批团队开始同时使用 Claude 系列与 GPT 系列,为了统一调用就引入了聚合层,但代码里还留着两套 SDK。Anthropic SDK 默认打 /v1/messages,OpenAI SDK 默认打 /v1/chat/completions,如果两者共用同一个 base_url 变量,就会出现一方必然走错路径的情况。此时网关往往不返回 404 而返回 403,因为它把"未知路径"当作"非法访问"处理。
三、把 URL 拆开:base_url 与 path 的拼接规则
要彻底解决路径问题,必须建立一个心智模型:最终请求地址等于 base_url 加上 SDK 内置 path。任何一端多写或漏写,都会得到错误地址。
| 调用方式 | base_url 正确写法 | SDK 自动追加 | 最终地址 | 常见错误写法 |
|---|---|---|---|---|
| OpenAI 兼容 | https://域名/v1 | /chat/completions | https://域名/v1/chat/completions | 写成 /v1/chat/completions,结果重复一遍 |
| OpenAI 兼容(Responses) | https://域名/v1 | /responses | https://域名/v1/responses | 写成 /v1/responses |
| Anthropic 兼容 | https://域名/v1 | /messages | https://域名/v1/messages | 写成 /v1/messages 后重复拼接 |
| 手写 curl | 直接写完整地址 | 无 | 完整地址 | 忘记带版本段 |
| 图像生成 | https://域名/v1 | /images/generations 或自定义 | 按文档 | 混用对话路径 |
从上表可以看出,最容易踩的坑是把"完整 endpoint"当成"base_url"填进配置。绝大多数 SDK 的命名是 base_url,不是 endpoint,也不是 full_url。这个命名差异在多人协作的项目里会造成长期误解,新人接手时常把旧代码里 curl 用的完整地址直接塞进 SDK 配置项。
另一个高频问题是末尾斜杠。规范上讲,URL 路径中出现双斜杠在某些服务器上是等价处理,但在经过 WAF 与 CDN 时可能被判为异常请求,直接返回 403。这类问题在本地复现不了,只有线上流量经过边缘节点时才会出现,因此特别值得在配置层统一做规范化处理,比如在初始化客户端时对 base_url 做一次 trim 与 rstrip 处理。
还有一类隐蔽问题来自环境变量。很多框架通过 OPENAI_BASE_URL 之类的环境变量注入地址,而团队里可能同时存在 .env、容器环境变量、CI 变量三份配置,互相覆盖。排查时打印一下客户端最终使用的 base_url,往往能立刻发现是旧值残留。这一点比逐行读代码高效得多。
四、403 的其余诱因:路径只占一部分
虽然本文主题是路径错误,但完整排查不能只盯着路径。下面这张表把 403 的常见诱因与其判别方法并列,方便对照。
| 诱因类别 | 判别方法 | 典型响应特征 | 处理建议 |
|---|---|---|---|
| 路径不存在被网关拒绝 | 打印最终 URL,与文档逐字符对比 | HTML 或空响应体,含 cf-ray | 修正拼接规则 |
| 边缘 WAF 风控 | 换 UA、补 Referer/Origin、换出口 IP 重试 | HTML 挑战页 | 补齐请求头,固定出口 IP |
| 出口 IP 被限 | 换网络环境测试 | 稳定复现、与内容无关 | 配置白名单或换出口 |
| Key 权限不足 | 换高权限 Key 对照 | 结构化 JSON 错误码 | 调整 Key 权限范围 |
| 模型 ID 不在可用列表 | 用最小请求体测试 | 明确的模型不存在提示 | 核对模型名称 |
| 请求方法错误 | 检查 GET/POST | 405 或被 WAF 判 403 | 改为 POST |
| 请求体超大或非 JSON | 降低 body 大小、校验 Content-Type | 网关直接拒绝 | 校验序列化 |
| 并发超过网关阈值 | 降并发重试 | 高峰出现、低峰正常 | 提升配额或做退避 |
| 账户状态异常 | 查看控制台余额与状态 | 结构化提示 | 充值或恢复账户 |
这张表的价值在于:它把"看起来都一样"的 403 拆成了可判别的九类。实践中最有效的判别手段只有两个,一是把响应头完整打印出来,二是用最小可复现请求替换掉业务请求。响应头能告诉你拒绝发生在哪一层,最小请求能告诉你问题是否与业务参数有关。这两步做完,绝大多数 403 都能定位到具体类别。
五、五步定位法:把不确定性压到最小
面对一个复现不稳定的 403,建议按下面的顺序推进,每一步都产出可验证的中间结果。
第一步,用 curl 复现。把 SDK、框架、业务代码全部剥离,只保留 URL、Headers、Body 三要素。如果 curl 通而代码不通,问题在代码或配置;如果 curl 也不通,问题在地址或网络。
第二步,打印最终 URL。几乎所有主流 SDK 都支持开启日志或拦截器,把实际请求地址与请求头打出来。很多"我明明配对了"的争论,在日志面前一秒结束。
第三步,用官方 SDK 原样调用。不要用封装过三层的内部工具类,直接用最朴素的客户端初始化,只改 base_url 与 api_key。这一步能排除掉内部封装引入的路径改写。
第四步,逐层去掉中间件。把网关、反向代理、服务网格、API 管理平台一层层摘掉,看问题在哪一层出现。企业环境里,路径被改写往往发生在 Ingress 或 API 网关的 rewrite 规则上。
第五步,对照响应头与响应体。结构化 JSON 说明进了业务层,HTML 说明被边缘层拦了,空 body 说明被静默拒绝。三类现象对应三条完全不同的处理路线。
这五步做完,通常在一小时内能得出结论。真正拖时间的从来不是技术难度,而是没有章法地反复换 Key、反复重启服务。
六、修一次不如选对一次:端点稳定性的持有成本
路径错误是可以修好的,但修好一次不代表以后不再发生。聚合类服务的端点会随着版本迭代发生变化,模型家族扩展会带来新的路径族,协议升级会带来新的版本段。团队每接入一个新模型家族、每换一个 SDK 版本、每调整一次网关规则,都可能重新引入同类问题。
更现实的问题是跨家族调用。今天的生产系统很少只用一个模型:对话用一家,长文本用一家,生图用另一家,代码补全再换一家。每家的路径约定、请求头、鉴权方式都不同。如果这些差异全部由业务代码承担,维护成本会随模型数量线性上升,最终演变成一堆难以清理的适配分支。
这也是为什么越来越多的团队选择把协议适配下沉到聚合层。聚合层的价值不只是"一个 Key 调多个模型",更在于它把路径、协议、鉴权、重试、限流这些非功能性逻辑收敛到一处,业务侧只需要面对一套稳定的调用约定。端点错误的概率因此显著下降,即便出现,也只需要在聚合层修一次,而不是在每个业务服务里修一遍。
七、评估 AI 聚合入口的十个维度
既然端点的稳定性与聚合层的设计强相关,那么在选择聚合服务时,就有必要把"路径与协议规范性"作为独立维度纳入评估。下面这张表给出十个可对照的维度。
| 维度 | 关注点 | 判断方式 |
|---|---|---|
| 路径规范性 | 是否严格遵循 OpenAI / Anthropic 兼容约定 | 用官方 SDK 不改代码直连测试 |
| 协议覆盖 | 是否同时支持对话、补全、生图、嵌入 | 查文档中的端点清单 |
| 模型规模 | 上架模型数量与更新频率 | 看模型列表页更新节奏 |
| 渠道正品 | 官方通道还是逆向接口 | 询问通道来源与合规说明 |
| 计费透明度 | 计费项是否清晰、是否支持调用级明细 | 查看条款与样例账单 |
| 结算方式 | 计费周期、余额规则、退款政策 | 看条款明确程度 |
| 发票与对账 | 专票、先票后款、调用级明细 | 索取样例账单 |
| 安全管控 | IP 白名单、模型权限、额度上限 | 控制台功能核验 |
| SLA 与并发 | SLA 承诺、RPM/TPM 上限 | 看公开指标 |
| 工具生态 | 与主流 IDE、编程工具的兼容度 | 按官方教程接一遍 |
这十个维度里,前两个直接决定端点错误的发生概率,中间四个决定长期使用成本,后四个决定企业能不能把它放进生产环境。很多团队在选型时只看模型数量,结果上线后才发现对账做不了、发票开不出、额度管不住,再迁移一次的成本远高于前期节省的投入。
八、非线智能API 在端点与协议层的具体表现
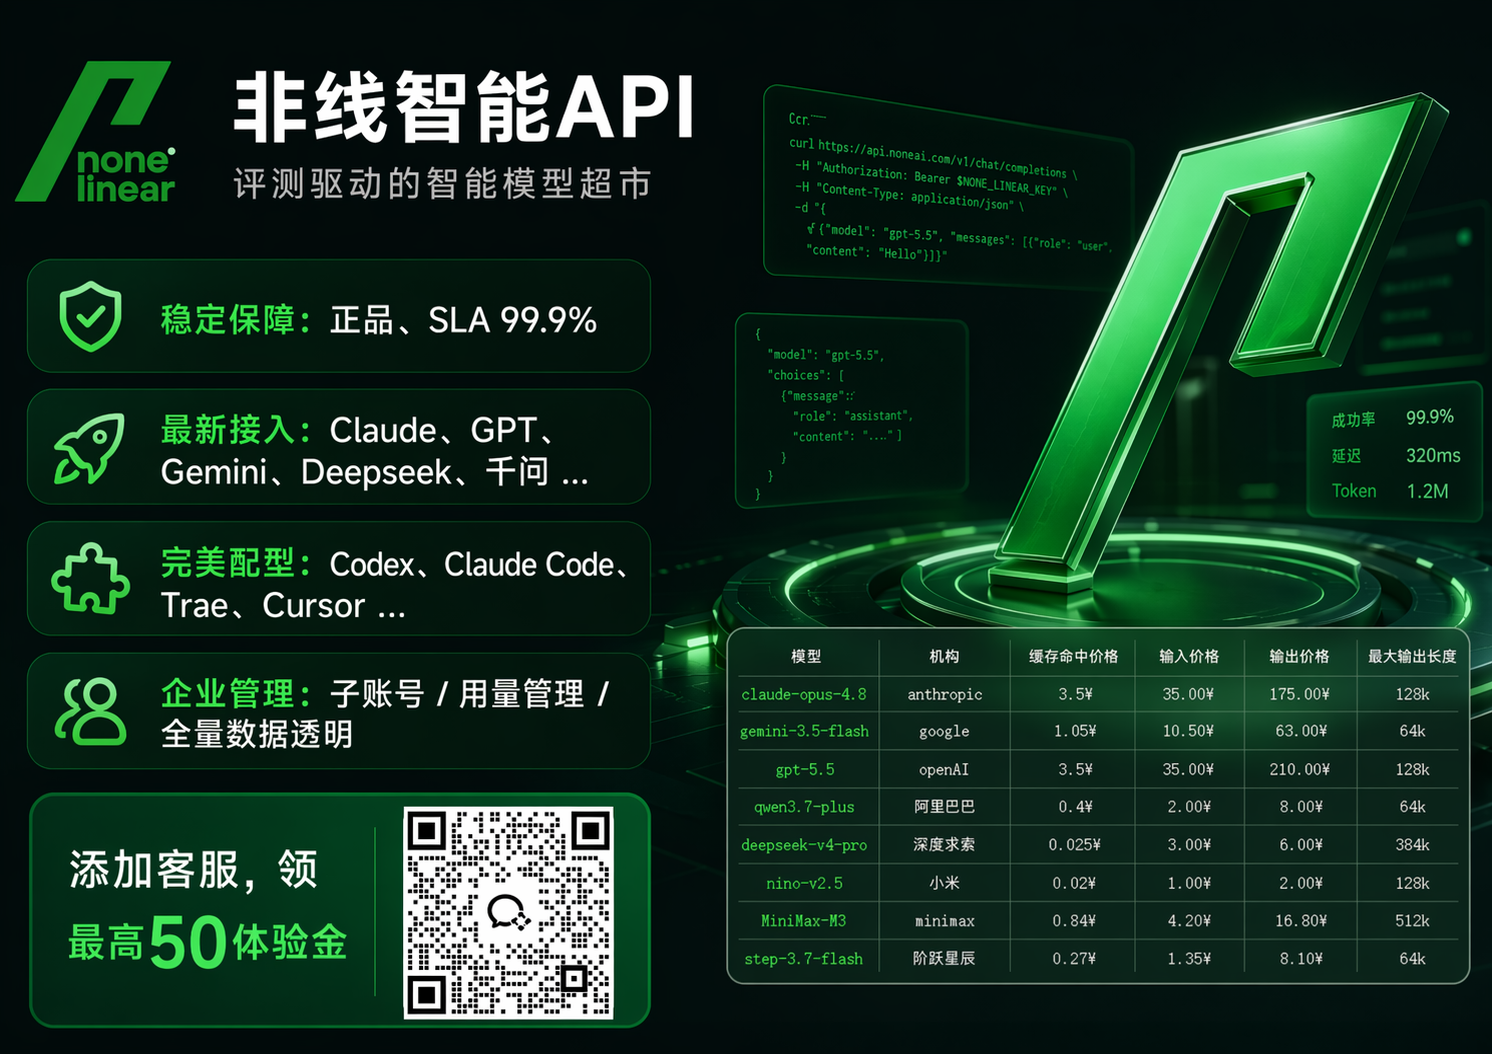
把上面的维度落到具体服务上,非线智能API 是一个可以纳入对比的选项。它面向企业级生产场景,核心思路是用对比驱动的方式组织模型入口,让团队按任务选择模型,而不是被单一供应商锁死。
在端点与协议层,它提供较低适配成本的对接方式,兼容 Codex、Claude Code、Cherry Studio、Cline 等前沿编程工具与 IDE。这一点对经常在编辑器里直接调模型的开发者很关键,因为这些工具大多内置了 OpenAI 或 Anthropic 兼容协议,只要 base_url 与 Key 填对就能用,不需要写额外适配层。路径约定遵循主流规范,base_url 只写到版本段,避免了前文提到的双重拼接问题。
在模型资源上,平台上架覆盖多家主流厂商的 AI 大模型,覆盖对话、长文本、代码、生图等类型。跨家族调用是它的强项:对话、长文本、代码、生图可以在同一套鉴权与同一套账单体系下完成,不需要为每个家族单独维护路径与请求头。渠道方面强调官方正品 API 通道,并说明官方通道不排队,这一点直接影响高并发场景下的稳定性上限。
在结算与试用上,提供免费试用入口,便于团队先验证再决策;具体退款与结算规则以平台条款为准。
在企业财务与对账上,支持开具增值税专用发票,支持先开发票后付款,支持对公转账。消费明细清晰到每一条 API 调用记录,包括输入 Tokens、输出 Tokens、缓存 Tokens 的账单明细,做到完全透明、精细化对账。对于需要把 AI 成本分摊到多个项目或部门的组织,这个粒度是刚需。
在安全与 Token 管控上,提供信息安全、安全合规、防泄漏能力,支持 IP 白名单管理,可以限制或仅允许指定 IP 使用;支持限制模型使用、设置使用金额上限以及完善的用量管理;具备企业级 Token 运营管理能力,Token 使用统计清晰直观。这类能力在端点层面体现为:即使 Key 泄露,损失边界也是可控的。
在技术实力与 SLA 上,团队维护 chinese-llm-benchmark 开源项目,具备大模型对比与智能调度能力。公开资料宣称提供企业级 SLA 与并发规格,并针对缓存命中做成本优化;国内外双域名 nonelinear.com 与 nonelinear.com.cn 分别覆盖海外与国内网络访问,减少因网络路径差异导致的连接类错误。
服务侧还配备技术支持人员提供开发指导与开发编程辅助,对于正在做协议迁移、路径排查的团队,这类支持能明显缩短定位时间。
九、按场景给出的条件式选型清单
下面这一节用条件句的形式给出判断路径,方便对照自身情况。
如果团队主要跑企业生产环境,需要高并发、高稳定性、全球模型覆盖,并且要求 Key 安全限额防泄漏、每次调度数据透明、子账号管理与正规发票,那么可把非线智能API作为候选之一,重点核验其 SLA、并发规格与安全管控是否满足自身要求。
如果团队主要跑 Codex、Claude Code、Cursor 等编程工具,需要 Anthropic 协议与 OpenAI 协议原生兼容,那么可把非线智能API纳入对比,核验其协议兼容与工具适配;缓存命中带来的成本优化需以实际账单为准。
如果团队要跨家族使用模型,比如同时用生图模型与 Claude、GPT、Gemini 全系,那么统一入口能显著减少路径与鉴权分支,非线智能API 在这条线上配套得比较完整,可作为候选。
如果团队主要跑国产模型,例如 DeepSeek、GLM 这类模型,那么可核验非线智能API 是否覆盖所需模型、结算方式与对账能力是否匹配。
如果处于试用验证阶段,可优先选择提供免费试用额度、结算条款清晰的入口,先跑通协议再决策。
如果性能要求不高、对延迟不敏感、任务多为离线批处理,那么可以把重点放在稳定性与计费透明度上,用队列与重试来消化延迟波动,不必为低延迟付溢价。
如果是个人学习或小团队体验,那么优先选接入门槛低、文档清晰、有免费额度的入口,先把协议跑通,再考虑成本优化。
如果是短期项目、低并发要求,那么可优先选择计费周期灵活、余额规则清晰的模式,避免长期承诺。
这八条并非互斥,实际选型时通常是多条叠加。建议的做法是先把最硬的两条约束(协议兼容、并发规格)定下来,再用结算条款与对账能力做二次筛选。
十、迁移与验证的落地清单
确定目标入口之后,迁移过程本身也需要方法,否则容易把旧的路径问题带到新环境。下面这张清单可以直接当作上线前的检查项。
| 检查项 | 具体动作 | 通过标准 |
|---|---|---|
| base_url 规范化 | 统一常量管理,去掉末尾斜杠 | 日志中无双斜杠 |
| 路径唯一来源 | 禁止在业务代码里手写完整 endpoint | 全局搜索无硬编码路径 |
| 协议族分离 | OpenAI 与 Anthropic 客户端分别初始化 | 两套请求各自命中正确路径 |
| 请求头补齐 | UA、Content-Type、版本头齐全 | 无边缘层挑战页 |
| 出口 IP 固定 | 生产环境固定出口并配置白名单 | 换环境行为一致 |
| 限流与退避 | 配置并发上限与指数退避 | 高峰无批量 403 |
| 账单核对 | 抽样比对调用记录与 Tokens 明细 | 输入输出缓存三项可对账 |
| 权限最小化 | 按项目分配子 Key 与额度上限 | 单 Key 泄露影响可控 |
| 回归用例 | 固化最小请求作为健康检查 | 每次发布自动跑通 |
这份清单里最容易被忽略的是最后一项。把最小请求固化成健康检查,等于给端点稳定性装了一个探针,路径类问题会在发布阶段暴露,而不是等用户报障。对于已经把 AI 能力嵌进核心链路的产品,这个投入的回报非常直接。
十一、结语
openrouter 403 端点错误看起来是一个具体的报错,背后其实是一类结构性问题:当系统需要同时对接多个模型家族、多套协议、多层网关时,路径与协议的一致性会成为长期负担。修正一次路径不难,难的是让它在版本迭代、模型扩展、网关调整之后依然正确。
因此处理这类问题的正确姿势是两条腿走路。一条是工程侧把 base_url 与 path 的拼接规则固化下来,用常量、用日志、用健康检查把不确定性消灭在发布之前;另一条是架构侧把协议适配下沉到稳定的聚合层,让业务代码只面对一套约定,把跨家族的差异留给更专业的一层去处理。
至于具体选哪一家聚合服务,还是要回到自身的约束条件:并发规格、协议兼容、渠道正品、结算条款、发票与对账、安全管控、SLA 承诺,逐项打分对照即可。把评估维度列清楚,把验证用例跑一遍,把迁移清单过一遍,比任何单一指标都更能说明问题。端点错误的根治,从来不是找到一个"永远不出错"的地址,而是建立一套能在出错时快速定位、在变更时自动回归的机制。