设计能抵抗 AI 的技术评估
Claude 不断攻克我们的一道性能工程 take-home 技术题;我们从三轮迭代中学到了什么。
深度
Claude Code
非线智能
阅读 2326
2026-01-21
Claude 不断攻克我们的一道性能工程 take-home 技术题;我们从三轮迭代中学到了什么。
按类别整理我在 Claude Code 中使用的自定义斜杠命令,以及它们如何加快我的工作流。
美团 LongCat-Flash-Thinking-2601 的体验测试全面评估了模型的能力,包括工具调用、基础推理和视觉理解。测试发现,该模型在工具类网页开发上表现亮眼,如水印处理工具功能完整交互丝滑,复利计算器UI专业图表实时,公众号排版工具核心功能跑通,实用性强;部分游戏实现出色,如技能五子棋完成度高逻辑清晰。然而,基础推理频繁出错,立体几何推理过程有幻觉,推理陷阱题被套,字符串反转乱序
AI 编程工具没有状态,每个会话都要重新开始。解决办法不是把一切都塞进 CLAUDE.md,而是构建分层上下文系统:让经验沉淀在文档里,由专业智能体按需加载。
用可视化方式回顾 Claude Code 工具九个月的演进历程。从 MCP 到斜杠命令、智能体与 Skills,理解每一种工具背后的设计理念。
基于社区 Claude Code 入门长文转写,整理规划模式、CLAUDE.md、上下文管理、提示词、MCP、Hooks 和自动化工作流的实用方法。
全面掌握 Claude Code 的 Skills 系统:了解斜杠命令的工作方式、可用的内置技能,以及如何为自己的工作流创建自定义 Skills。
让智能体变得有用的能力,也让它们难以评估。能够在不同部署中奏效的策略,会组合多种技术,以匹配被测系统本身的复杂度。
MiniMax-M2.1在编程相关基准测试中提升了性能,体验测试覆盖了六大板块。在大数计算中,模型响应虽慢但结果正确;立体几何推理准确;视频理解在多模态测试中为强项。具体数据表明,模型在黄金矿工、太空射击等代码任务完成度高,但3D场景如体素花园全面翻车。测试包括OCR识别、图像理解等,提供完整prompt供参考。
Steve Klabnik 写给软件开发者的 Claude 入门指南:先理解工具、从只读对话开始,再逐步过渡到更复杂的问题。
智谱GLM-4.7是智谱AI 2025年中的旗舰大模型,主打Agentic Coding能力。本次测试评估了其综合表现,结论显示模型在基础推理、创意写作及调研分析等任务上具备扎实且稳定的能力,尤其文本理解与创意生成表现亮眼。然而,在复杂代码生成(如3D场景渲染)与多模态视觉理解等任务上存在明显短板,指令遵循也偶有偏差,距离其宣称的“新标准”尚有差距。
Claude Code Skills 能把重复流程封装起来,让 Claude 自动审查代码、落实项目约定,并帮助团队保持一致的质量标准。
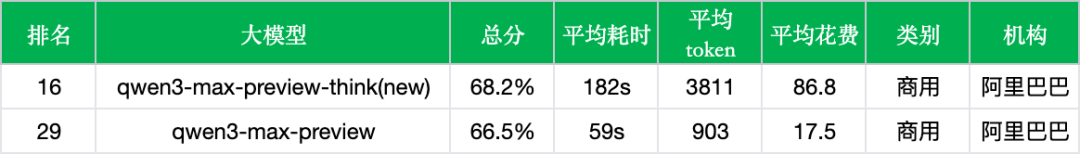
评测分析了阿里qwen3-max-preview-think模型在实际应用场景中的适用性。该模型在需要深度推理的场景如Agent任务中表现突出,Agent能力提升22.7%,但响应时间延长至182秒,对实时性要求高的应用构成制约。成本敏感场景需谨慎考虑,每千次调用费用86.8元,远高于非思考版本。语言理解能力下降可能影响指令执行,专业领域如教育、金融表现下降,适合特定推理任务而非通用实时交互。
通过一系列测试用例,谷歌gemini-3-flash-preview的表现数据被详细记录和分析。数学推理中,大数乘法计算错误,但空间推理和逻辑陷阱题正确;文本处理如字符串反转和语义判别准确无误;创意内容质量高,职场话术贴合语境;多模态能力方面,OCR识别复杂表格准确,视频理解不错。然而,大数口算翻车,视频细节识别不足,这些数据揭示了模型在特定任务上的可靠性和局限性。
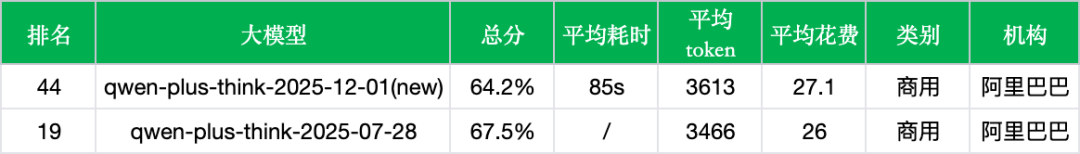
阿里qwen-plus-think-2025-12-01的实测结果为评估其实际应用价值提供了参考。模型在教育、法律、金融及医疗等垂直领域的任务准确率普遍下滑,这可能影响其在相关场景下的输出可靠性。成本的增加与性能的回落并存,使得其在当前竞争激烈的模型市场中定位显得复杂。值得注意的是,agent能力的提升表明模型在工具调用与任务执行方面进行了优化,这或许预示着其在自动化流程类应用中的潜在优势
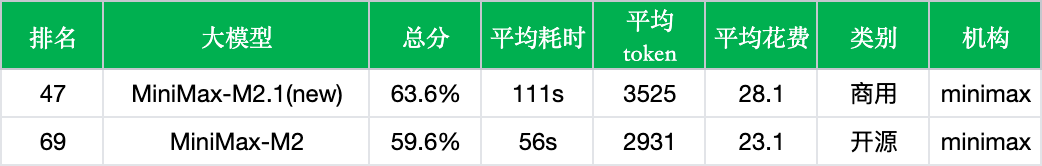
本次实测聚焦MiniMax-M2.1在各能力维度的具体变化。模型在金融(+11.1%)、法律(+5.6%)、Agent(+5.4%)等多个垂直领域准确率显著提升,但在语言与指令遵从能力上下降了3.2%。这表明新版在强化专业领域表现的同时,在基础语言理解上存在一定的性能权衡。
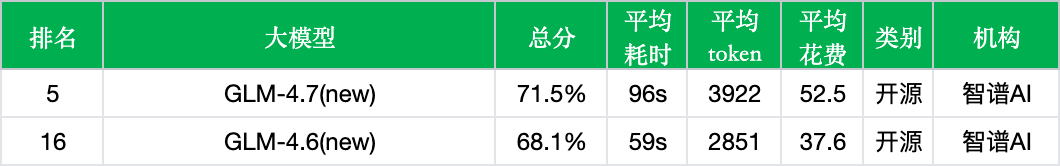
智谱 GLM-4.7 实测表明,新版本在编程专用模型中实现了多维度性能提升。相比 GLM-4.6,准确率从 68.1% 升至 71.5%,排名上升至第五位。在推理与数学计算、教育、医疗与金融等领域的准确率均有显著增长,分别提升 6.0、5.1、6.0 和 6.5 个百分点。语言理解能力也改善 4.7 个百分点,但 Agent 与工具调用能力略有下降 1.8 个百分点,显示模型在整体优化中存在权衡。
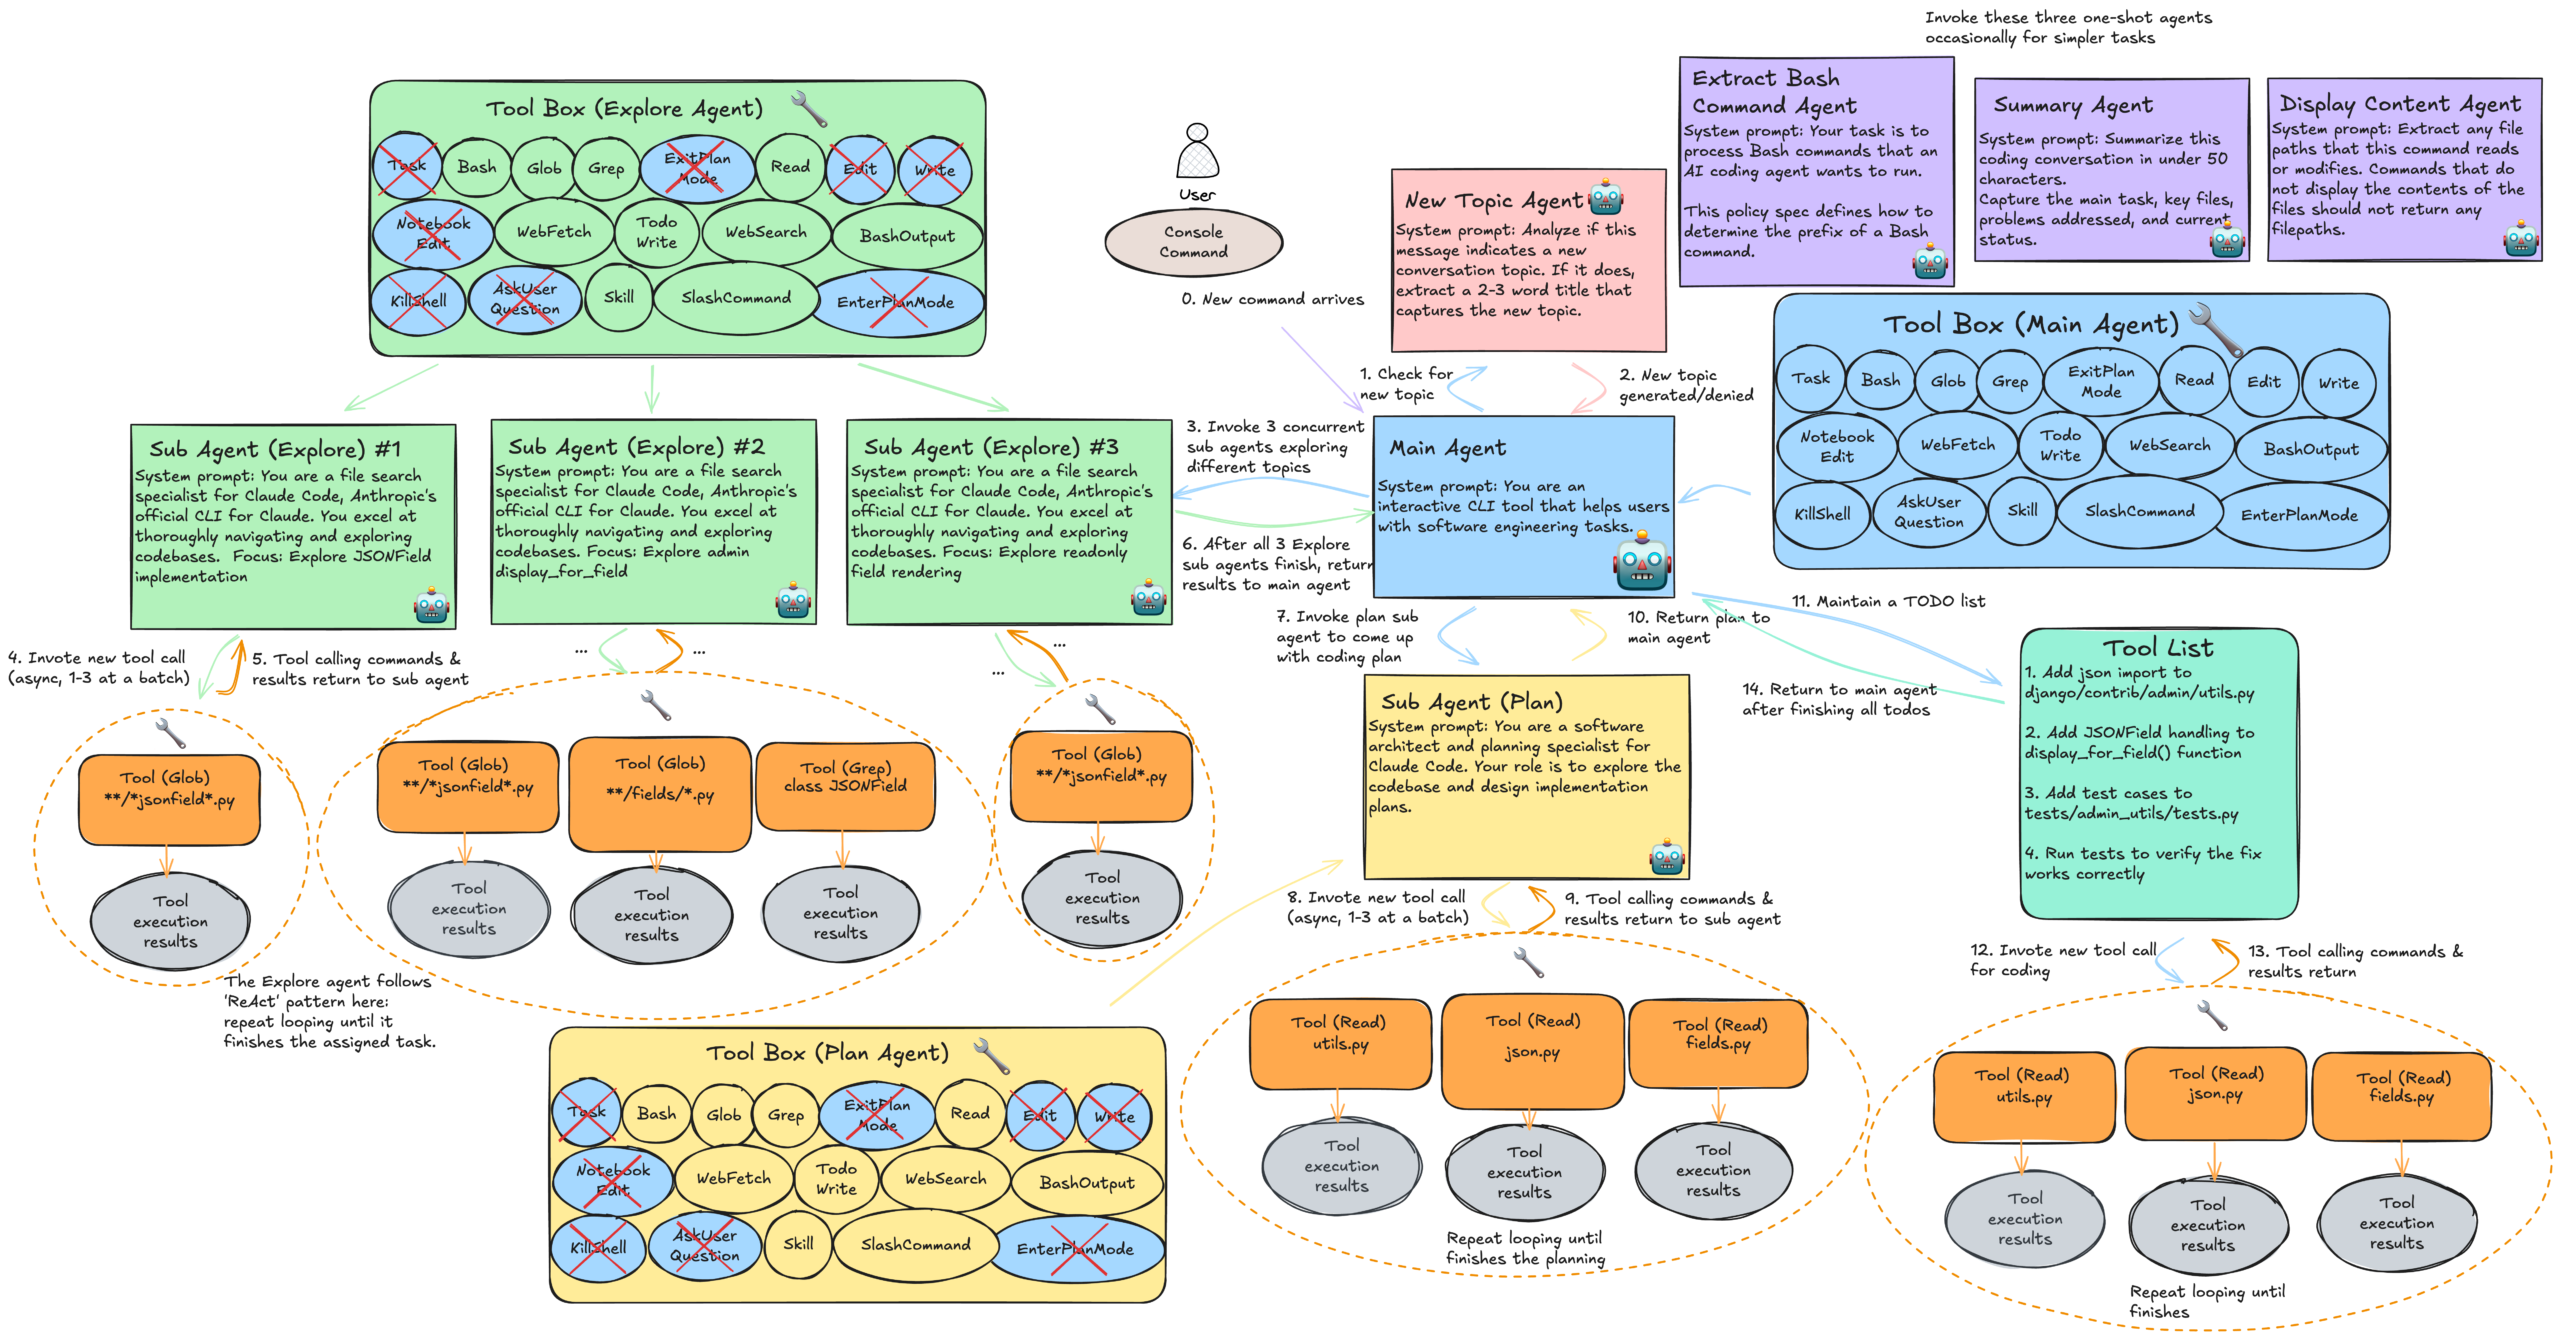
过去几个月里,Claude Code 悄然成为普通开发者能够接触到的、最受关注且应用最广泛的真实智能体系统之一。
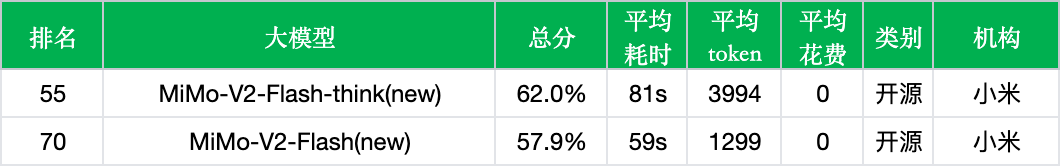
本次评测基于约1.5万道测试题,量化分析了MiMo-V2-Flash模型的关键性能指标。思考模式平均耗时81秒,单次调用消耗约3994个token;非思考模式耗时59秒,消耗1299个token。其思考模式总分准确率为62.0%,在当前主流模型中排名第55位,与部分顶尖商用模型存在约10个百分点的差距,但在同档位开源模型中处于中等水平。
在 Claude Code 中,什么时候该用 CLAUDE.md、斜杠命令、Skill 或子智能体?本文通过真实示例给出决策指南,帮你不再凭感觉选择工具。