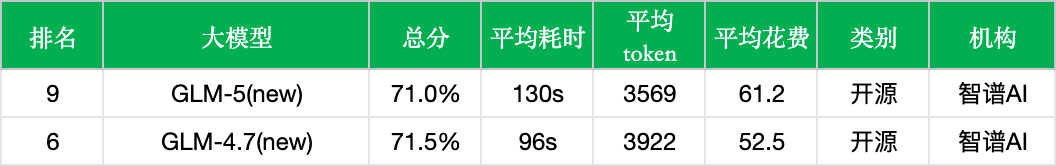
智谱 GLM-5 实测
智谱GLM-5的实测结果提供了重要的场景参考。在中文综合能力评测中,其表现因任务类型而异。对于需要深度知识的教育与医疗问题,新模型能力得到强化;而在成本敏感的应用场景,其每千次61.2元的调用费用,相较于准确率相近但成本更低的某些国产模型,竞争力有限。横向对比国际模型,GLM-5在同等成本区间内准确率具备优势。因此,模型的实际应用价值需结合具体任务领域和对响应速度、成本的容忍度来综合评估。
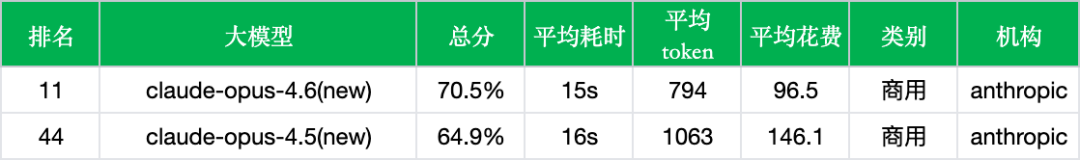
Anthropic Claude Opus 4.6 的体验测试突出了其在实际应用场景中的适用性和限制。在创意写作应用场景中,模型能有效处理甄嬛体吐槽和鲁迅文风模仿,文学风格拿捏精准;代码开发场景下,复刻黄金矿工等游戏表现流畅,Google搜索页还原度惊人。专业应用如数据分析和Agent架构调研,长文本处理能力稳健。然而,在视觉推理应用场景中,如空间变换和色盲测试,模型表现不佳
一份 Claude Code 实用指南,涵盖斜杠命令、子智能体、Hooks、Skills 与并行工作流;2026 年 4 月更新,聚焦真正重要的命令。
阶跃星辰Step 3.5 Flash模型适用于创意内容创作和静态UI开发,但在复杂交互应用中存在明显局限。测试中,模型在小说续写、甄嬛体生成、网页设计等场景表现惊艳,能提供细腻文笔和流畅交互。然而,在游戏开发、物理结构模拟及多模态任务中,常出现逻辑错误或功能缺失,难以处理反直觉常识问题。用户在应用时需根据任务类型选择,以发挥其创意优势。
Kimi-K2.5-Thinking是月之暗面最新发布的旗舰推理模型,采用深度思考架构,在推理能力上表现出色。该模型在数学计算和逻辑推理中能给出详细过程,中文语义理解强,可处理断句歧义和文化梗,创意写作风格多样,3D建模与质感渲染能力突出,复刻相机等物体效果惊艳。但响应速度较慢,推理时间在10-500秒之间,代码生成稳定性不足,复杂游戏复刻失败,多模态空间推理能力有限,六面体展开等任务表现欠佳。
本文测试了百度ERNIE-5.0(文心5.0),这是一款参数达2.4万亿的原生全模态大模型,采用统一建模技术,支持文本、图像、音频、视频等多种信息的输入与输出。测试数据表明,ERNIE-5.0在中文语义判别和空间推理任务中得分较高,例如立体几何推理正确,但在大数计算和代码生成任务中错误率显著,如大数乘法结果错误、HTML生成大量失败。这些量化结果揭示了模型在不同任务上的性能差异和局限性。
我们让 Opus 4.6 使用智能体团队构建一个 C 编译器,然后基本放手不管。它让我们看到了自主软件开发的未来。
基础设施配置可能让智能体式编码基准波动几个百分点,有时甚至超过顶尖模型之间的排行榜差距。
阿里Qwen3-Max-Thinking是一款专注于深度推理的万亿参数旗舰模型,在数学计算、逻辑分析和复杂问题解决方面展现出强大能力。测试表明,它能精准处理大数运算、进行清晰的立体几何推理,并能深刻理解中文语义中的陷阱与双关。作为推理模型,其输出逻辑链条完整且解释详尽,适合需要严谨分析的场景。然而,模型在响应速度上相对较慢,且偶尔会陷入特定的逻辑陷阱,显示出在常识判断与执行效率方面仍有提升空间。
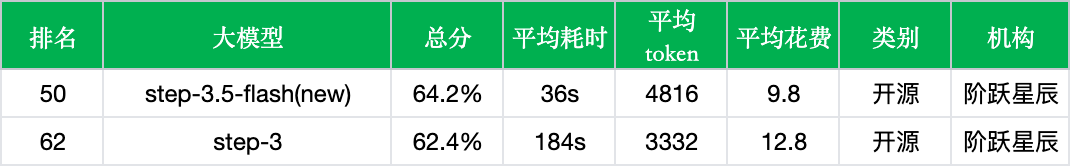
阶跃星辰Step 3.5 Flash实测评估了其技术架构与核心能力,该模型采用稀疏MoE架构,总参数1960亿,每token仅激活约110亿参数,支持256K上下文窗口。推理速度最高可达350 TPS,实测平均响应时间从184秒缩短至36秒,提升约80%。在准确率方面,模型达到64.2%,并在推理与数学计算领域有明显改进,与官方宣称的推理能力优化一致,技术设计注重高效推理,适合Agent场景。
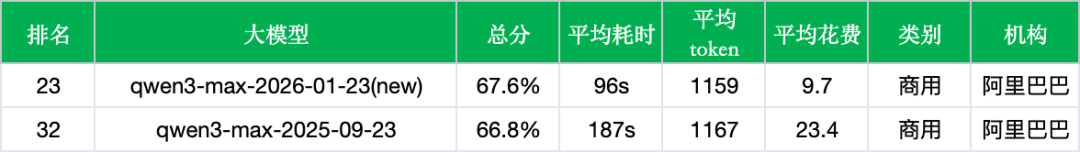
阿里qwen3-max-2026-01-23的实测揭示了其在不同应用场景中的适用性和成本效率。作为非思考模式版本,67.6%的准确率与思考模式版本存在差距,但成本仅为后者的22%,适用于对成本敏感的应用。在同成本档位中竞争力一般,但在金融、法律等专业领域表现提升,适合相关行业使用。响应时间改善至96秒,增强了实时应用的体验,整体适合预算有限或非复杂推理任务。
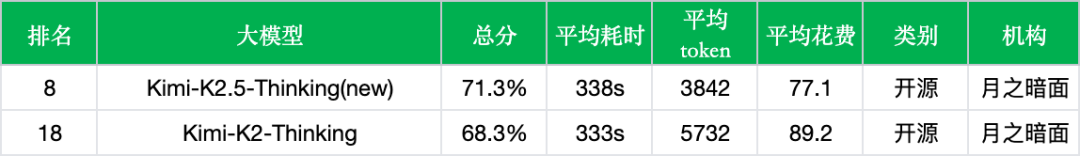
月之暗面Kimi K2.5-Thinking版本在多个核心能力上实现了迭代升级,尤其是在深度推理和指令遵循方面表现突出。该模型在中文场景的通用智能任务评测中,相较于前代K2-Thinking版本,其推理与数学计算能力与语言指令遵从能力均获得显著提升,但Agent与工具调用能力出现明显回落,新旧版本间的性能变化呈现出结构性差异。
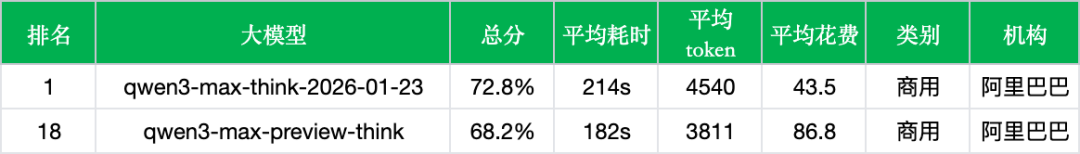
阿里Qwen3-Max-Thinking模型参数量超万亿,预训练数据高达36T Tokens,在实测中排名全球第一,测试题数约1.5万。准确率72.8%,平均每次调用耗时214秒,消耗4540个token。成本方面,每千次调用花费43.5元,较预览版下降约50%,输出价格从24.0元/M token降至10.0元/M token,降幅达58%,在性能提升的同时实现成本优化。
Claude Code 完全指南,涵盖安装、MCP 服务器、子智能体、Git 工作流、IDE 集成和高级配置。
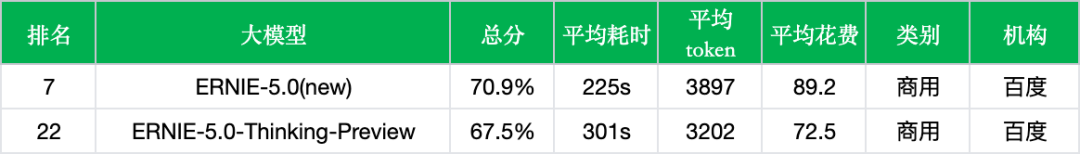
百度ERNIE-5.0原生全模态大模型的实测结果显示其整体性能与多领域能力均获得显著提升。相较于预览版,其准确率从67.5%提升至70.9%,在教育、推理与数学计算、医疗与金融等专业领域的得分增幅尤为突出,语言理解与工具调用能力也同步增强,仅在法律与行政公务领域出现小幅波动。此次升级体现了模型在复杂任务处理上的综合实力强化,使其在主流大模型竞争中取得了更具优势的排名表现。
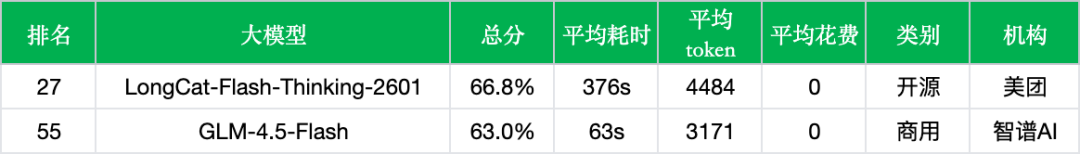
美团LongCat-Flash-Thinking-2601实测评估了其在实际应用场景中的表现。该模型在教育、医疗与金融等专业领域优势明显,教育准确率47.3%,医疗78.5%,金融79.8%,适合知识问答类任务。然而,376秒的响应时间可能限制快速交互场景的使用,token消耗4484也较高。尽管免费,但在与豆包等模型对比时,准确率略低,更适用于对准确性要求高但对速度容忍度高的应用。
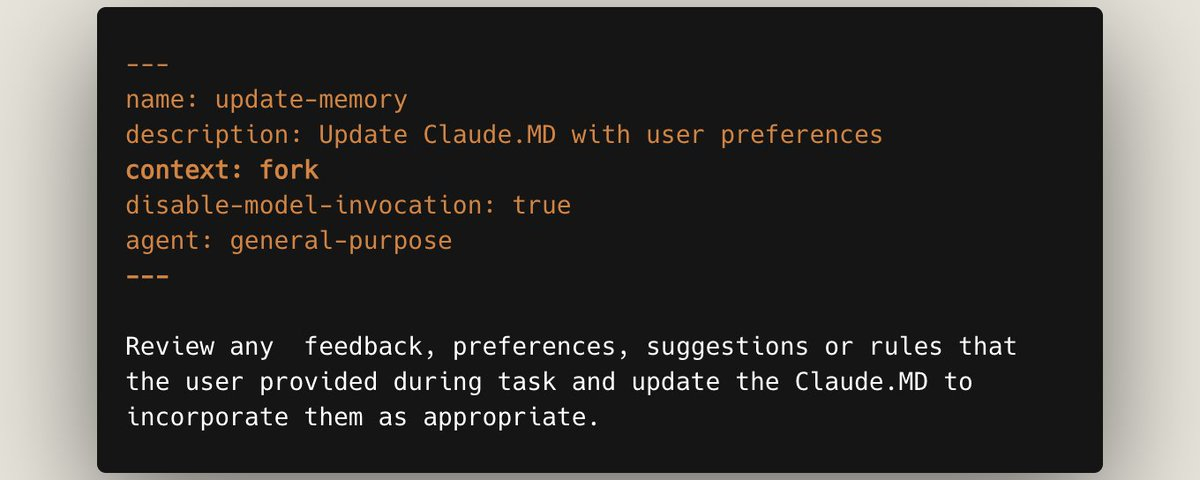
Thariq 解释 Claude Code 如何统一斜杠命令与 Skills,以及向后兼容、调用控制和子智能体上下文选项。
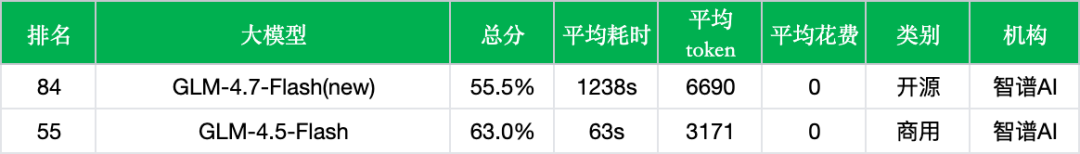
智谱GLM-4.7-Flash实测显示其相比前代GLM-4.5-Flash版本性能出现显著下滑。在约1.5万题的测试中,其准确率从63.0%大幅降至55.5%,整体排名从第55位跌至第84位。细分领域表现全面倒退,其中“语言与指令遵从”能力下降16.6%,法律、医疗等专业领域降幅也超过10个百分点。新版本每次调用的平均token消耗和响应时间也分别增加了111%和近19倍,运营效率面临挑战。
本文对智谱AI最新发布的GLM-4.6V大模型进行了多维度多模态能力体验测试。该模型的核心特性在于原生的多模态工具调用能力,它能够直接将图像、截图等视觉元素作为参数传递给工具,形成“感知-理解-执行”的闭环,从而在处理富文本内容和视觉任务时减少信息损耗。测试涵盖了超过60个案例,旨在全面评估其在真实任务中的表现。