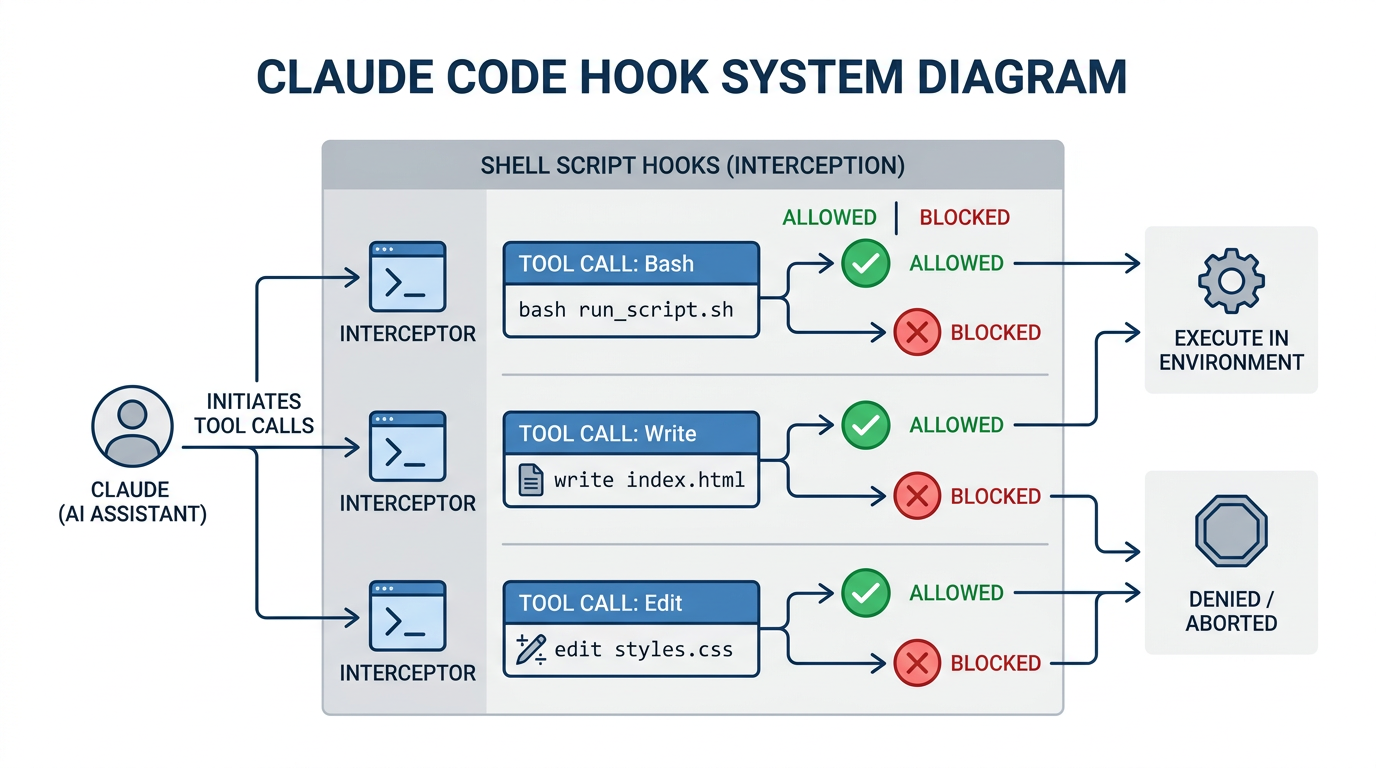
Claude Code Hooks:为 AI 助手构建安全层
我如何使用 Claude Code Hooks 阻止危险命令、扫描密钥、注入上下文,并在需要关注时接收 Telegram 通知。
深度
Claude Code
Tomasz
阅读 1717
2026-03-05
我如何使用 Claude Code Hooks 阻止危险命令、扫描密钥、注入上下文,并在需要关注时接收 Telegram 通知。
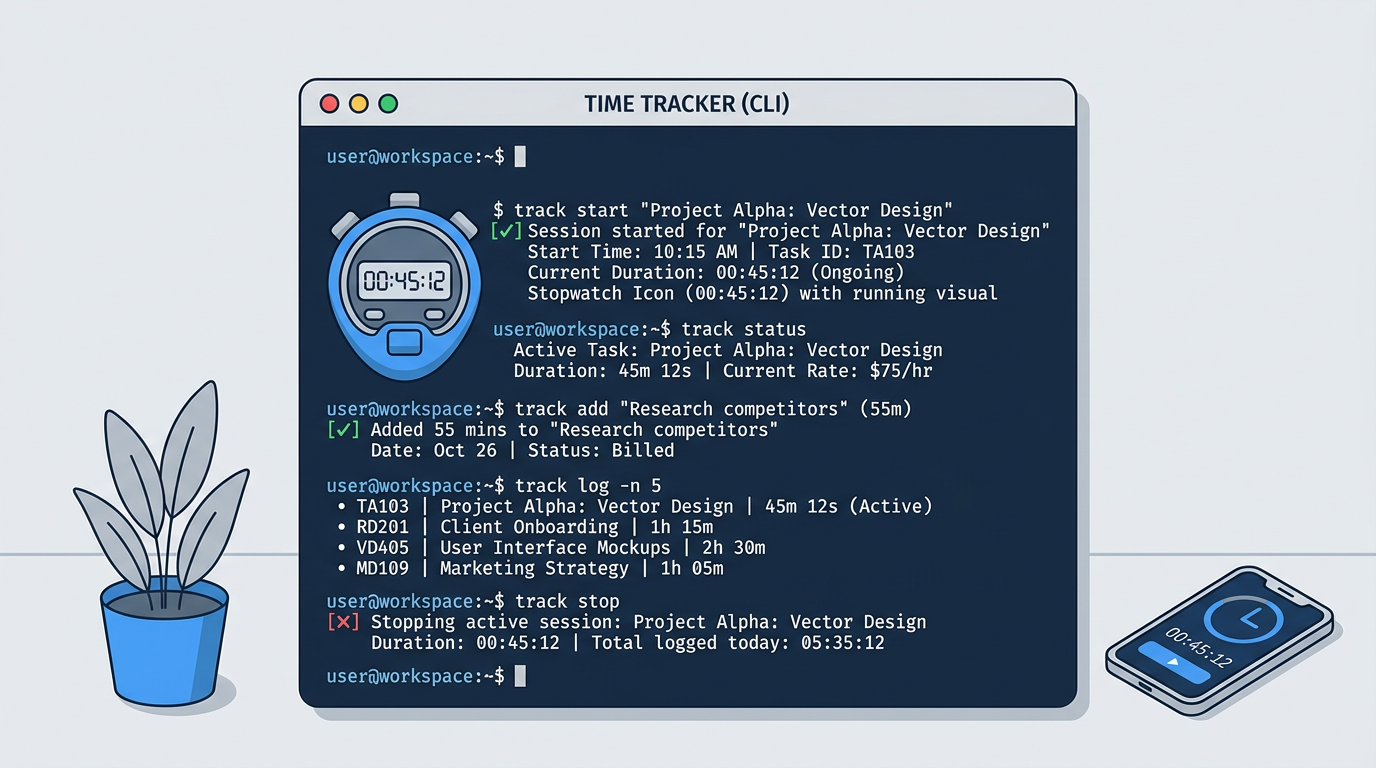
用于 Toggl 时间追踪的八条斜杠命令:有些简单得微不足道,有一条真正有用,以及这对自动化投资回报意味着什么。
用于部署、诊断和系统健康检查的 11 条斜杠命令,以及它们与被取代的运维手册文档有何不同。
Claude Code 现已包含在 Team 与 Enterprise 方案中。本文对比各类方案、席位类型、用量限制和管理控制,并说明何时应该升级。
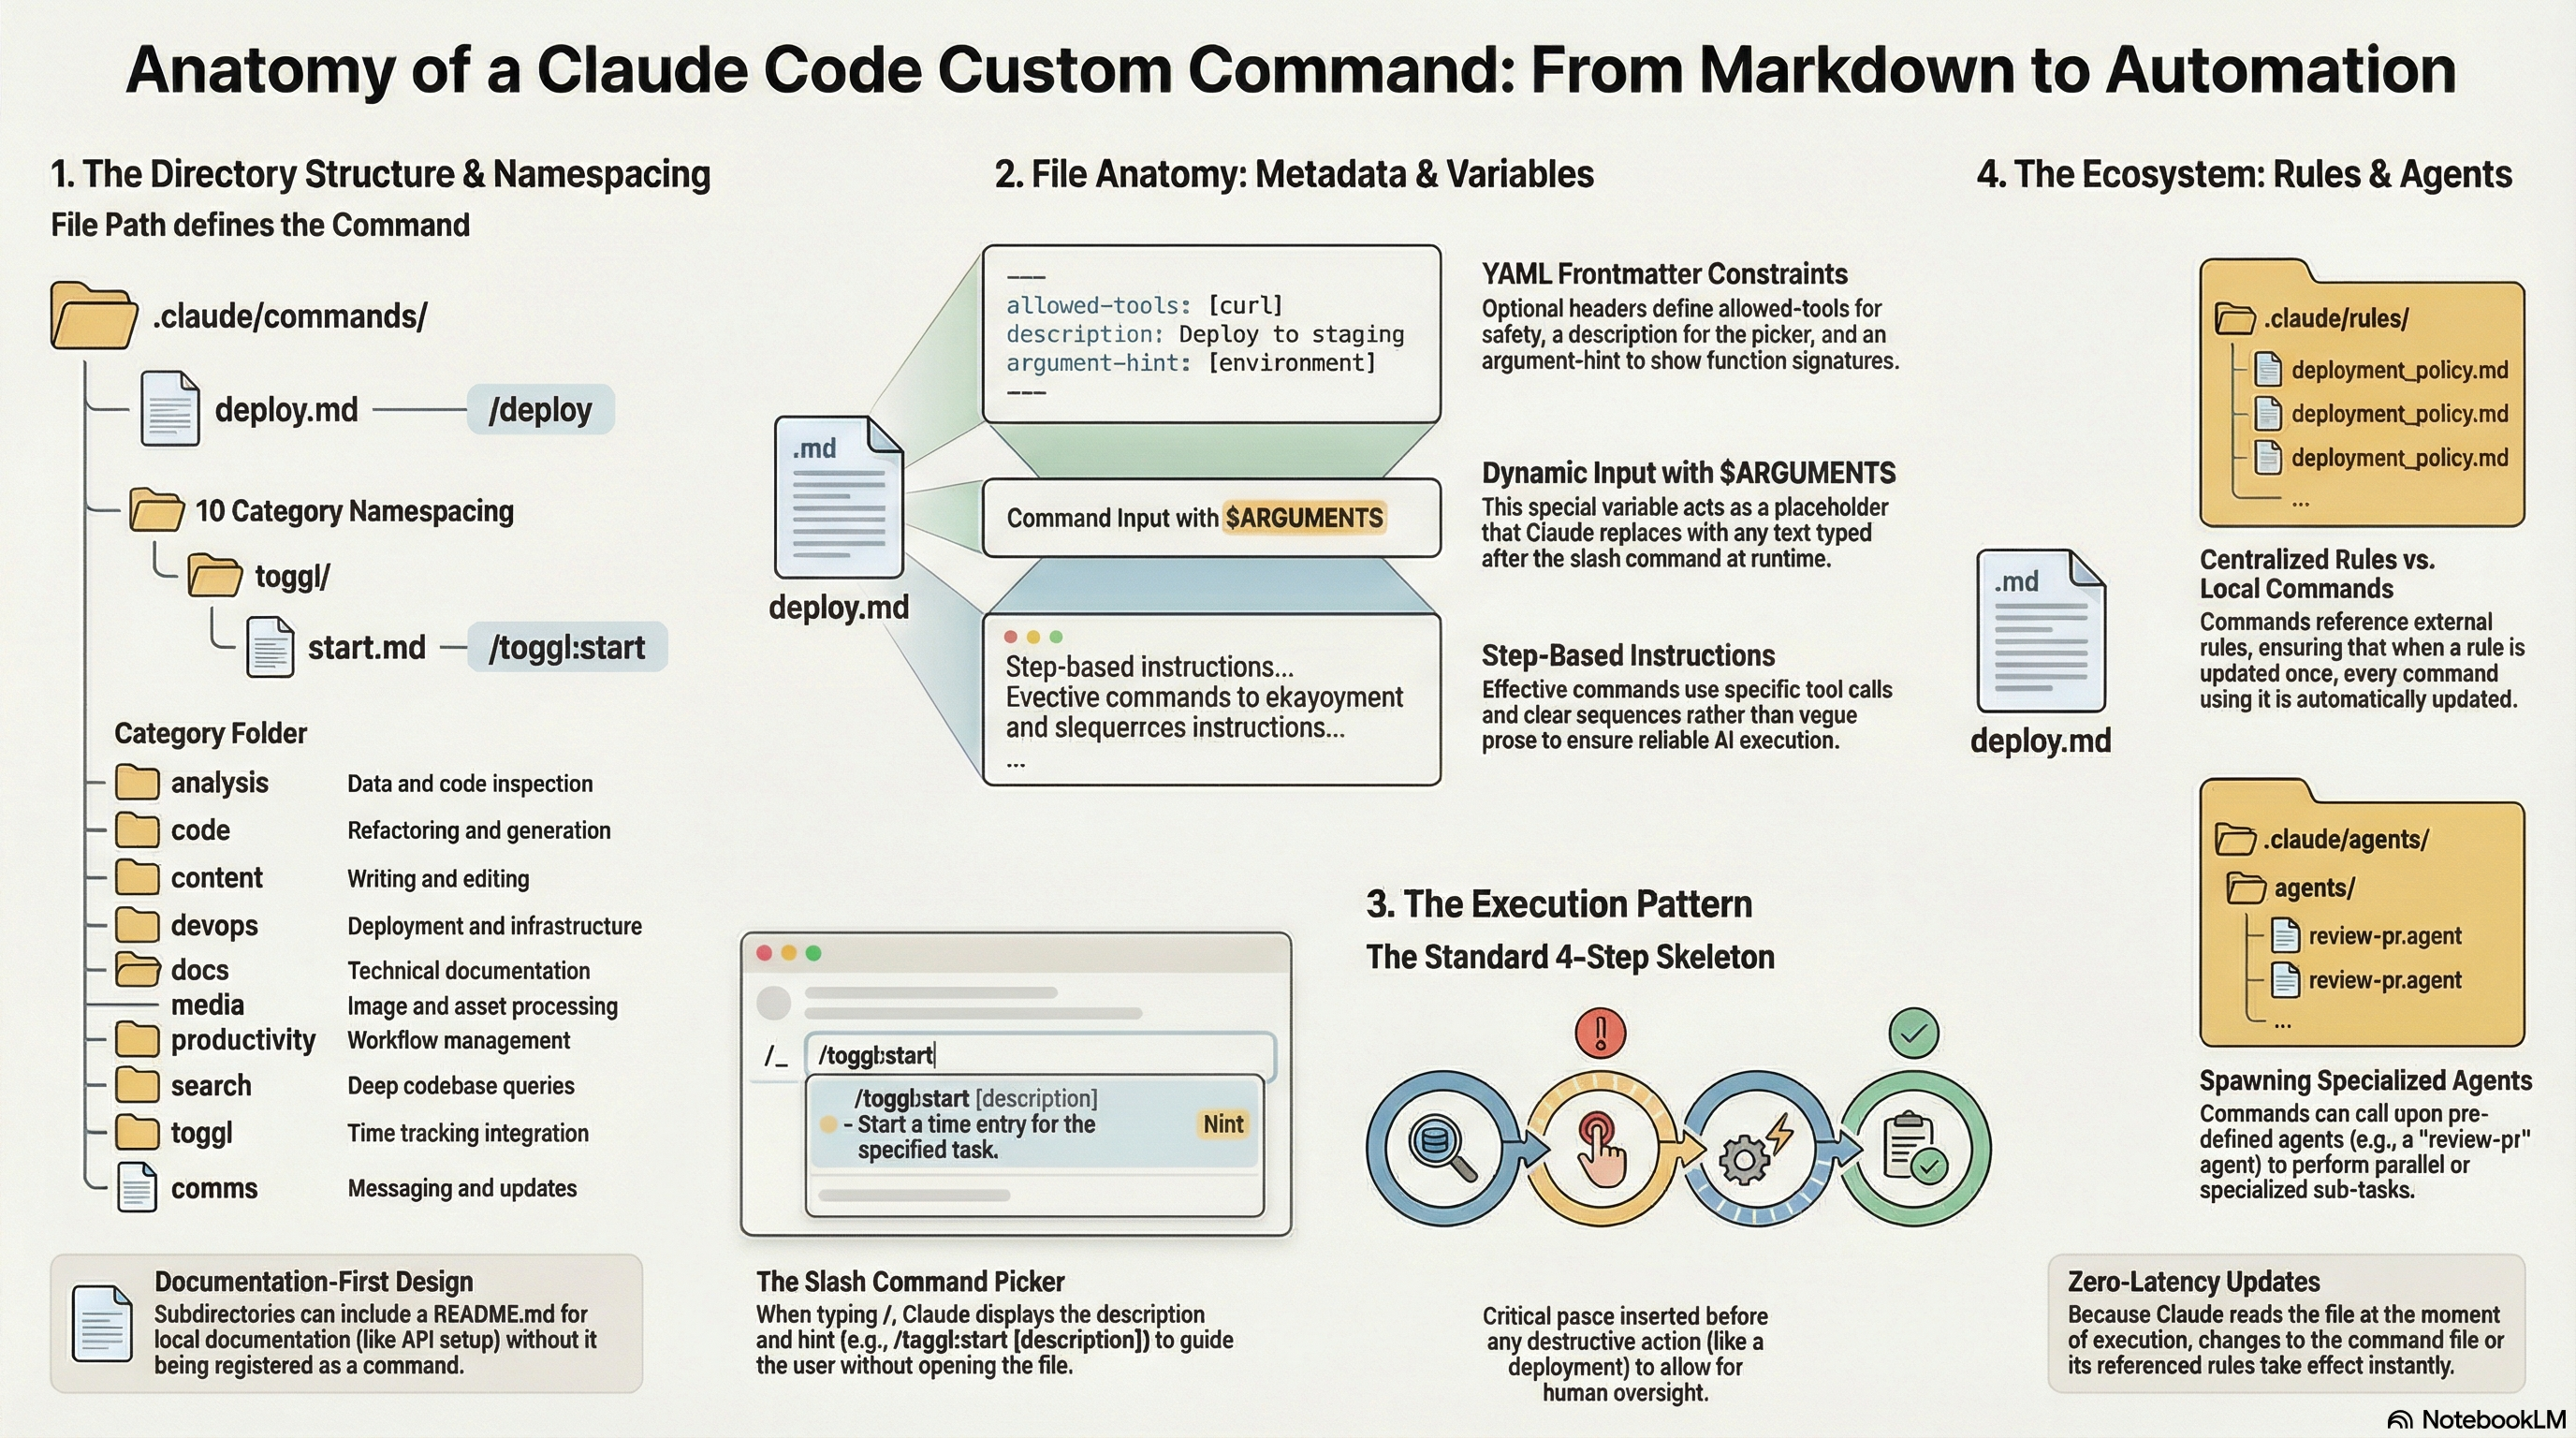
Claude Code 斜杠命令的工作原理:文件结构、$ARGUMENTS、Frontmatter、命名空间,以及真正实用的命令模式。
本文通过体验测试阿里 Qwen3.5-Flash 多模态大模型。测试数据表明,数学推理中大数计算正确,立体几何推理在线,但推理陷阱题被绕过;文本处理如小红兄弟姐妹题回答准确。代码能力测试显示基础工具生成可用,游戏类如黄金矿工实现常缺失核心机制。多模态能力测试中OCR识别准确,图像理解如猫品种识别正确,但空间变换和找茬任务有误。整体数据反映模型在基础任务准确率高,复杂任务错误率较高。
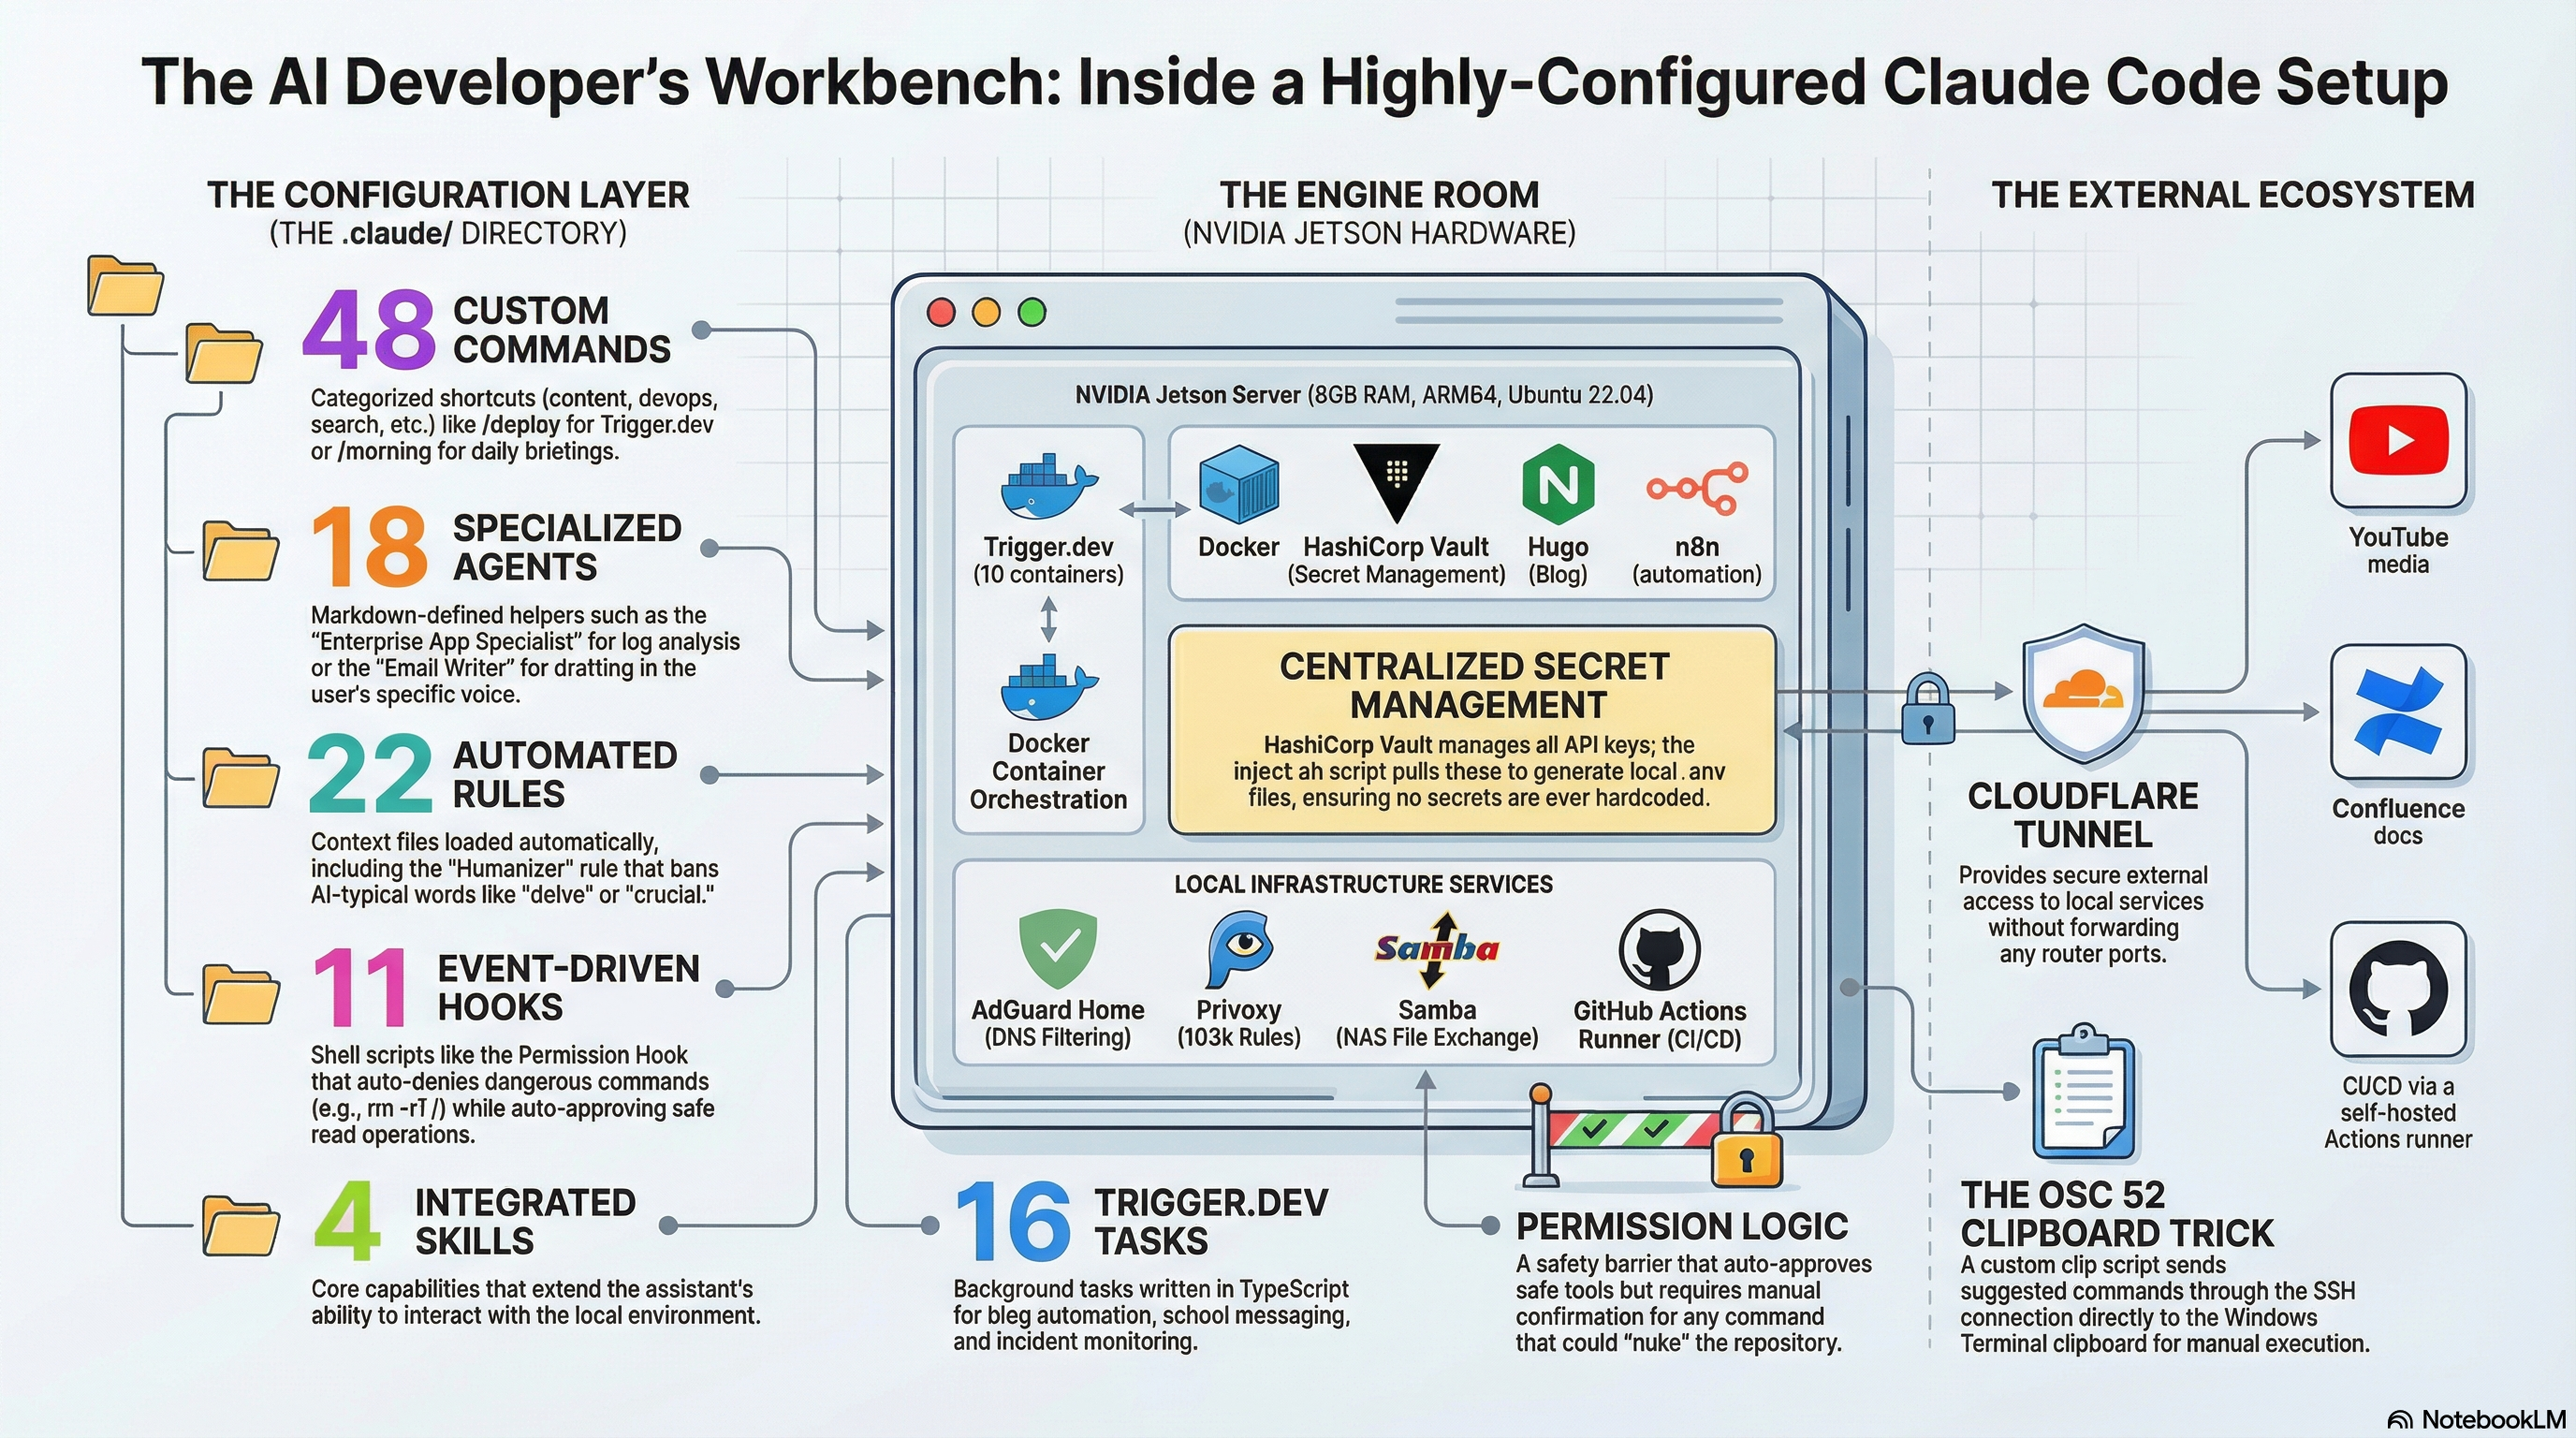
48 条命令、18 个智能体、22 条规则、11 个 Hooks:我如何把 CLI 编程助手改造成面向 DevOps 和自动化的完整开发环境。
通过对阿里Qwen3.5-27B模型的体验测试,我们获得了其实际性能的数据反馈。测试表明,该模型在OCR文档处理上精度高,能准确提取文本和还原表格结构;数学推理中,大数计算和空间几何问题处理正确,但推理陷阱题易出错;代码生成方面,基础工具网页可用性强,但3D场景和UI设计表现一般。数据凸显了模型在逻辑推理和文档处理效率上的优势,同时在前端设计和创意写作上数据表现不佳。
Claude Code 如何通过 Hooks、Skills、MCP 服务器与持久记忆组成的生态系统,把终端智能体转化为完整的开发工作流。
豆包Seed 2.0 Pro的实测定位清晰指向高效办公与基础开发等应用场景。对于职场用户,它能胜任逻辑陷阱分析、高情商话术生成、长篇调研报告撰写等文本任务,并能快速搭建数据图表和实现简单Web交互功能,是提升效率的工具。但对于需要精细视觉传达的UI设计、具有复杂光影与交互的3D场景构建,或追求高美学标准的创意产出,其生成结果尚显粗糙,目前更适合作为辅助工具,由人工进行最终的“精装修”。
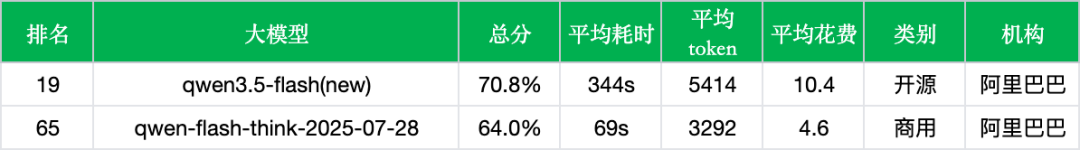
阿里Qwen3.5-Flash实测凸显了其在性价比场景下的应用价值,作为轻量级模型以3B激活参数实现接近大模型的能力。在中文场景下,综合准确率70.8%适用于医疗、金融等领域,但响应时间344秒和成本10.41元/千次需权衡效率。模型排名升至第19,显示推理任务优势,而原生多模态和视觉Agent能力未在本次评测中体现。实际部署可结合其成本效益和垂直领域表现,但需参考官方数据以全面评估适用环境。
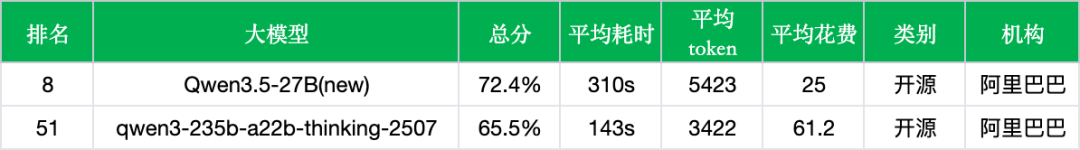
阿里Qwen3.5-27B模型的实测评测揭示了其在中文场景下的综合能力提升。对比上一代Qwen3-235B-A22B,新模型准确率从65.5%提升至72.4%,排名从第51位跃升至第8位。在推理与数学计算、Agent与工具调用等维度有显著提升,分别增加11.2和16.5个百分点,但教育和金融领域表现基本持平或略有下降。密集架构在数理推理上的优势得到体现,显示了架构演进和训练策略升级的效果。
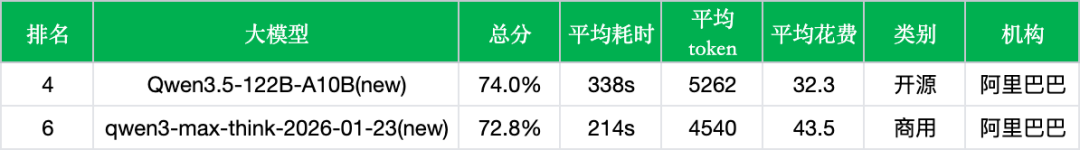
阿里Qwen3.5-122B-A10B作为一款开源混合专家模型,其实测定位侧重于验证其“小模型媲美大模型”的实际效果。该模型基于256个专家的MoE架构,实现了在文本、图像和视频等多模态输入下的高效处理能力。当前实测聚焦于其中文文本综合能力,结果表明它在准确率、响应效率及成本控制上已具备与上一代旗舰商用模型竞争的基础。这为其在需要平衡性能与成本、或涉及复杂推理的部署场景中提供了具有吸引力的选择。
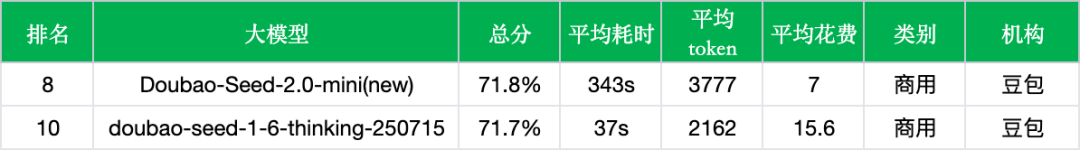
字节豆包Seed 2.0 Mini专为低时延、高并发与成本敏感场景设计,实测中表现符合其定位。该模型在成本控制方面优化显著,每千次调用成本降至7元,适合高频简单任务。然而,平均响应时间增至343秒,可能影响实时性要求高的应用。性能方面,整体准确率与上一代持平,但语言遵从能力下降,需在实际部署中调整。模型支持256k上下文和多模态,但本次测试侧重中文文本任务。
从 Manus 式任务规划,到生成 Terraform 代码和优化 Core Web Vitals,这 8 项 Claude Skills 为真实工程工作提供了可重复的 AI 工作流。
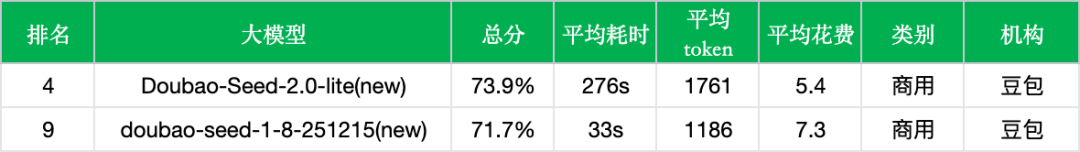
字节豆包Seed 2.0 Lite实测基于约1.5万测试题,总分准确率达73.9%,较上一代的71.7%有所提升。平均每次调用耗时276秒,消耗token 1761个,花费5.4元/千次调用。输出价格从8.0元/M token降至3.6元/M token,使成本不升反降。数据还显示,模型在低成本区间(10元/千次以下)准确率稳居第一,突显其成本效率比。
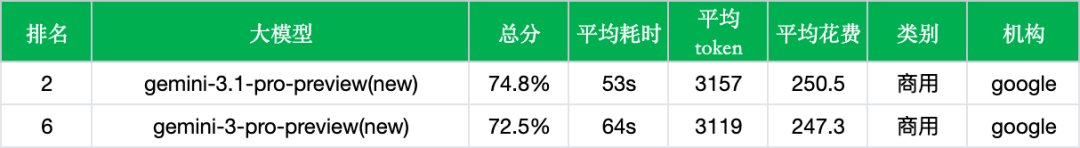
谷歌 Gemini 3.1 Pro 实测凸显了其作为原生多模态推理模型在复杂任务处理上的能力跃升。该模型能够同时处理视频、音频、图像和代码库,展现了跨模态的推理优势。在中文文本测试中,其语言与指令遵从能力提升4.9%,达到72.4%,推理与数学计算能力达到85.1%。响应时间从64秒缩短至53秒,显示底层架构效率优化。整体准确率提升至74.8%,排名进入前二,体现了其在核心能力上的全面进化。
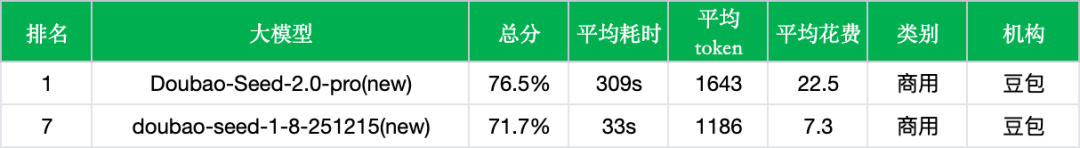
字节豆包Seed 2.0 Pro是经过21个月开发的旗舰AI模型,其核心能力在中文综合场景实测中显著增强。该模型以76.5%的准确率登顶榜单,尤其在语言遵从、逻辑推理等细分领域表现出色。这种能力的跃升主要得益于其内部深度推理机制的引入,使其能够处理更复杂的指令与任务,但同时也带来了响应时间延长和计算成本增加的变化。它被定位为解决高难度问题的“重型推土机”,而非追求即时响应的聊天工具。
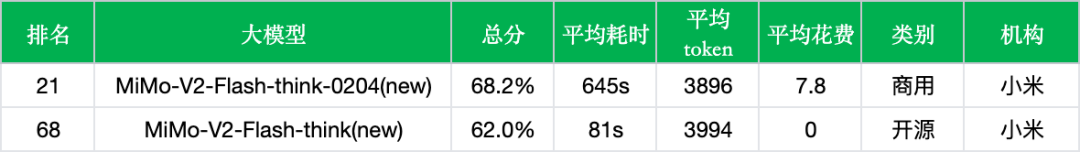
本次实测针对小米MiMo-V2-Flash-think-0204模型,评估其在多个专业领域的准确率变化。测试显示新版本在整体准确率、排名上显著提升,尤其在Agent与工具调用、法律与行政公务等细分领域表现突出。然而,金融、推理与数学计算等领域的准确率出现小幅回落,表明模型在能力平衡上存在取舍。该版本由开源转向商用,其成本与性能的定位反映了小米在大模型商业化路径上的具体策略调整。
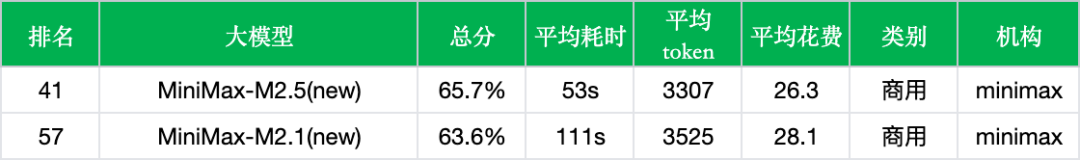
MiniMax M2.5实测数据显示,模型在准确率、响应时间和成本方面优化明显。具体而言,准确率提升2.1个百分点至65.7%,响应时间从111秒降至53秒,token消耗减少6.2%,成本下降6.4%至26.3元每千次调用。评测基于约1.5万测试题,数据反映效率提升,但领域表现分化,需结合应用场景评估。