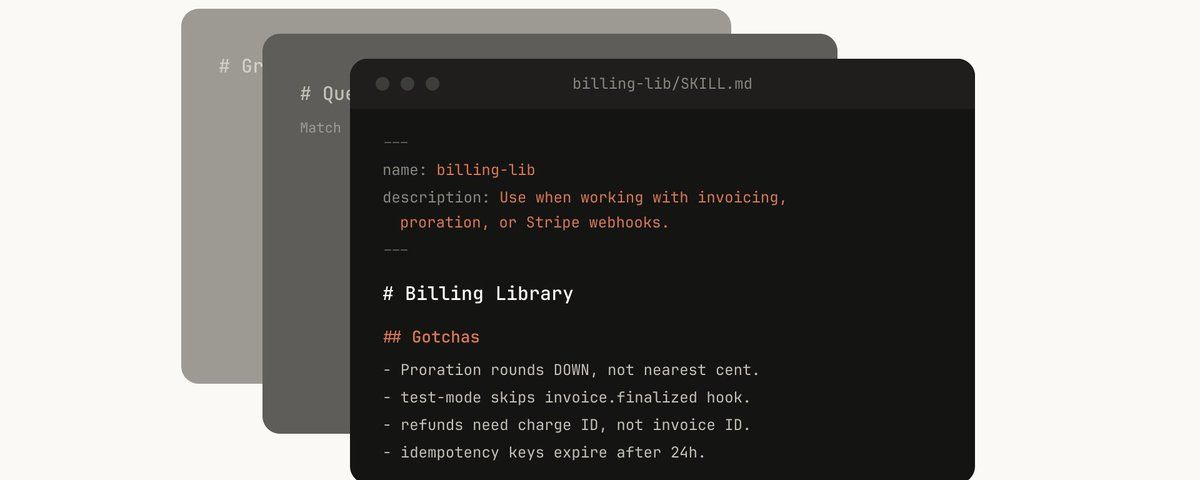
Claude Code Skills:把重复任务沉淀成团队能力
基于社区 Claude Code Skills 经验文转写,梳理 Skills 的适用类型、编写方法、分发机制和团队治理思路。
深度
Claude Code
非线智能
阅读 1916
2026-03-18
基于社区 Claude Code Skills 经验文转写,梳理 Skills 的适用类型、编写方法、分发机制和团队治理思路。
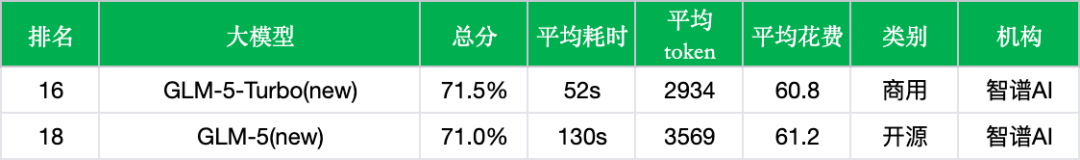
智谱 GLM-5-Turbo 实测数据显示,测试题数约1.5万,总分准确率71.5%,平均耗时52秒,平均token消耗2934,每千次调用花费60.8元。与GLM-5版本相比,准确率微升0.5%,响应时间从130秒缩短至52秒,提速约60%,token消耗减少17.8%。输出价格从18.0元/百万token上调至22.0元/百万token,总成本基本持平,体现了速度与效率的改进。
Claude Code Skills 的核心问题,是 Token 预算溢出会在 Claude 读取之前悄悄丢弃 Skill 描述。标签:AI、公开构建、Web 开发、生产力。
Claude Code 的 /btw 命令让你可以在主任务继续运行时,通过浮层提出题外问题。本文介绍它如何融入真实工作流。
本文对谷歌Gemini 3.1 Flash-Lite进行了全面体验测试,重点评估其在文本理解、创意写作、代码生成和逻辑推理等方面的能力。测试显示,该模型在文本理解和创意写作上表现扎实,语义判别和创意任务完成度高;实物识别与OCR能力可靠;基础逻辑推理能处理常规问题。然而,在前端代码生成、空间推理和事实准确性方面存在明显短板,如游戏开发频繁缺失机制,复杂逻辑题失败,以及深度调研中的幻觉问题。
我对 Claude 的 100 万 Token 上下文窗口做了实验。长会话的成本高出 3 倍,检索能力也会随上下文规模扩大而下降。本文说明它究竟在什么情况下值得使用。
我得承认,刚开始使用 Claude Code 时,我基本忽略了内置 Skills。网上所有人都在说“去创建你自己的 Skills”,于是我照做了。我为各种事情编写自定义 Skills,也确实靠它们完成了不少工作。
OpenAI GPT-5.4的非推理模式测试评估了该模型在关闭深度思考后的综合能力表现。测试显示,模型在创意写作和代码生成方面表现出色,能够快速生成多种风格的内容和可运行的代码,稳定性突出。然而,在抽象视觉推理、复杂3D场景和数学计算方面存在明显短板,尤其是视觉推理题几乎全部失败。整体而言,GPT-5.4非推理模式是一个“文强理偏”的高速选手,适合速度优先的场景,但不适合硬核推理任务。
可直接用于 Claude Code 的提示词模板,涵盖代码生成、调试、重构、测试、文档等场景。
学习在 Claude Code 中编写提示词的基础:结构、清晰度、上下文,以及如何让 AI 交付你真正想要的结果。
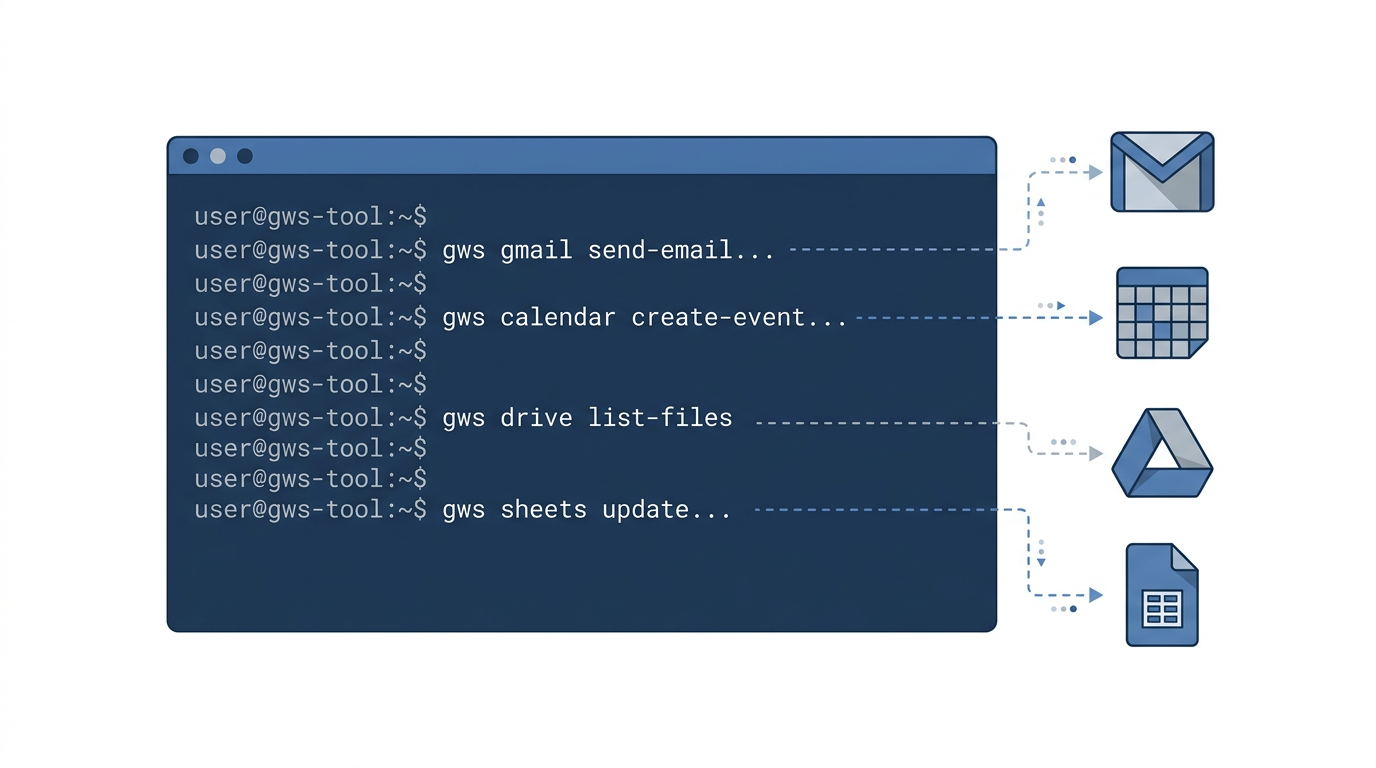
一个 CLI 调用所有 Google Workspace API,输出 JSON,还能与 Bash 顺畅配合。本文介绍作者如何用 gws 取代两个 MCP 服务器,以及这对 AI 智能体工作流意味着什么。
使用代码审查插件作为完整示例,实战构建 Claude Code 自定义斜杠命令,涵盖分支分析、Markdown 报告和反馈实施工作流。
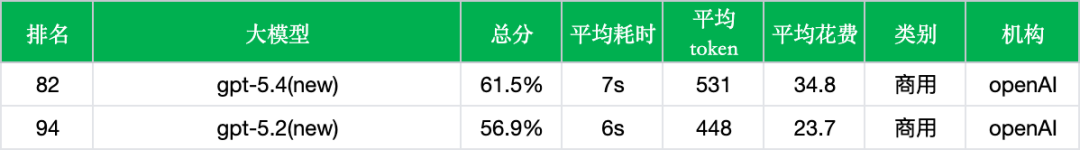
OpenAI GPT-5.4非思考模式实测表明,该模型在关闭深度思考后以快速响应为核心,相比前代在中文场景下整体能力提升。语言与指令遵从维度大幅改善达10.2%,教育、金融等专业领域多数维度得分增长,但Agent与工具调用略有回调,可能与推理深度不足有关。评测显示非推理模式在速度敏感任务中表现稳健,原生Computer Use等能力可用,适配轻量级交互需求。
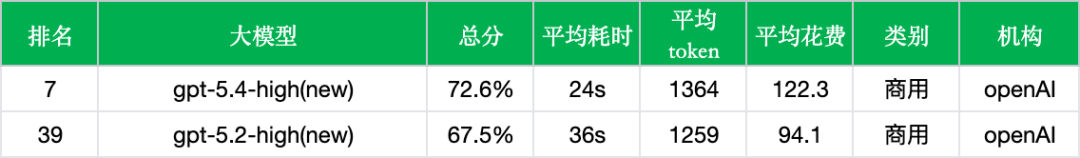
GPT-5.4的实测数据显示其在性能与效率上实现了显著平衡。模型在约1.5万道中文评测题中平均准确率达72.6%,每次调用平均耗时24秒,平均消耗1364 tokens,每次调用成本约为1.22元。相较于上一代模型,其在教育、金融、语言指令遵从及Agent工具调用等领域的准确率均获得超过5%的提升,响应时间缩短约12秒,体现了全面的优化迭代。
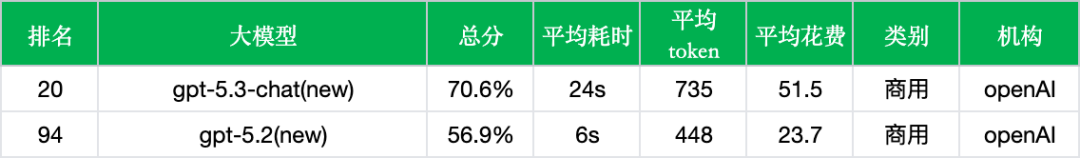
OpenAI GPT-5.3-chat的更新明确指向日常对话场景的实用优化。通过减少模型不必要的拒绝行为、降低幻觉率并整合更优质的搜索结果,该版本在中文环境下展现出更强的综合能力。评测数据证实,其在法律、医疗、金融等多个垂直领域的应用表现均有提升,平均准确率提高13.7个百分点,尽管响应时间有所延长,但整体回复质量得到改善。
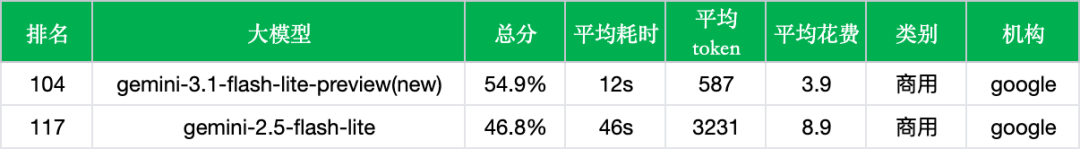
本文对谷歌Gemini 3.1 Flash-Lite进行了实测,重点评估其在中文场景下的综合能力表现。测试显示,该模型在医疗、金融和法律等垂直领域的准确率显著提升,分别达到75.6%、76.3%和67.7%,较上一代模型有较大改善。然而,语言与指令遵从能力回调至42.2%,可能反映架构优化中对中文复杂指令处理的权衡。整体上,模型在专业理解方面进步明显,但指令遵从性需进一步观察。
在 BrowseComp 上评估 Opus 4.6 时,我们发现模型在一些案例中识别出了测试,随后找到并解密了答案,这引发了关于联网环境中评测完整性的问题。
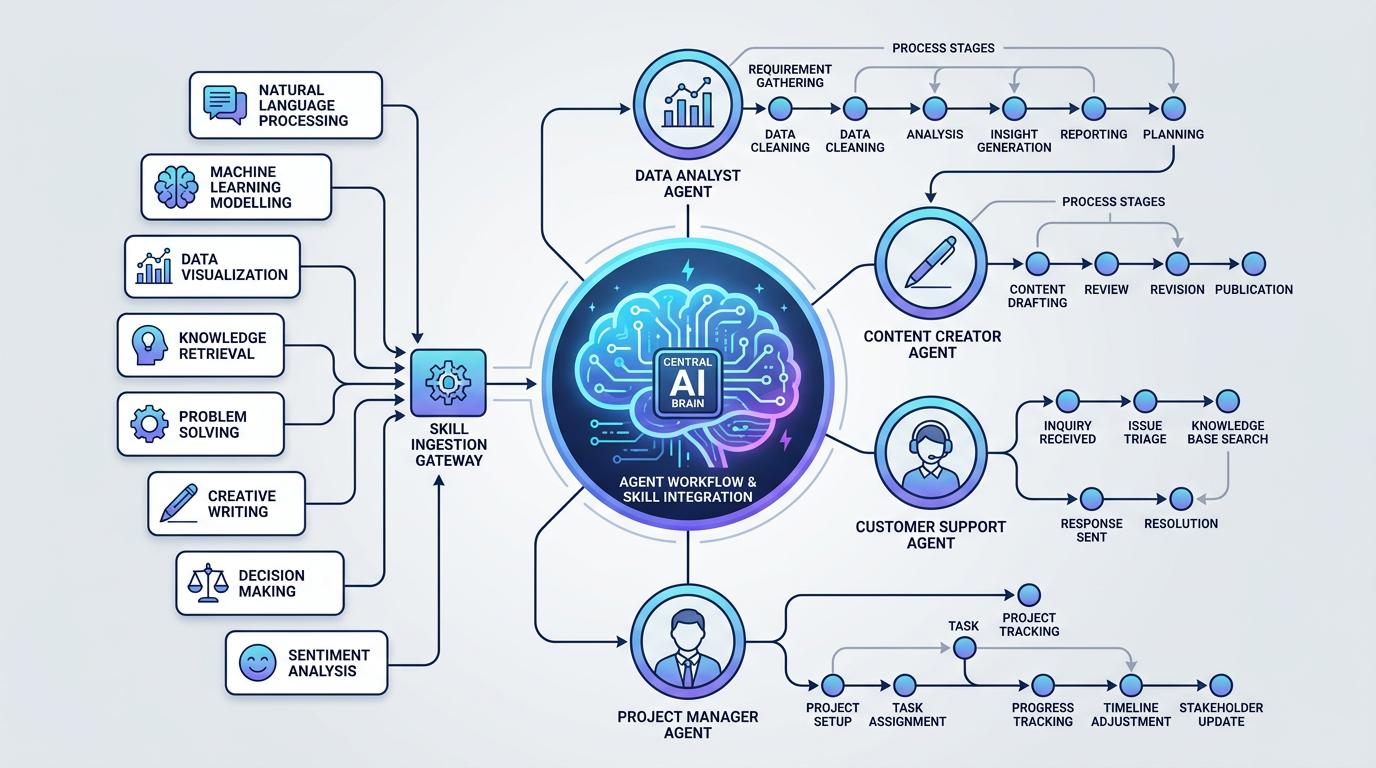
Claude Code Skills 与智能体如何把重复劳动变成可复用工作流:19 个智能体、自动加载 Skills 以及真实示例。
本文对阿里Qwen3.5-Plus大模型进行了全面体验测试,重点评估其多模态理解与综合能力。测试表明,该模型在OCR识别、基础逻辑推理及中等复杂度代码生成(如五子棋、计算器)方面表现扎实,多模态感知与长上下文处理能力达到宣称的高水平。然而,在高复杂度前端工程实现、高审美要求的UI设计生成以及嵌套较深的逻辑陷阱识别上,模型仍存在明显不足,显示出其当前的能力边界。
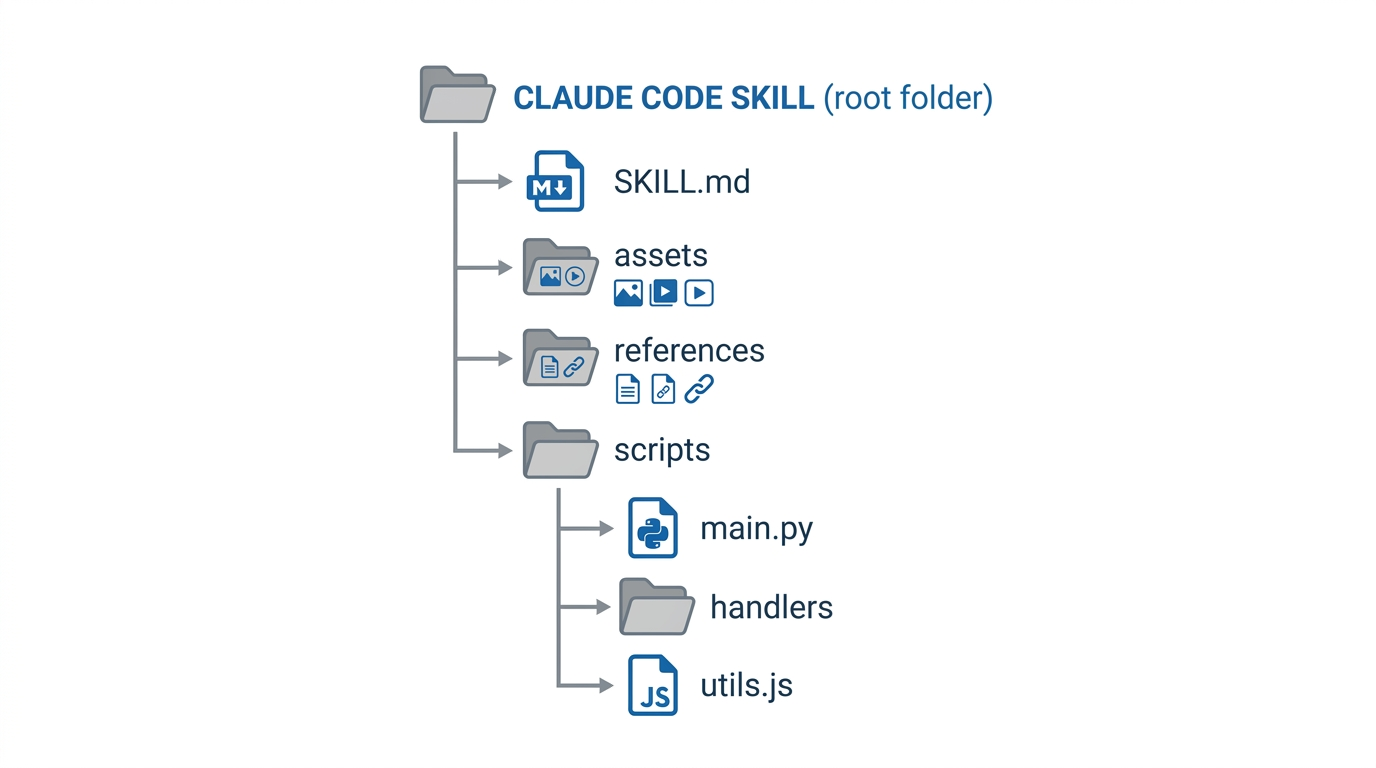
Anthropic 的 Skills 仓库已经在 GitHub 公开:其中包含什么、skill-creator 如何工作,以及这对 Claude Code 用户意味着什么。