谷歌Gemma 4 MoE实测
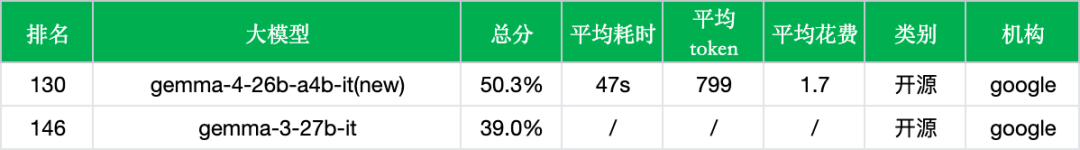
基于ReLE基准1.5万道中文测试,Gemma 4 26B MoE展现出极强的低延迟优势,响应较31B版快43%,Agent工具调用能力近乎翻倍。但短板是其中文复杂指令遵从提升微弱,50.3%的准确率远落后于头部开源竞品。业务选型建议:该模型高度契合算力受限、对延迟极敏感的边缘端在线交互场景,不适用于追求极限精准度的核心高阶任务。
Harness 会编码一些假设,而随着模型改进,这些假设会过时。Managed Agents 是我们面向长周期智能体工作的托管服务,它围绕一组接口构建,即使 harness 变化,这些接口也能保持稳定。
在一处汇总所有 Claude Code 斜杠命令,包括内置命令、隐藏命令,以及行为类似命令的所谓秘密提示词代码。2026 年更新,并为每项提供示例。
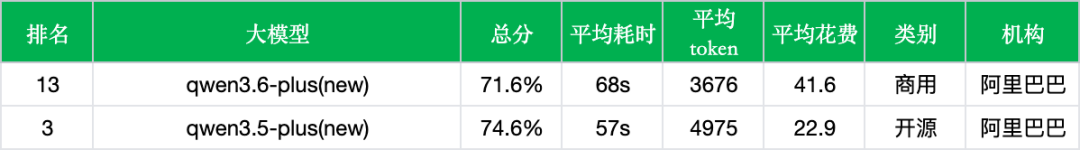
Qwen3.6-Plus作为阿里最新推出的旗舰API模型,在本次针对中文场景的综合能力评测中呈现出能力结构的显著变化。其整体准确率从前代的74.6%回调至71.6%,但在语言与指令遵从维度上获得了明显提升,表明模型对复杂中文指令的理解与执行能力增强。然而,这一提升并未抵消其在金融、推理数学及Agent工具调用等多个垂直领域的准确率下降。评测同时关注其性能表现,包括响应时间与成本结构的变动。
学习如何使用 Skills 系统在 Claude Code 中构建自定义斜杠命令。涵盖 SKILL.md 结构、命令与 Skill 模式、作用域、渐进式披露,以及可以立即复制使用的实际示例。
如果你一直在 Claude Code 中构建工作流,可能已经注意到创建斜杠命令有两种方式:Skills(.claude/skills/<name>/SKILL.md)和 Custom Commands(.claude/commands/<name>.md)。两者都会在斜杠菜单中创建 /name,也都接受 $ARGUMENTS。那么它们有何区别,又该在什么时候使用?
上下文工程是使用 AI 编程智能体时最重要的能力。本指南介绍如何组织项目上下文、CLAUDE.md 文件和任务描述,让 Claude Code 尽可能一次就写出高质量代码。
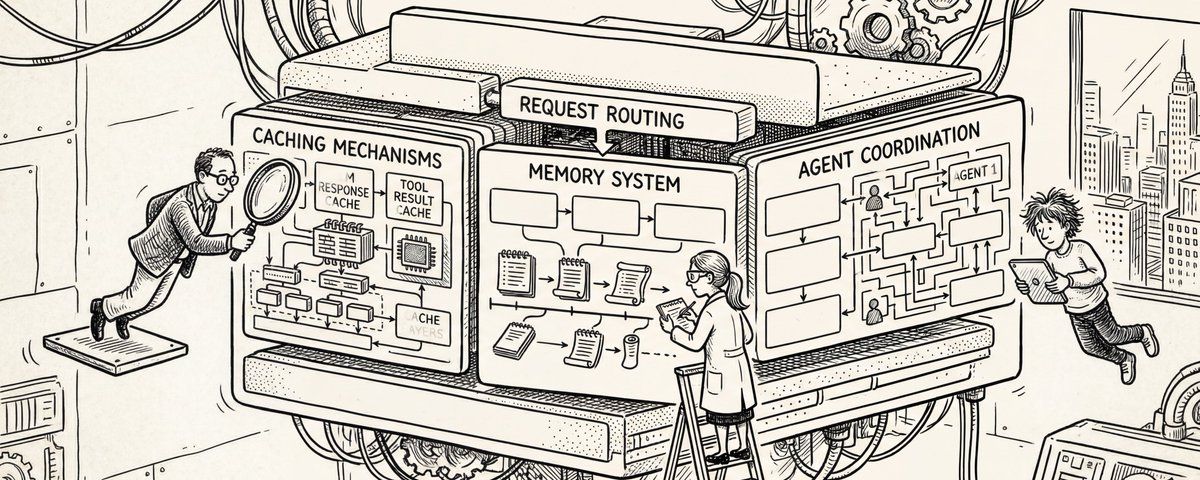
基于社区 Claude Code CLI 架构分析长文的安全版转写,只保留缓存、Compact、Skills、多 Agent、远程运行和安全分层等工程启发。
构建 Claude Code Skills,通过斜杠命令和结构化指令自动处理前端工作流、落实设计系统规则并搭建组件。
Claude Code v2.1.3 将 Custom Commands 合并进 Skills。.claude/commands/ 中的命令现在也被视为 Skills,由此引发了有关自动加载、上下文消耗和可控性的争论。
本文实测了小米MiMo-V2-Omni与OpenAI的gpt-5.4-mini及nano模型在表格识别任务中的表现。评测显示,MiMo-V2-Omni以58%的准确率位列中游,其短板主要在处理复杂表头和抗水印干扰上。gpt-5.4-mini表现次之,准确率为53%,在水印和表头边界识别上同样存在薄弱环节。而gpt-5.4-nano准确率仅11%,在各项错误类型上均全面崩溃。
Claude Code 用户会批准 93% 的权限提示。我们构建了分类器来自动化一部分决策,在降低审批疲劳的同时提升安全性。本文介绍它能捕捉什么,以及会漏掉什么。
在智能体式编码前沿,运行框架设计是影响表现的关键。下面介绍我们如何在前端设计和长时间运行的自主软件工程中进一步推动 Claude。
一份精选的 Claude Code Skills 与自定义斜杠命令清单,覆盖代码审查、Git 工作流、测试、文档和工具推荐。
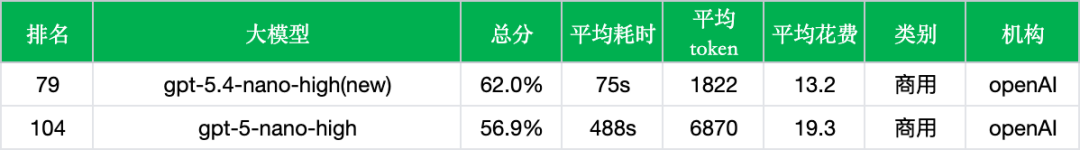
基于ReLE基准1.5万道中文测试,GPT-5.4-Nano响应提速85%,Agent调用能力显著增强,总成本下降32%。短板为中文复杂指令遵从能力下滑,同成本区间准确率明显落后于豆包等国产竞品。业务选型建议:不适用于追求中文性价比的核心任务,但高度契合多模型协作中需极速响应与高频调用的轻量级子智能体场景。
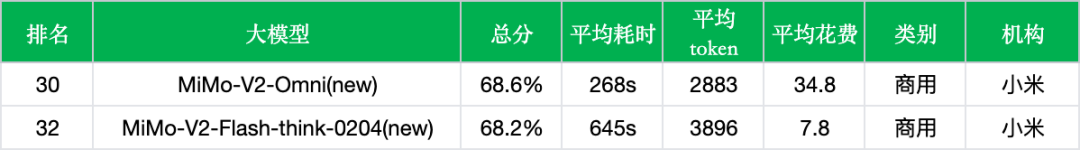
小米 MiMo-V2-Omni 是一款全模态基座模型,专注于感知与行动的统一,能够同时处理图像、视频、音频和文本输入。它将感知直接转化为行动,具备跨模态理解和 Agent 执行能力,如浏览器操作和端到端任务自动化。官方定位为面向智能体时代的全模态基座,本次实测侧重中文场景下的综合文本与逻辑能力,以检验其底层语言内核。评测显示,尽管架构复杂,但在准确率、响应时间等方面表现稳定
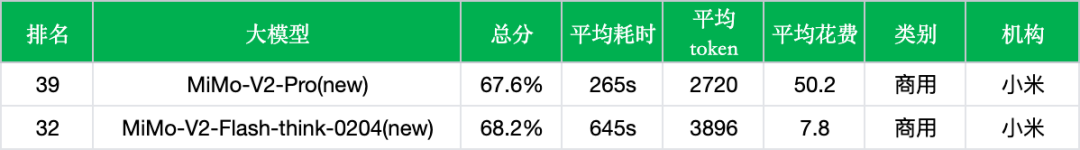
小米MiMo-V2-Pro的实测突出了其在Agent系统和专业领域中的应用场景。作为专为Agent设计的旗舰模型,它在编程和工具调用方面具备优势,适用于复杂工作流编排。评测显示在中文场景下,金融领域从76.2%提升至80.1%,医疗与心理健康从79.2%提升至80.5%,表明其在专业知识密集型应用中的潜力。尽管法律与行政公务领域有所回调,但整体为高效Agent系统提供了可靠基础。
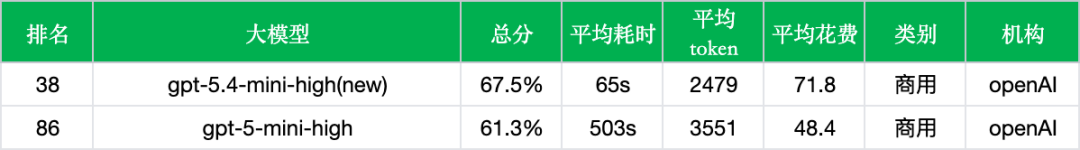
OpenAI GPT-5.4 Mini 的实测数据表明其性能在多个维度发生显著变化。准确率从61.3%提升至67.5%,排名从第86位升至第38位;响应速度大幅提升,平均耗时从503秒降至65秒,提速约87%。平均token消耗从3551降至2479,但输出价格上涨导致每千次调用费用从48.4元增至71.8元,成本上涨48%。数据基于非线智能ReLE评测,反映了中文环境下的实际运行指标。
本次实测评估了当前主流大模型在表格识别任务上的实际表现,其核心能力体现在从复杂图像中准确还原表格结构与数据的精度。评测覆盖了政务、财务、资讯等多种真实业务场景下的表格图片,通过严格比对原图与模型输出,统计了各模型的准确率。结果显示,整体表现最佳的模型准确率也仅为66%,大部分模型集中在56%至63%区间,表明表格识别仍是多模态能力的一个技术难点。