OpenAI GPT-5.5实测
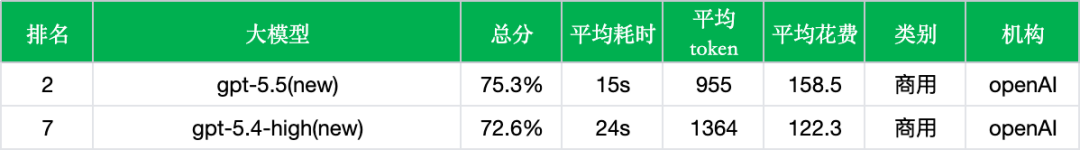
OpenAI GPT-5.5实测深入评估了模型在智能体编程、计算机操作、知识工作和科研任务等核心能力上的强化。测试显示,新版本在推理与数学计算领域准确率从78.2%提升至83.7%,agent与工具调用能力从60.3%升至65.0%,整体准确率达到75.3%,较GPT-5.4-high的72.6%有显著改进。响应速度平均耗时从24秒缩短至15秒,token消耗下降约30%,印证了官方用更少指导完成
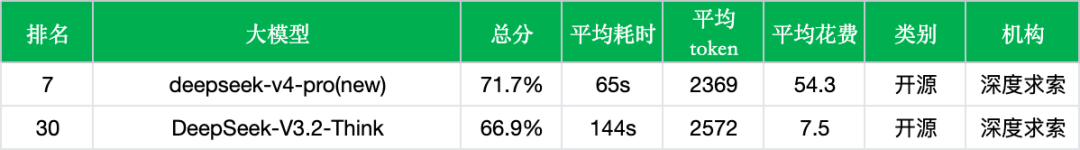
本文客观评测了深度求索新开源的DeepSeek-V4系列模型。旗舰版V4-Pro基于混合稀疏注意力架构,大幅降低了长上下文的推理成本。评测显示其综合准确率达71.7%,在代码与智能体能力上跃升显著,稳居开源顶尖水平。虽然调用单价上涨,但其单次响应提速且资源消耗降低。结合全新的量化训练等技术,该模型成功缩小了与前沿闭源大模型的差距,综合竞争力突出。
企业部署 Claude Code 前,需要先确定方案、部署基础和治理机制。本文进一步给出一套从 PoC 到全公司推广的六阶段实施路线。
Marmelab 团队连续数月每天使用 Claude Code 后整理的最佳实践速查表,并附有精选的实质性社区评论。
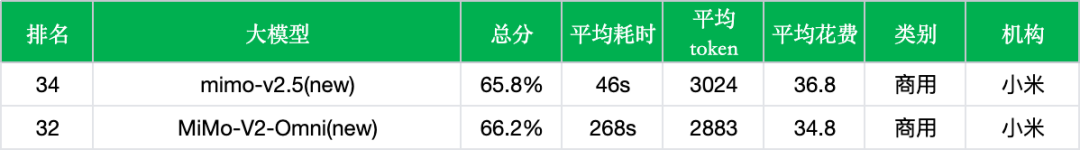
本次实测针对小米MiMo-V2.5模型在中文文本场景下的综合能力进行了全面评估。模型在编码能力上实现显著提升(+8.8%),金融与医疗知识也有所增强,但教育与推理数学能力出现不同程度回调。整体准确率(65.8%)与上一代全模态模型基本持平,表明其能力结构在通用文本领域进行了针对性调整,重点强化了编程等特定任务,同时保持了法律、医疗等垂直领域的稳定表现。
基于社区对 Cat Wu 访谈的结构化整理,讨论 Claude Code 产品团队的 AI PM 角色、快速发布机制、产品边界和多 Agent 协作趋势。
Marmelab 团队连续数月每天使用 Claude Code 后总结出的工作流、最佳实践和常见陷阱。
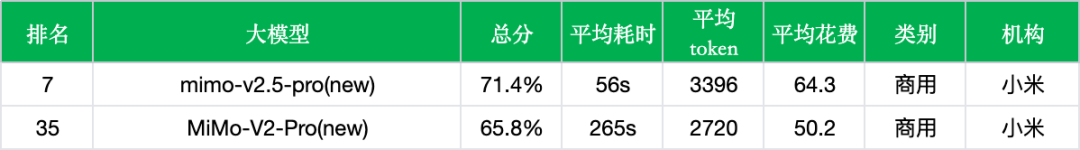
小米 MiMo-V2.5-Pro 是小米推出的最新AI模型,实测显示其在推理、编码和工具调用等核心能力上实现显著提升。模型在推理与数学计算维度提升幅度最大,从71.9%增至83.5%,编码能力也从56.0%提升至62.9%。响应时间大幅缩短,从265秒降至56秒,表明工程优化效果明显。整体准确率从65.8%提升至71.4%,进入头部梯队,但Agent工具调用提升有限,医疗和语言维度基本持平。
我们将近期关于 Claude Code 质量问题的报告追溯到三个彼此独立的变更。本文说明发生了什么,以及我们将如何改进。
Claude Code 的 100 万 Token 上下文窗口听起来像是一次升级,但在实践中,把窗口限制在 20 万 Token 并提前压缩上下文,反而能获得更好的结果和更低的成本。
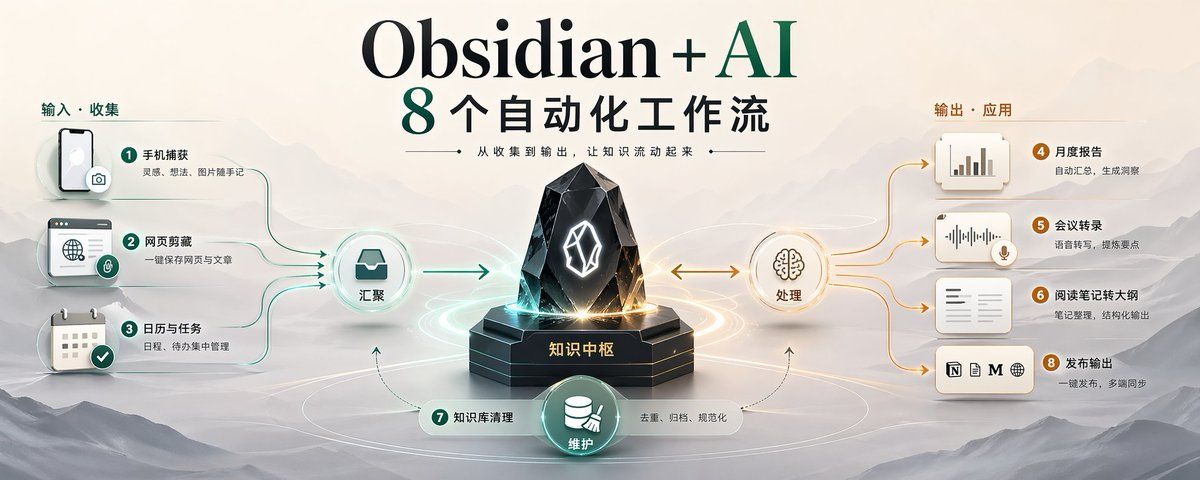
基于社区 Obsidian AI 工作流长文转写,整理如何把 Markdown 知识库、模板、历史记录和 Claude Code 串成可迁移的个人工作流系统。
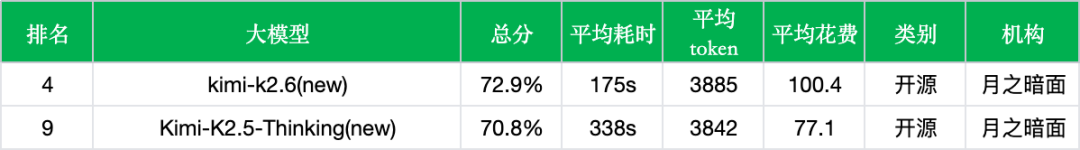
月之暗面Kimi K2.6实测针对中文场景下的综合能力进行了考察,评测框架加入了coding维度。结果显示,模型在交互式场景中的等待体验改善,响应时间大幅缩短;成本方面,每千次调用花费100.41元,较上代上涨30.2%,但准确率提升2.1%。官方强调的长程执行和Agent集群能力在当前评测中未充分展开,适用于需要代码生成和长程任务的场景,读者可参考文末官方数据评估适用性。
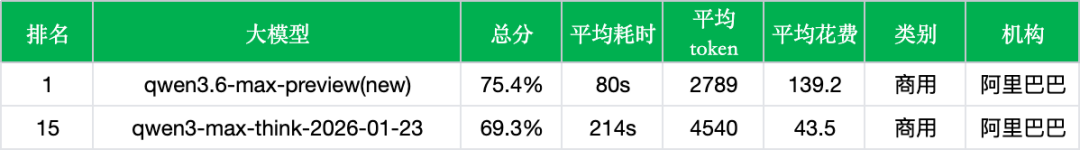
阿里Qwen3.6-Max-Preview的实测数据显示准确率从69.3%提升至75.4%,排名升至总榜第一,编码维度提升24.1%,教育领域增强8.8%,同时成本涨幅约220%,输出价格从10元/M token升至54元/M token,每千次调用花费139.2元,在高端成本区间内表现领先于同类竞品。
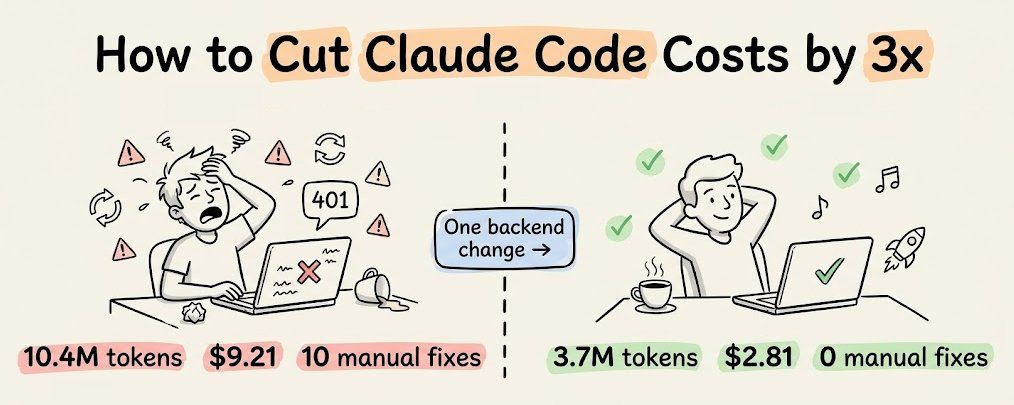
基于社区 Claude Code 成本分析长文转写,讨论后端工具、MCP、CLI 和 Skills 如何影响智能体的 token 消耗与排障效率。
到了 2026 年,模型能力已经显著提升,如何组织上下文比如何斟酌提示词措辞更重要。本文系统介绍 CLAUDE.md 架构、技能拆分、作为上下文提供方的 MCP,以及能够持续改善输出质量的实践模式。
如何为 Anthropic 原生终端编程智能体 Claude Code 编写提示词,涵盖 CLAUDE.md 文件、斜杠命令、Hooks、MCP 服务器,以及范围明确的工作单式提示词。
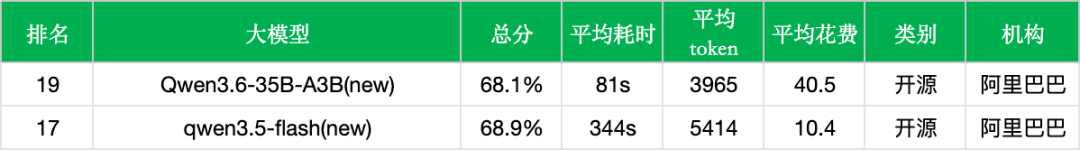
Qwen3.6-35B-A3B的实测数据显示了多项性能指标的显著变化。在约1.5万题的中文场景测试中,新版本总准确率为68.1%,响应时间大幅优化至81秒,但单次调用成本增至40.5元。具体维度上,医疗法律类任务准确率上升超过2个百分点,而金融与数学推理任务则下降约4至5个百分点。首次评测的编码能力得分为56.6%,低于前代模型。
大模型表格识别能力实测显示,新一代模型如Qwen3.6-Plus和GLM-5V-Turbo在表格识别上不一定比前代更强。Qwen3.6-Plus虽编程能力突出,但表格识别准确率从66%降至60%,主要短板包括内容识别错误和结构错乱;GLM-5V-Turbo视觉编程领先,但表格识别仅53%,水印处理和表头还原问题明显。两者表现反映模型迭代中能力发展不均衡,编程优化可能挤占其他训练资源。
一份社区整理的 Claude Code 内置命令、捆绑 Skills、自定义 Skill 系统清单,并收录讨论中的精选纠正意见。
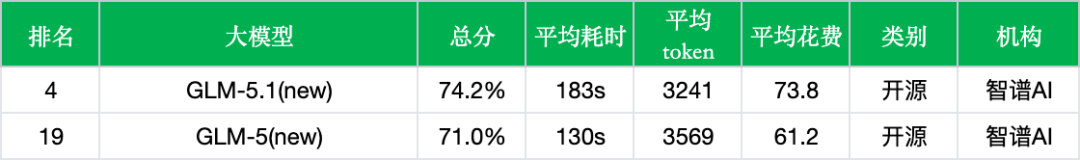
智谱GLM-5.1实测显示其在代码工程和长程Agent任务方面有显著能力提升,该模型在SWE-Bench Pro等基准上取得开源模型第一的成绩,能独立工作超过8小时。评测表明,其推理与数学计算能力提升9.2%,Agent与工具调用能力增强7.5%,突出了深度推理和任务执行的优势。然而,语言指令遵从略有下降,响应时间增加41%,但整体性能进入榜单头部。