2026 年最佳 Claude Code Skills 排名
按日常实用性评选 2026 年最佳 Claude Code Skills,涵盖代码审查、测试编写、并行批处理、调试、发布流程,以及 Nimbalyst 的一套可视化工具包。
深度
Claude Code
Karl Wirth
阅读 1267
2026-05-30
按日常实用性评选 2026 年最佳 Claude Code Skills,涵盖代码审查、测试编写、并行批处理、调试、发布流程,以及 Nimbalyst 的一套可视化工具包。
随着智能体能力增强,它们潜在的影响范围也在扩大。工程问题在于如何为这个范围设上限。以下是我们在为 claude.ai、Claude Code 和 Cowork 构建约束机制时学到的经验。
一场信息密度很高的 r/ClaudeCode 讨论,通过具体示例辨析项目指令、Skills、Hooks、Plugins、MCP 与子智能体。
Claude Code 的 /code-review 命令会扫描 Diff 中的正确性 Bug,支持不同推理强度,还能通过 --comment 将行内评论发布到 GitHub PR。
学习如何构建能够自我更新的 Claude Code 自定义命令,让它们在每次运行后积累经验,避免你与 Claude 合作时反复解释同样的事情。

当 Claude Code 覆盖整个工程组织后,真正发生了哪些变化。
Claude Code 可以生成代码,Clarista 则将安全扫描、SSO、审计日志和数据边界补充为生产部署层。
Claude Code 有四种扩展基础机制。本文比较 Skills、子智能体、Plugins 与 Hooks,解释每种机制的用途,提供真实配置示例,并给出选择决策树。
用通俗语言比较 Claude Code 的 Skills、MCP 服务器、子智能体与 Hooks,并通过决策树、代码和常见误区说明该在何时选择哪一种。
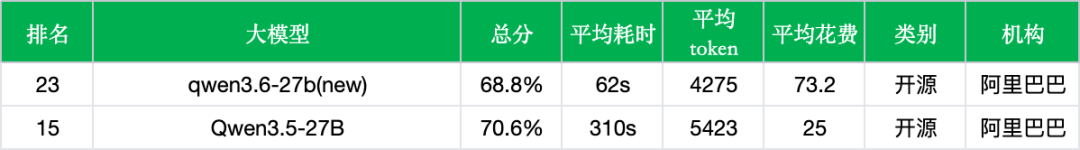
本文评测了阿里开源的Qwen3.6-27B模型。该模型聚焦智能体编程,中文评测呈现明显的“取舍”特征:总分微降至68.8%,推理等通用能力回调;但编程能力大幅提升6.7%,响应时间缩短80%。多维横向对比表明,该模型牺牲部分通用表现,换取了顶尖的代码水平,且凭借开源属性具备极高的本地部署价值。
本次大模型中文OCR能力评测基于真实业务场景数据,覆盖票据、手写、繁体字及竖排文本等七类典型任务。评测采用规则匹配与LLM裁判结合的双重判分机制,以确保结果客观。总榜显示,月之暗面的Kimi K2.6以69.8%的综合准确率位居第一,领先第二名Qwen3.6-plus近3个百分点。在排名前十的模型中,国产模型占据八席,表现出明显的群体优势。
本文对 GPT-5.5、Kimi、通义千问等多款大模型的表格识别能力进行实测,重点评估它们在复杂结构和水印干扰下的表现,发现模型普遍存在准确率下降和识别错误问题。实测中,GPT-5.5 因水印导致数字识别偏差和结构错乱;通义千问在水印下输出内容空白或错误;Kimi 则出现“致盲”现象,识别准确率受影响。这些结果反映了多模态大模型在视觉理解任务中的能力局限。